運営自律性の獲得を目指して ~毎日数万商品を更新するデータパイプラインを、新旧の結果を完全一致させてリプレイスする~
はじめに
株式会社10X でソフトウェアエンジニアをしている佐々木(@omuomugin)です。
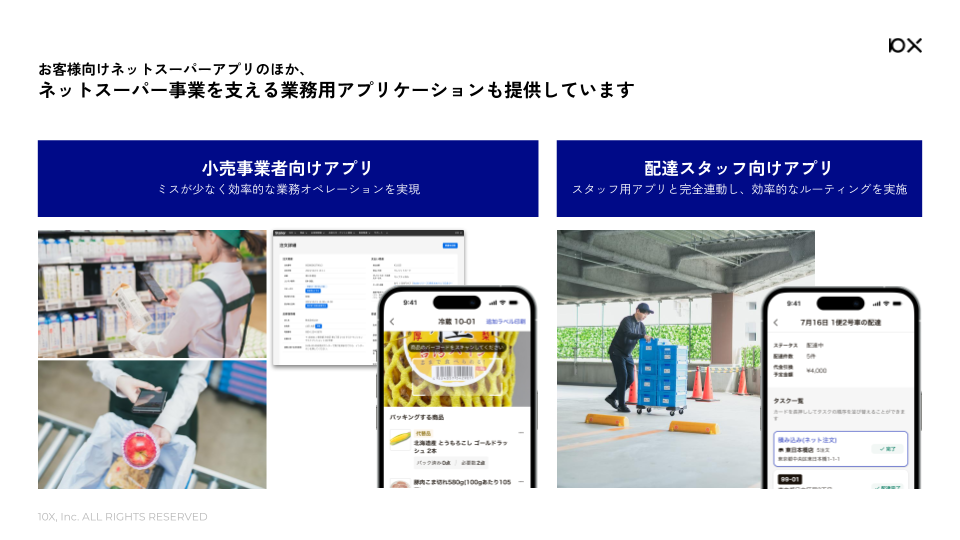
10X は「小売業の未来を拓く」をミッションに、ネットスーパーの運営に必要な機能を一通り揃えたプラットフォーム「Stailer ネットスーパー」を提供し、さまざまな業態・規模・地域のネットスーパー事業を支えています。お客様向けのネットスーパーアプリに加えて、店舗スタッフ向けの業務オペレーションアプリや、配達スタッフ向けのアプリも提供しています。
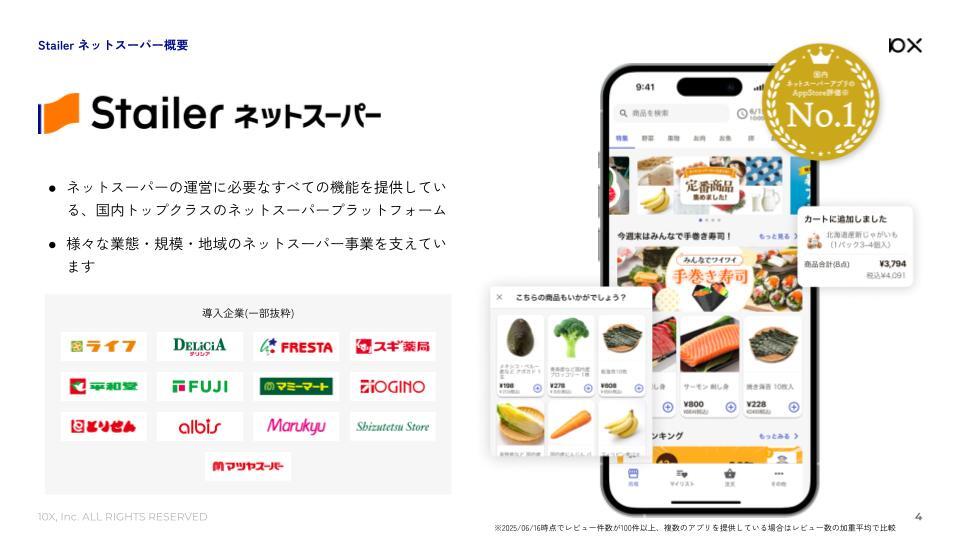
※ 導入企業は 2026/11 時点での情報となります。
Stailer では、担当する領域(ドメイン)ごとにチームを組成しています。
私が所属する「売場チーム」は、担当領域のひとつとして、「パートナー(小売企業)から商品データを受け取り、売場に掲載する」仕組みを担っています。チーム内ではこの一連のシステムを「商品データパイプライン」と呼んでいます。
本記事では、この商品データパイプラインを dbt(SQL)+ Dart(Worker)の構成から、Rust + マネージドなパイプライン実行基盤の構成へリプレイスした事例を紹介します。具体的には次の 3 点について紹介していきます。
- なぜリプレイスが必要だったのか
- 技術的な意思決定
- 安全な切り替えのための工夫
なぜリプレイスが必要だったのか
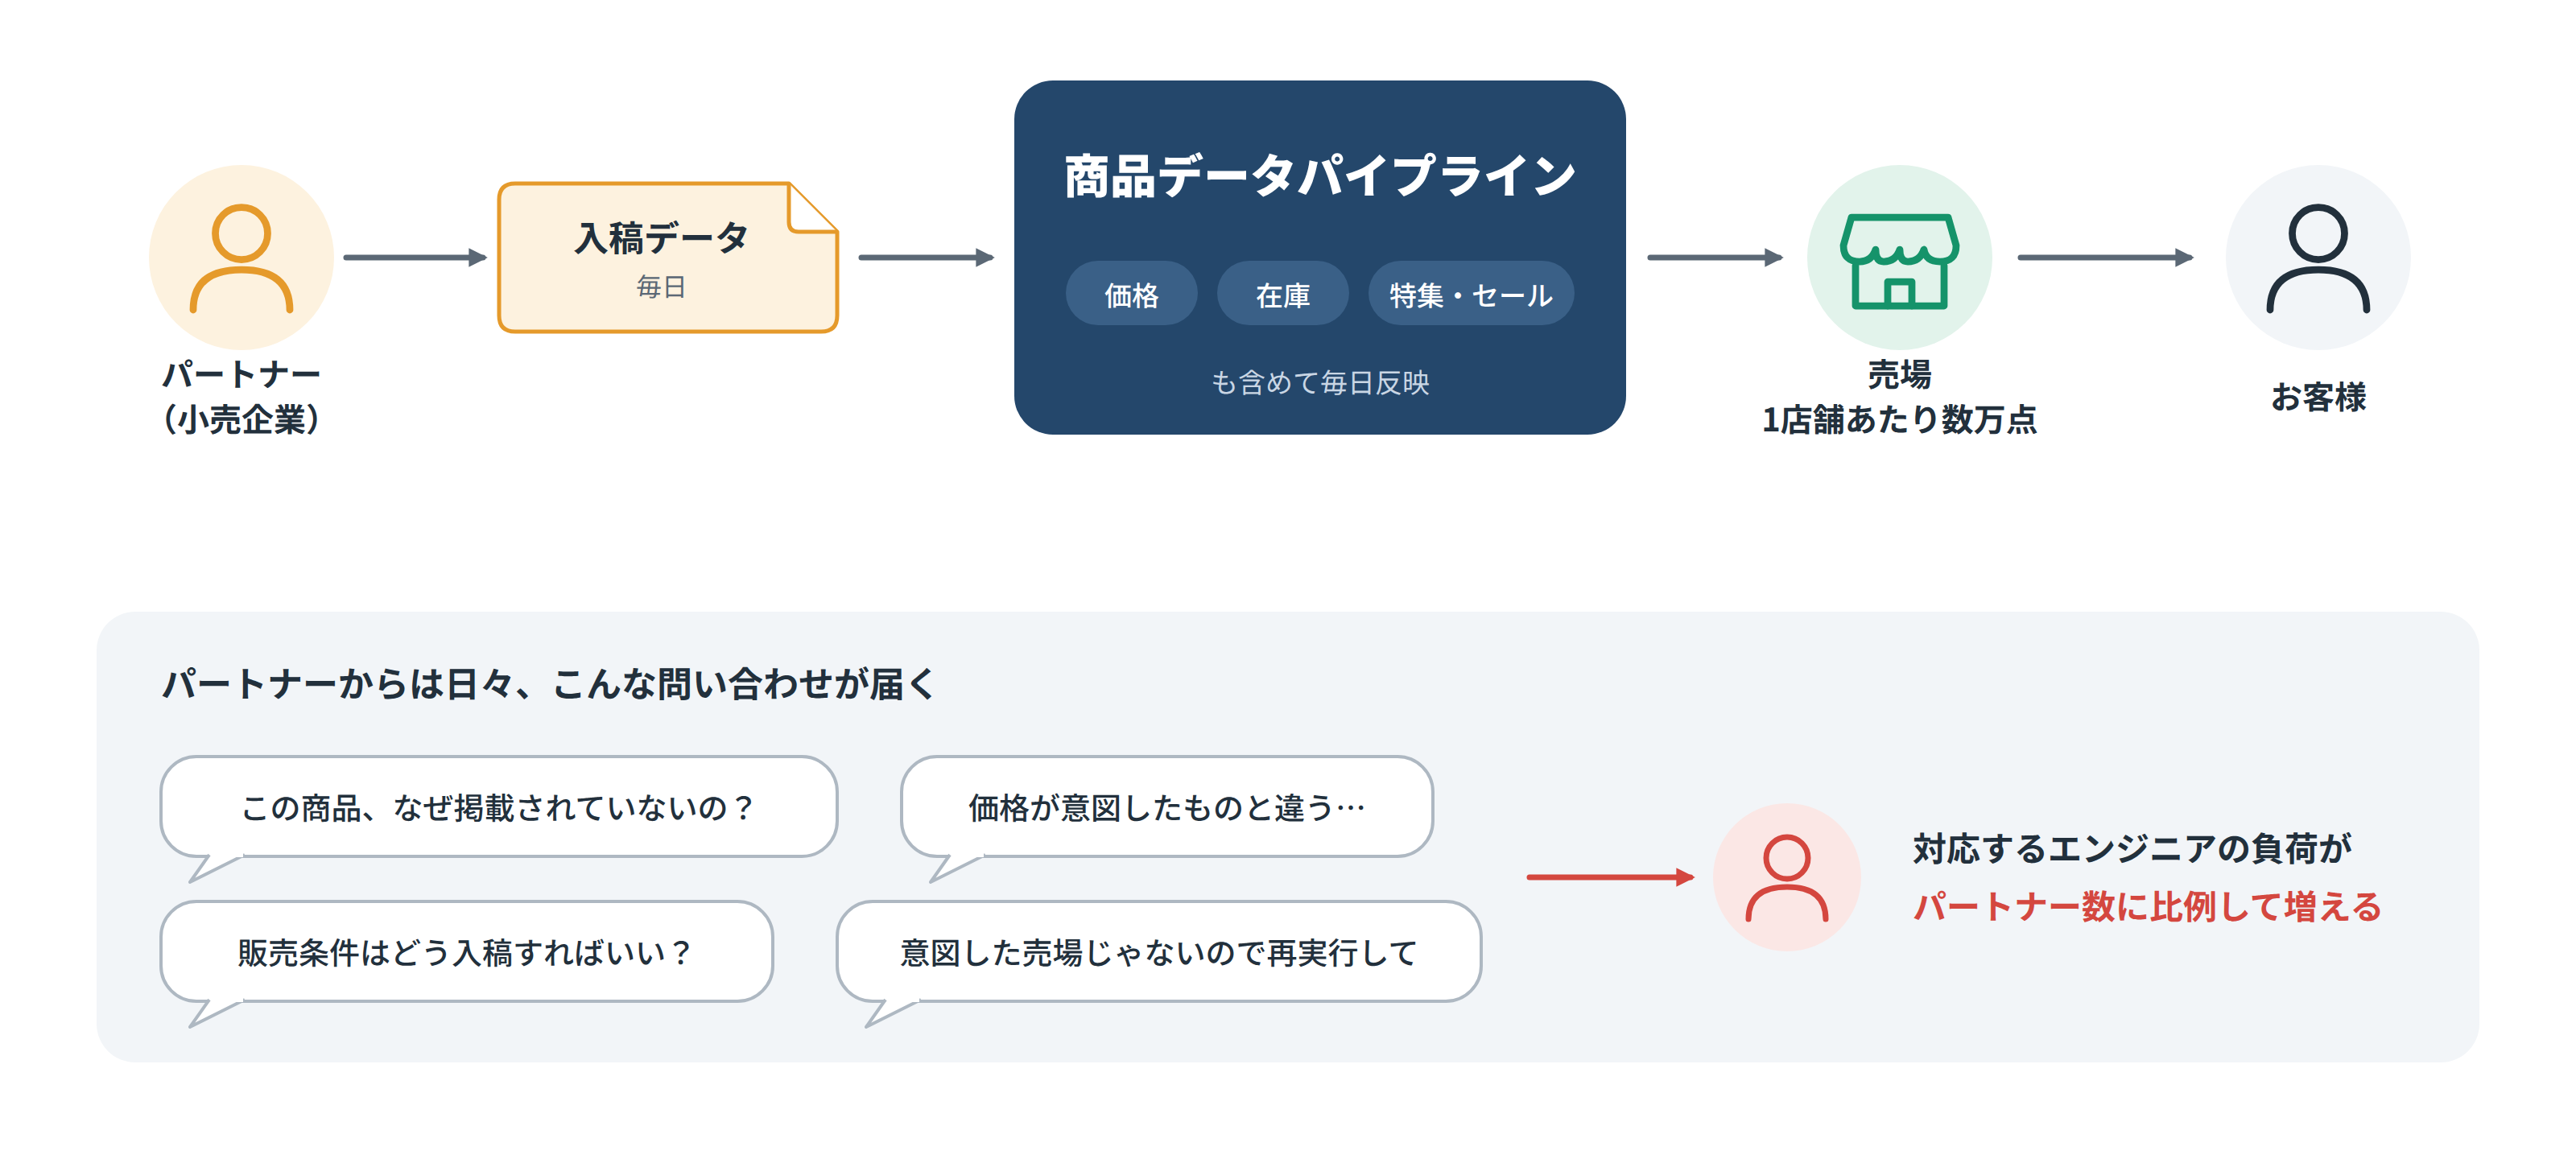
商品データパイプラインは、パートナーから日次で受け取った入稿データをもとに、商品を売場に掲載するシステムです。パートナーや店舗によって異なりますが、1 店舗あたり数万点の商品を毎日更新しています。
商品情報は、ただ単純に掲載すれば良いだけではありません。価格や在庫は日々変わりますし、特集やセールといった販促施策などについても適切なデータ変換をし、反映する必要があります。
この仕組みを多数のパートナーに提供するなかで、処理ロジックの複雑さもあいまって、次のような
問い合わせや依頼を日々いただくようになりました。
- 特定の商品が掲載されていないのはなぜか?
- 特定の商品の価格が意図したものと異なるのはなぜか?
- 商品の販売条件を設定するには、どのような入稿データを作ればよいか?
- 意図した売場になっていなかったので、再実行してほしい
- etc…
問い合わせ対応に加えて、不具合の調査や、パートナーごとの実行状況のモニタリングも必要です。
いずれもパートナーの数に比例して負荷が増え、運用に必要なエンジニアのリソースが膨らみ続ける状況でした。
またパートナーにとっても、日々忙しい中で問い合わせる必要があり業務負担が増える形になっていました。両者にとって、ぜひ解決したい課題でした。
目指したのは「運営自律性の高い」商品データパイプライン
社内では、こうした状況に対して「運営自律性を高める」という言葉を日常的に使います。
運営自律性とは 「ネットスーパーの運営を小売企業だけで完結できる機能が揃っているか」を表す言葉です。エンジニアの運用目線では「エンジニアの負荷を増やさずに運営できる状態になっているか」とも言い換えられ> ます。10X のエンジニアは特にこの点への意識が強く、たとえば次のような観点を日々気にかけています。
- 必要以上にエンジニアの対応が必要な機能になっていないか
- 複雑な調査を必要とし、自分たちの首を絞めていないか
- そもそもパートナーだけで調査や修正を完結する方法にはできないか
- etc…
問い合わせが増え続けるなかで、私たちは商品データパイプラインにおける運営自律性を次のように定義し直しました。
パートナー自身が、データの結果を確認でき、何を修正すべきかを理解でき、修正できること
この状態に近づけるために、システムをリプレイスすることにしました。
リプレイス前のアーキテクチャ
本題に入る前に、まずはリプレイス前のアーキテクチャを紹介します。
Stailer は開発当初からフル Dart で開発しており、データベースにはドキュメント型データベースのFirestore を採用しています。
データ処理を担う性質上、これに加えて dbt(SQL)も利用していました。
処理の流れは次のとおりです。
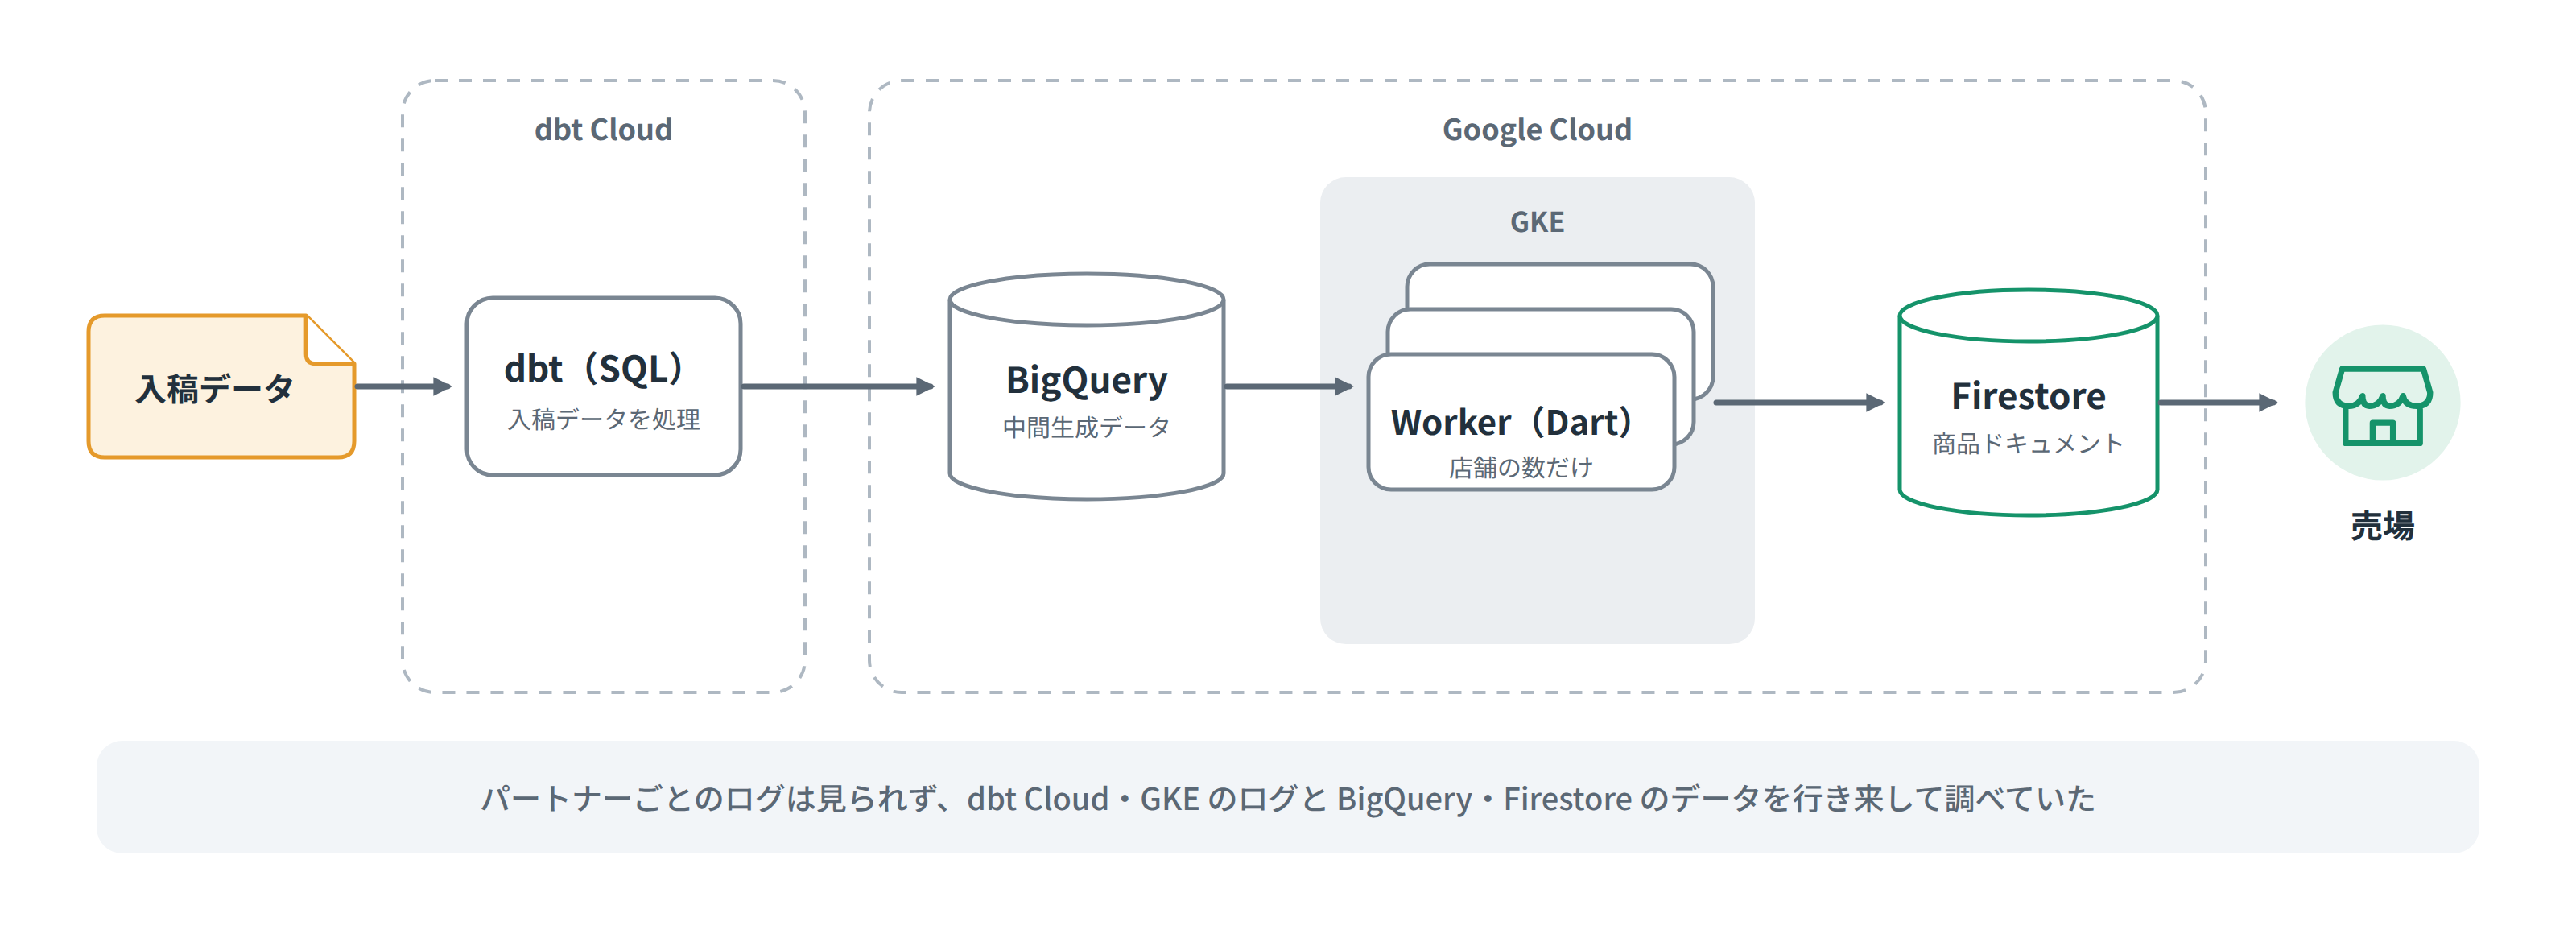
- dbt(SQL)が入稿データを処理し、BigQuery に中間生成データを書き出す
- dbt の処理完了後、店舗の数だけ Worker 向けのジョブを投入する
- GKE 上の Dart で実装された Worker が、パートナーごと・店舗ごとに中間生成データを読み込み、Firestore の商品ドキュメントを更新して売場に反映する
パートナー自身で原因を調べ、修正できる仕組みが必要だった
では、リプレイス前の構成では、何が運営自律性を妨げていたのでしょうか。
問い合わせのたびにエンジニアが調査するのではなく、パートナー自身で原因を確認し、入稿データを修正できるようにしたい。しかし、既存の構成でこれを実現するには、次の 2 つの課題がありました。
- 何を修正すべきかを説明する情報が足りない: エラーの種類や原因を整理し、修正に役立つメッセージとして出力する必要がありました
- 処理結果をパートナー自身で確認する手段がない: 調査に必要な中間生成データは、社内利用を前提とした BigQuery にありました
まず、修正に役立つ情報を出力するために、dbt のモデルにエラー理由のカラムを追加する方法を検討しました。しかし、1行に複数のエラーが同時に起こることもあれば、複数のデータを組み合わせて初めてわかるエラーもあります。これらを漏れなく分類・集約しようとするとCASE式やJOINが増え、エラーの種類が増えるにつれて、網羅性を保ちながら保守し続けることが難しいと判断しました。
そこで、SQL を中心としたデータ処理を、1 つのアプリケーションとして実装し直すことにしました。さまざまなエラーをコードの中で明示的に扱い、原因や修正方法を伝える情報として出力できるようにするためです。
あわせて、その処理結果をパートナー向けの画面から確認できるようにするため、出力先もBigQueryから見直しました。エラー理由を含む処理結果も Firestore に保存する方針としました。
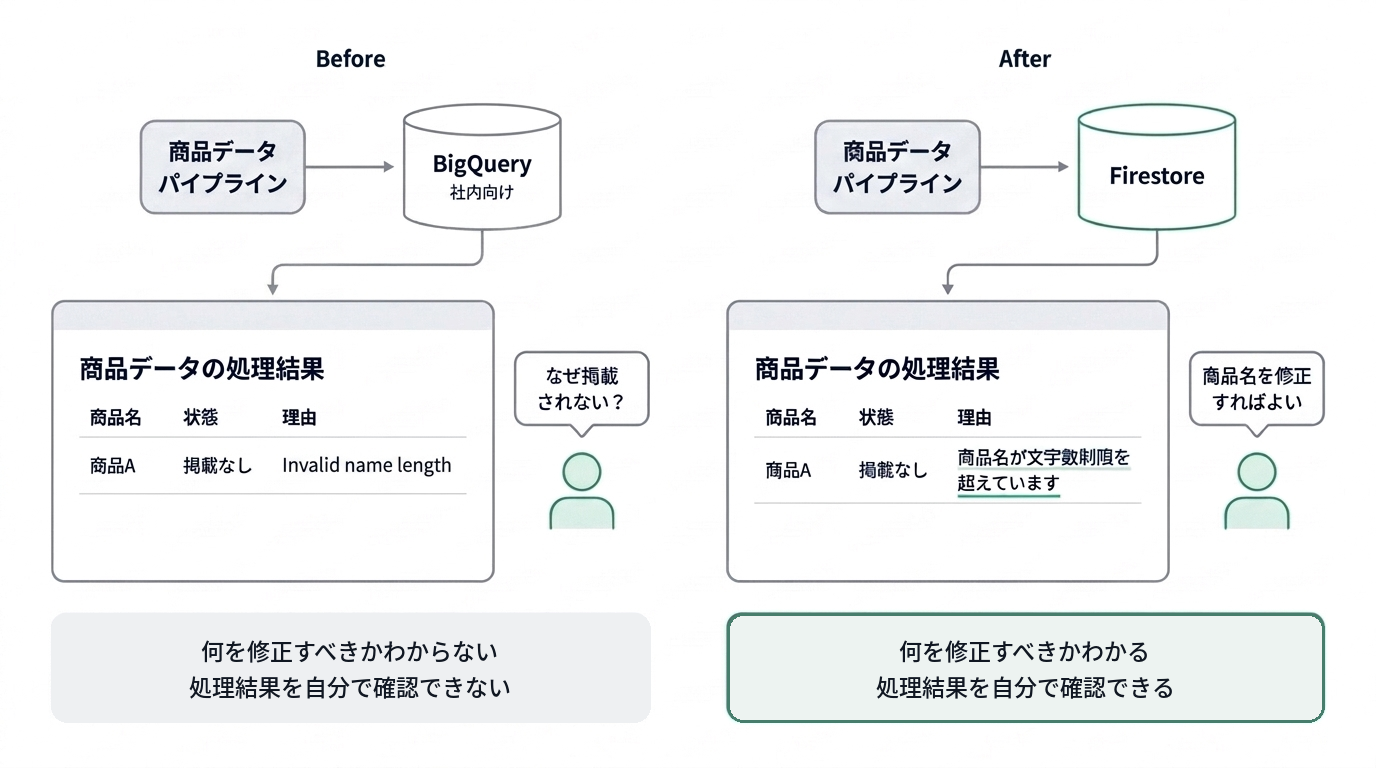
この 2 つの変更によって、パートナー自身が処理結果を確認し、何を修正すべきかを理解したうえで、入稿データを修正できる状態を目指しています。
技術的な意思決定
リプレイスにあたっては、データ処理をどう実装し、どの基盤で実行するかの2つに関して技術的な意思決定が必要でした。
エラーの扱い漏れを防ぐために Rust を選んだ
商品データパイプラインが扱うのは、パートナーが入稿する大量のデータです。これまで SQL が担っていた処理には、前述の通り単純なフォーマット違いから、文字数制限、複数のデータの組み合わせで初めてわかるエラーまで、さまざまな種類のエラーが含まれます。「どこを直せばよいか」をパートナーに適切に伝えるには、これらを取りこぼさないことはもちろん、種類ごとに分類・集約し、パートナーに伝わる形に変換するなど、エラーをコードの中で適切に取り回せることが重要でした。
Dart ではなく Rust を選んだ理由
最初に候補に上がったのは、社内で広く使われている Dart です。
Dart でも、sealed class と網羅的な switch を使えばエラーの種類を型で表現できます。ただしDartのエラー処理は例外が基本で、例外を捕捉しなくてもコンパイルは通るため、扱い漏れに気づけるのは実行時になってからです。Result 型を自作すればこれに近いことはもちろん実現できますが、標準ライブラリや外部パッケージは例外を前提としているため、境界ごとに変換するなどチーム全体で規約を守り続ける必要があります。
一方 Rust では、失敗しうる処理は Result を返すのが基本で、エラーのケースを扱わなければ成功時の値を取り出せません。扱い漏れはコンパイル時に検出されます。 そういった背景により、Rust を採用することにしました。
参考: フルスタックDartからRustバックエンドへ - 10X Product Blog
結果として、これまで扱いきれていなかった複雑な条件の組み合わせで生じるエラーも、扱い漏れをコンパイル時に検出しながら、それぞれに応じた処理を記述できるようになりました。
簡略化した例で紹介します。
まずエラーの種類を宣言し、それぞれ丁寧なメッセージを持たせます。
#[derive(Debug, thiserror::Error)]
pub enum ProductError {
        #[error("商品名が空です")]
        NameEmpty,
        #[error("商品名が{max}文字を超えています")]
        NameTooLong { max: usize },
        #[error("価格が0円です")]
        PriceZero,
}
入稿データの 1 行を変換するときは、すべて集めて返します。戻り値は Result なので、呼び出す側はエラーを扱わない限り結果を取り出せません。
fn from_row(row: InputRow) -> Result<Product, (String, Vec<ProductError>)> {
      let mut errors = Vec::new();

      match row.name.chars().count() {
              0 => errors.push(ProductError::NameEmpty),
              n if n > 100 => errors.push(ProductError::NameTooLong { max: 100 }),
              _ => {}
        }
        // 商品名が不正でも止めずに、価格も検証する
        if row.price == 0 {
            errors.push(ProductError::PriceZero);
        }

        if errors.is_empty() {
             Ok(Product { id: row.product_id, name: row.name, price: row.price })
        } else {
            Err((row.product_id, errors))
        }
}

// 入力(CSV の 1 行)と戻り値の例
//
// P001,りんご,198  → Ok(Product { id: "P001", name: "りんご", price: 198 })
// P003,,98→ Err(("P003", [NameEmpty]))
// P005,みかん,0→ Err(("P005", [PriceZero]))
// P006,,0→ Err(("P006", [NameEmpty, PriceZero]))
最後に、エラーごとにパートナーが直すべき列を対応づけることもできます。網羅的な match により エラーの種類を追加したときには、コンパイルエラーになります。
fn column_to_fix(e: &ProductError) -> &'static str {
      match e {
              ProductError::NameEmpty | ProductError::NameTooLong { .. } => "name",
              ProductError::PriceZero => "price",
      }
}

// パートナーへの表示例(商品ごとに、直すべき列と理由を示す)
// P003: name 列 / 商品名が空です
// P005: price 列 / 価格が0円です
// P006: name 列 / 商品名が空です
// P006: price 列 / 価格が0円です
副次的効果: エラー処理以外でも良い選択だった
当初はエラーの扱いだけを理由にした意思決定でしたが、振り返ってみると Rust を採用したことは
商品データパイプラインのリプレイスにとって非常に良い選択でした。
AI との相性が良かった
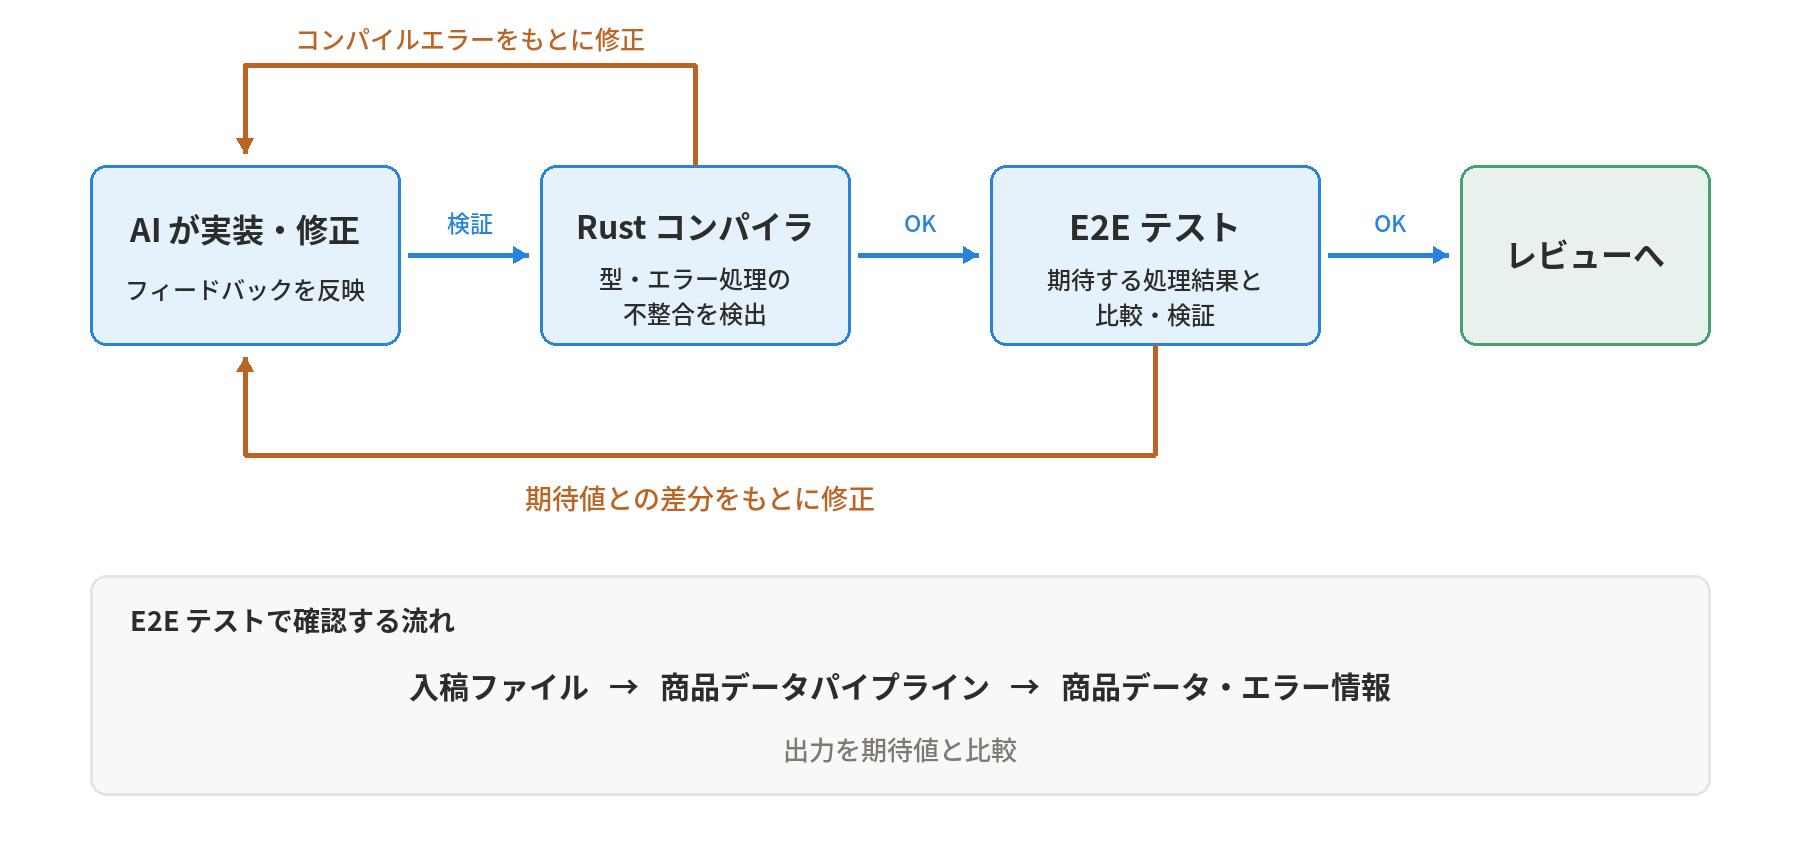
Rust の厳格な型チェックは、AI を使った実装でも役立ちました。AI がコンパイラのエラーメッセージ
をもとに修正を繰り返せるため、人間が介入する場面や手戻りが少なく、短期間で実装を進めること
ができました。
また、商品データパイプラインは、入力に対して期待する出力が比較的決定的です。E2E テストを整備したことも品質を保ちながら AI を活用して開発を進めるうえで役立ちました。
外部プロセスに頼らずに済んだ
元々 Dart では、大きな CSV ファイルの変換処理などで、効率性の観点で別途ツールをインストールし、外部プロセスとして呼び出していました。外部プロセスの失敗はエラーとして扱いにくい上にコンテナの依存が増えるなどの課題がありました。
Rust ではこれらを十分なパフォーマンスで処理している crate が豊富にあり、アプリケーション内で完結でき、失敗も Result として扱えるようになりました。しかもパフォーマンスチューニングを突き詰めていない段階でもリプレイス前と同程度の処理速度が維持できています。
残っている技術的な課題
一方で、課題も残っています。商品データパイプラインのみを Rust にリプレイスしたため、現在はDartとRustという別々に実装されたアプリケーションが、同じ Firestore に書き込んでいます。このままだとどちらかの実装が変更になった場合に気づけずに意図しない挙動となる恐れがあります。
社内ではさまざまな用途で Protocol Buffers を使用しているため、protobuf で定義したスキーマを介した書き込み、読み込みへの移行を進めています。
実行基盤に Gemini Enterprise Agent Platform Pipelines を採用した
続いて Rust で実装したアプリケーションの実行基盤についてです。
処理を 1 つのアプリケーションにまとめたことで、それを動かす実行基盤も改めて検討する必要がありました。リプレイス前は、dbt は dbt Cloud 上で、Dart 製の Worker は GKE 上で動いていました。
GKE 上でそのまま動かす選択肢もありました。しかし商品データパイプラインは、単純化しても以下のような DAG(有向非巡回グラフ)になっています。
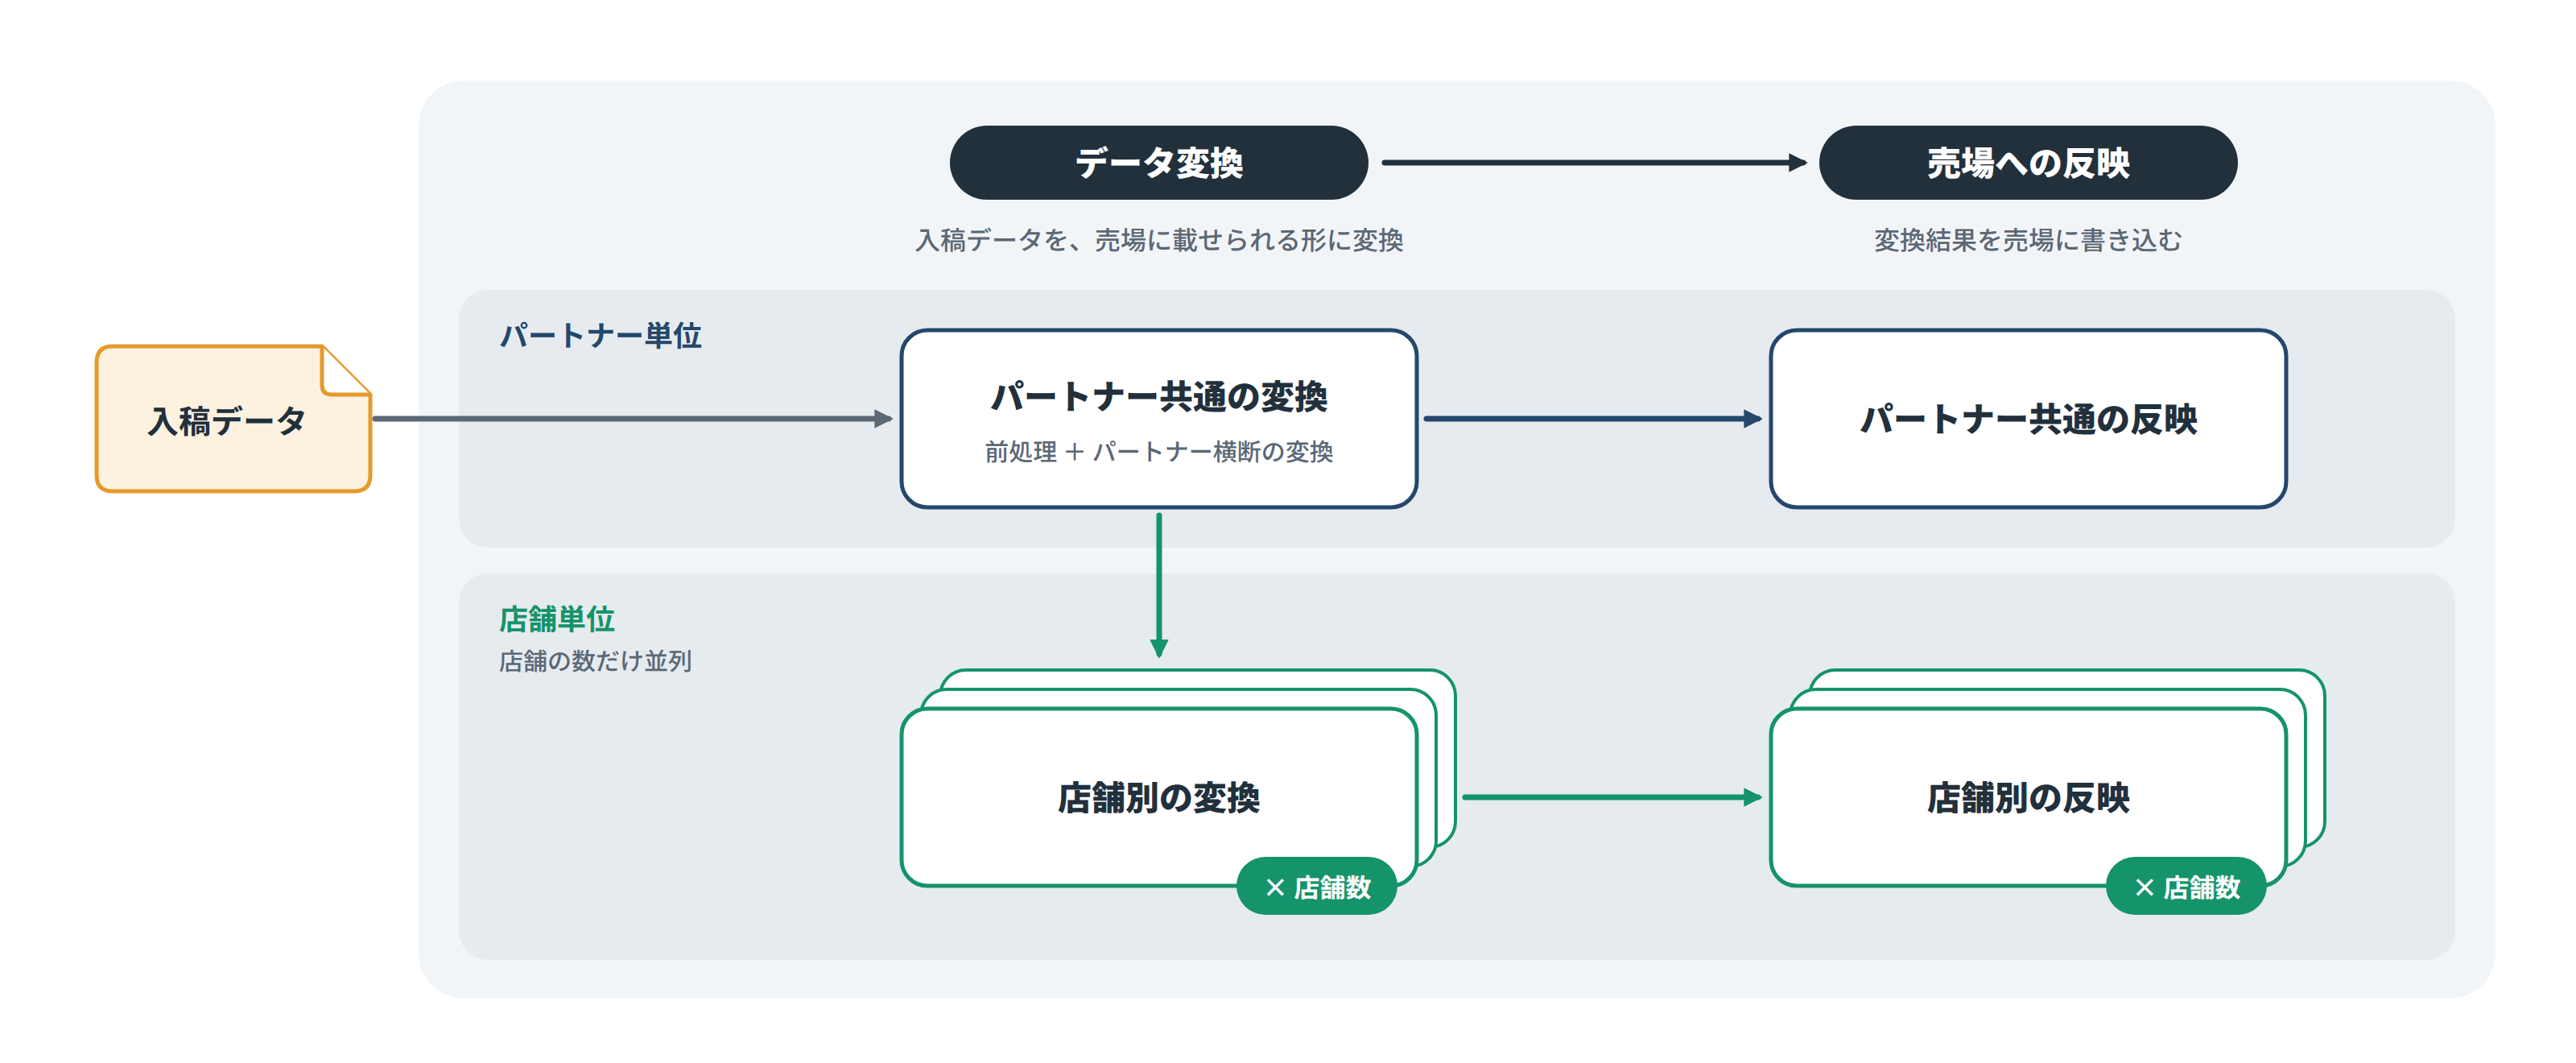
GKE で動かし続ける場合も、Worker の再設計やArgo Workflowsなどのワークフローエンジンの導入が必要でした。
また、リプレイス前は観測性にも課題がありました。処理がどこまで進んだのか、なぜ止まったのかやログの分析は、dbt Cloud と GKE、BigQuery と Firestore を行き来して追う必要がありました。さらに、リソース効率の観点から Worker をパートナー間で共有していたため、パートナーごとのログを
個別に見るにも工夫が必要でした。
最終的には、Gemini Enterprise Agent Platform Pipelinesを採用しました。旧称は Vertex AI Pipelines で、Kubeflow Pipelinesで定義したパイプラインをマネージドに実行できるGoogle Cloudのサービスです。
採用の決め手は、既存の GKE 環境に Argo Workflows などのワークフローエンジンを新たに導入・運用せずに簡単に始められ、前述の観測性の課題についても解消できる見込みがあったためです。
Gemini Enterprise Agent Platform Pipelines で実際に運用してみると、以下のスクリーンショットにあるように、パートナーごと・店舗ごとのログや結果を、実行単位で確認できるようになり観測性が大きく改善しました。
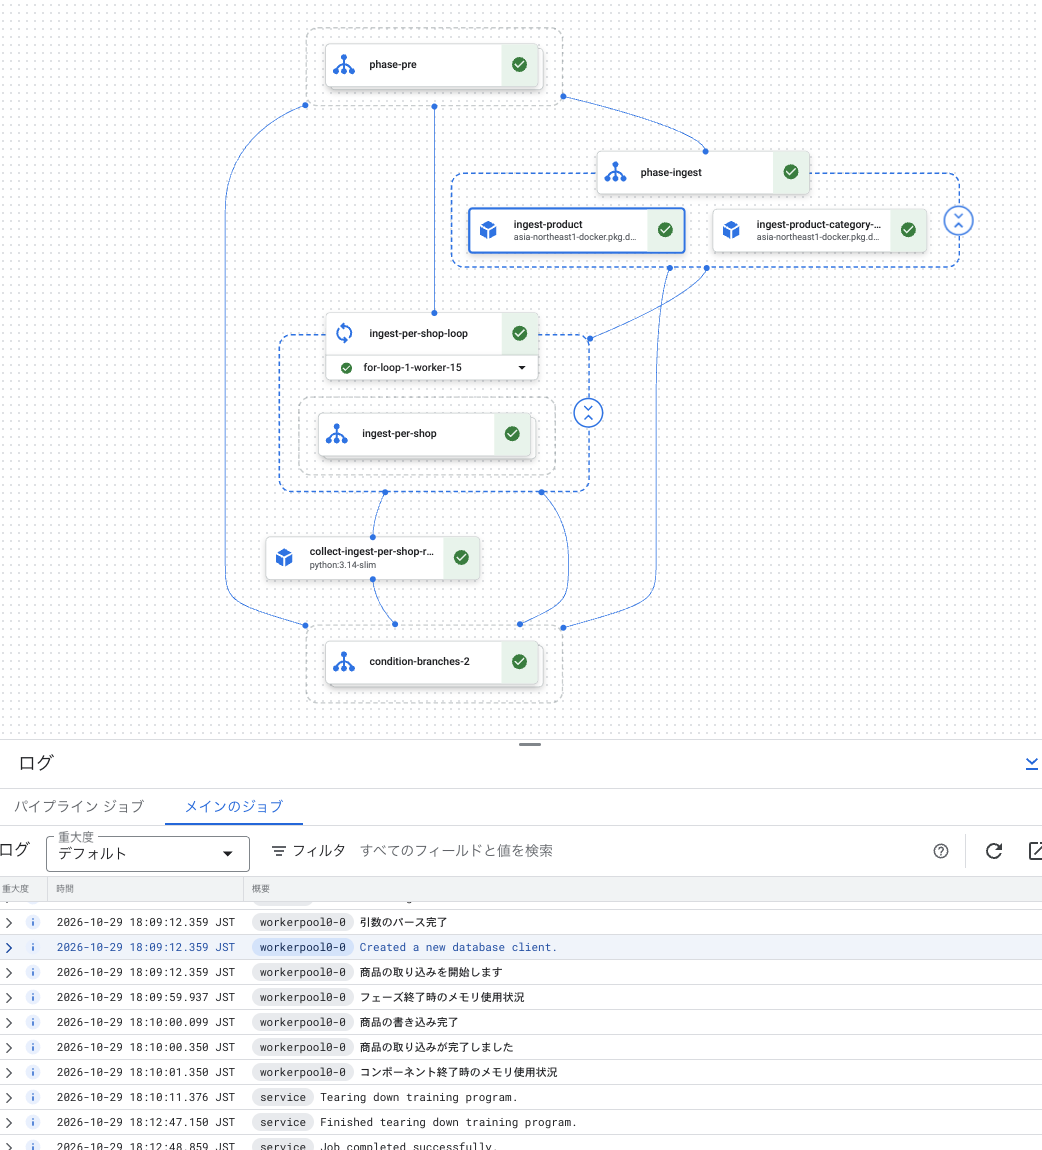
※ 特定のステップで発生したログだけを閲覧しているスクリーンショット
安全な切り替えのための工夫
システムのリプレイスでは、売場に掲載される商品データの掲載内容は変えずに、新しい商品データ
パイプラインへ移行することを大前提としました。暗黙的だった仕様や挙動が意図せず変わってしま
うと、パートナーの業務に大きな影響を与えるおそれもあるため、安全に切り替えるために次の 2 つ
の工夫をしました。
新旧の結果を突き合わせるシャドーテスト
パートナーから受領した同じデータを新旧それぞれのパイプラインで取り込み、別々のデータベースに書き込んだうえで結果を比較しました。完全一致を合格条件とし、差分が出れば原因を調べて新パイプラインを直す、というサイクルを回しました。
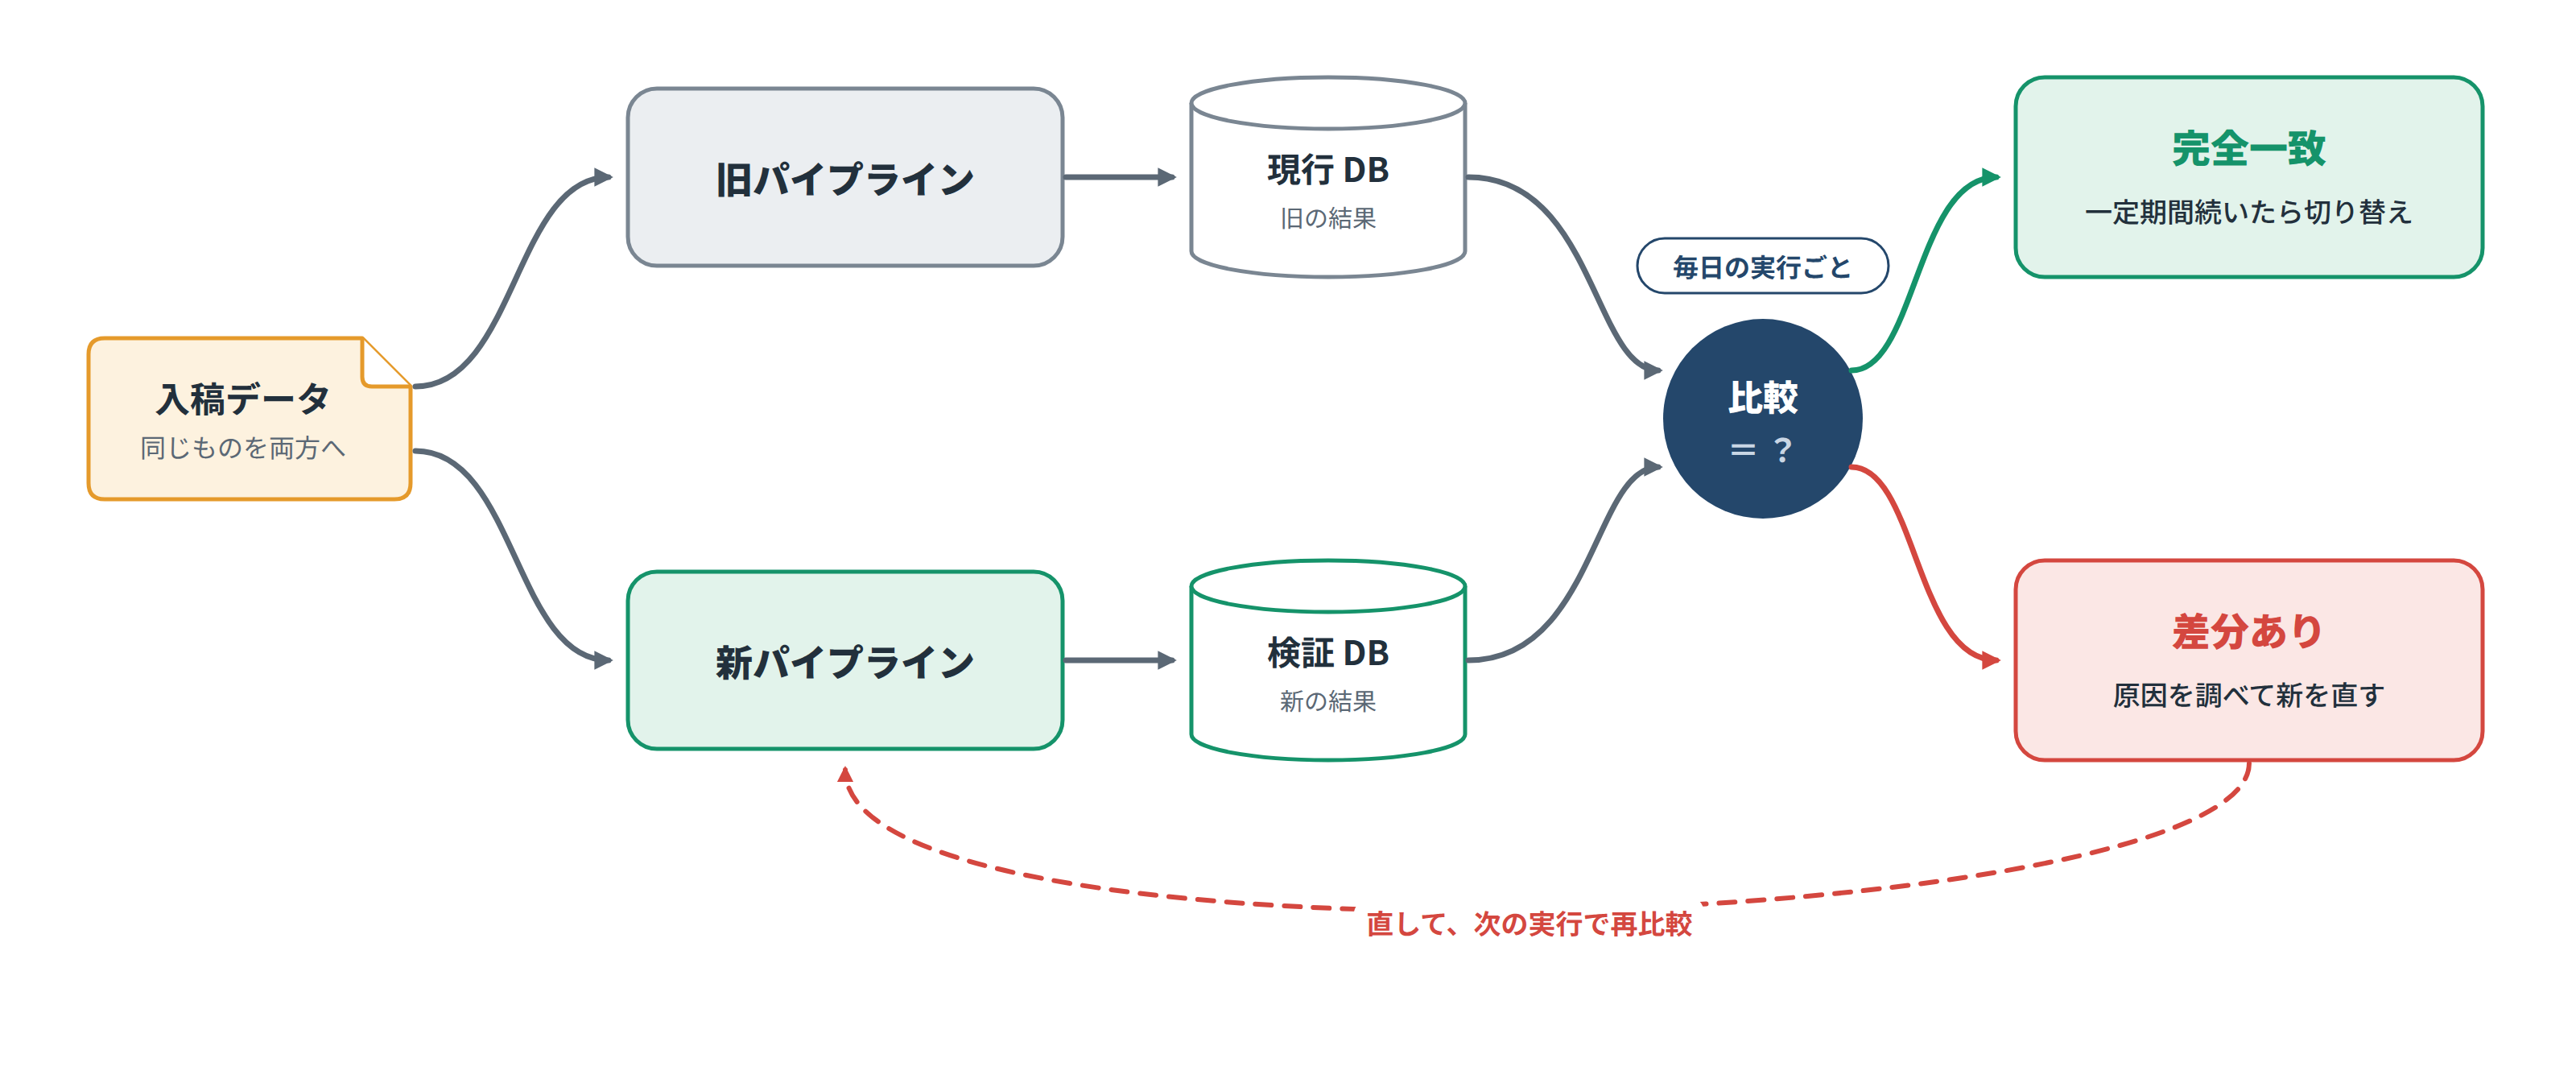
1 か月弱実施して、暗黙的な仕様がいくつか見つかり、切り替え前に修正できたことで、自信を持ってリプレイスを進めることができました。
大規模なパートナーから移行する
また移行するパートナー選定においても工夫をしています。移行は、あえて大規模なエンタープライズのパートナーから始めました。店舗数、商品数が多く、入稿内容に多様性のあるパートナーから始めることで、次の 2 つの効果がありました。
ユースケースを広くカバーできた
- 多様な入稿データに対して、早い段階でシャドーテストで検証できた
パフォーマンス課題を先に発見できた
- 特定のステップで多数の店舗が同時に書き込むと Firestore 上の競合が多発する問題が見つかり、切り替え前に修正できた
結果として、大規模パートナーの全店舗の切り替えを大きな不具合なく終えることができ、現在は新しい商品データパイプラインが、それらの店舗の商品掲載情報を毎日更新しています。
まとめと今後
本記事では、運営自律性の向上を目指し、商品データパイプラインをリプレイスした事例を紹介しました。
- 修正に役立つエラー情報を出力し、Firestore に保存することで、パートナー自身が原因を調べて修正するための土台を整えました
- Rust によってエラーの扱い漏れをコンパイル時に防ぎ、マネージドなパイプライン実行基盤によって実行状況やログの観測性を改善しました
- 新旧の結果を比較するシャドーテストと、大規模なパートナーから移行を開始することによって、仕様の差異やパフォーマンスの課題を切り替え前に検証しました
現時点で移行が完了しているのは一部のパートナーのみであり、今後は残るパートナーへの移行を 進めていきます。
ただし、リプレイス自体がゴールではありません。当初の目標は、パートナー自身が処理結果を確認し、何を修正すべきかを理解し、入稿データを修正できるようにすることです。
今回整えた土台をもとに、パートナーに対してわかりやすく結果やエラー内容を表示し、パートナー自身で修正まで完結できるところまで取り組んでいきたいです。
10Xでは一緒に働くメンバーを募集中です!
10Xでは未来をより良くする事業・組織のために、仲間を募集しています。
詳細はこちらをご覧ください。