


小さく始める ClickHouse。RDB と併用する集計アクセラレータ構成

参考になった
3

ファインディ株式会社 / hatachan
メンバー / バックエンドエンジニア / 従業員規模: 301名〜500名 / エンジニア組織: 51名〜100名
| 利用プラン | ツールの利用規模 | ツールの利用開始時期 | 事業形態 |
|---|---|---|---|
Scale | 10名以下 | 2026年2月 | B to B |
| 利用プラン | Scale |
|---|---|
| ツールの利用規模 | 10名以下 |
| ツールの利用開始時期 | 2026年2月 |
| 事業形態 | B to B |
アーキテクチャ
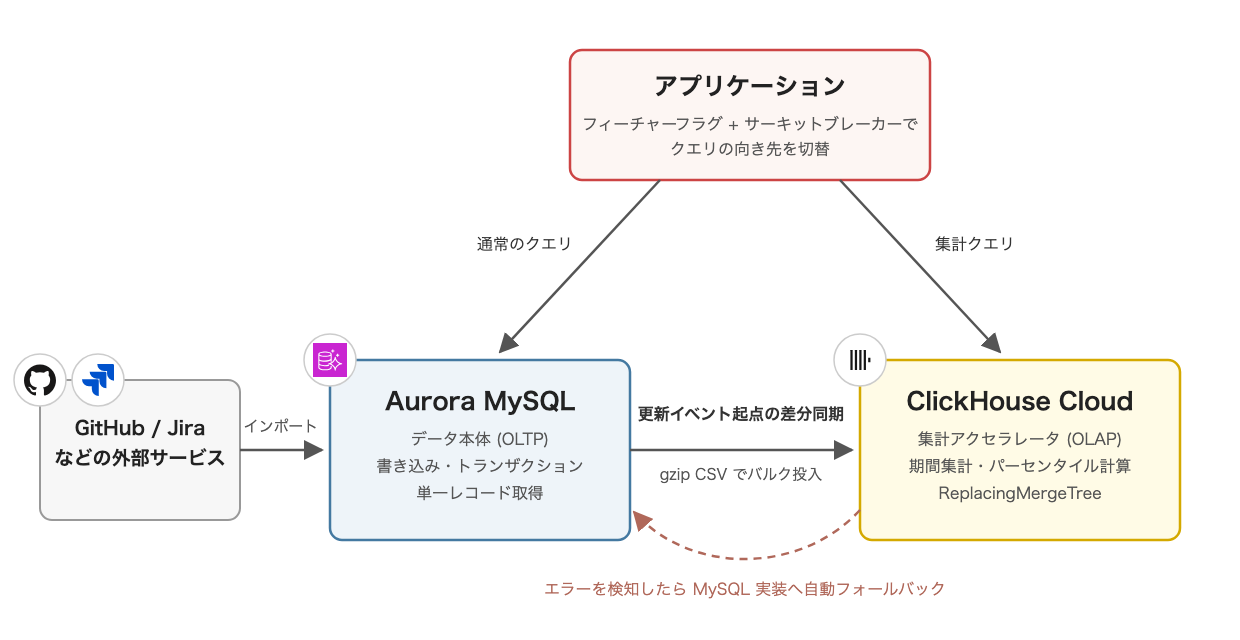
アーキテクチャの意図・工夫
データは従来どおり Aurora MySQL で管理し、ClickHouse は集計専用のアクセラレータとして併用するハイブリッド構成を採用しました。トランザクション処理や単一レコード取得は MySQL、期間集計やパーセンタイル計算は ClickHouse と、各エンジンの得意分野に寄せています。
データ本体を MySQL に残しているぶん、ClickHouse 側は小さく始められます。ClickHouse Cloud は、8GiB のレプリカ2台 (オートスケールを有効にしたときの最小構成) から、負荷に応じて垂直にオートスケールする設定で運用しています。この小さな構成のまま、画面からの集計クエリを通常は数十ミリ秒〜1秒程度で返せており、インフラ費用の増加を小さく抑えたまま集計だけを高速化できました。
MySQL → ClickHouse の同期は、更新イベントを起点にした差分同期です。ClickHouse が小さな書き込みを苦手とするため、レコードを1行ずつ INSERT するのではなく、gzip 圧縮した CSV にまとめてからバルク投入しています。
もう1つの工夫は、ClickHouse 化したすべての集計メソッドに MySQL 実装を残したことです。フィーチャーフラグで画面や組織の単位で少しずつ切り替えを進め、問題があればすぐ戻せるようにしました。
残した MySQL 実装は、エラー時の自動フォールバック先としても働きます。前述のとおり ClickHouse は小さな構成 + オートスケールで運用しているため、負荷スパイク時は、スケールアップが完了するまでの数分間メモリ不足でクエリが失敗することがあります。こうしたエラーを検知するとサーキットブレーカーが作動して自動で MySQL 実装に切り替わり、ClickHouse に問題が起きてもサービスは止まりません。
また、MySQL と ClickHouse の二重管理では「両者は本当に一致しているのか」が常につきまといます。そこで、両者の件数や集計値を定期的に突き合わせる差分チェックの仕組みを用意し、ずれたらすぐ気付ける状態を作りました。これが安心して移行範囲を広げるための土台になっています。
導入の背景・解決したかった問題
導入背景
Findy Team+ は GitHub や Jira などの開発データを取り込み、エンジニア組織の生産性を可視化する SaaS です。データベースには Aurora MySQL を使っています。ユーザーが組織・チーム・メンバー・期間を自由に切り替えながら、大量のイベントデータを集計して閲覧する画面がプロダクトの中核です。しかしデータ量の増加に伴い、集計クエリの遅さが課題になっていました。
インデックス追加、JOIN 削減、キャッシュ戦略、データマートの段階的導入など MySQL 側の改善は継続的に積み重ねてきましたが、OLTP (トランザクション処理) 向けに設計された MySQL では分析クエリの高速化に構造的な限界があります。特にパーセンタイル計算や数百万件規模のイベント集計は、行指向ストレージである以上どうしても改善が頭打ちでした。そこで列指向の OLAP (分析処理) エンジンの導入を検討しました。
比較検討したサービス
- クラウド DWH (データウェアハウス): BigQuery / Snowflake / Amazon Redshift
- StarRocks
比較した軸
- ユーザーが操作するたびに集計するプロダクト画面の表示に耐えるクエリレイテンシ
- コストとその予測可能性
- JOIN・CTE・ウィンドウ関数など SQL の柔軟性
- ローカル開発環境で本番と同じエンジンを再現できるか
- コミュニティの情報量とサポート体制
選定理由
BigQuery / Snowflake / Redshift といったクラウド DWH は大規模なバッチ分析や BI を主眼にした設計で、レイテンシとコストの面でユーザー向け画面のバックエンドという用途に合いませんでした。StarRocks は国内事例の少なさが懸念でした。なお TiDB のような HTAP 型 (トランザクション処理と分析処理を1つで担う) データベースは、OLTP 本体である Aurora の載せ替えを伴い影響範囲が大きくなりすぎるため、既存構成に追加できる OLAP 専用エンジンに絞って検討しました。
その中で有力だった ClickHouse をまず PoC したところ、既存の MySQL クエリと比べて5〜8倍の高速化を確認でき、要件を十分に満たしたため、他の候補を順に試すまでもなく採用を決めました。決め手はレイテンシで、OLAP データベースの中でもリアルタイム分析向けの低レイテンシを強みとして設計されている点がこの用途に合っていました。
加えて、公式ドキュメントの「ClickHouseはなぜこんなに速いのか?」が、列指向ストレージ、マージ時に計算を済ませておく設計、CPU のベクトル命令 (SIMD) を活かすベクトル化実行といった速さの理由を丁寧に説明しています。PoC の数字が偶然ではなく設計に裏打ちされたものだと納得できたことも、採用を後押ししました。
パーセンタイル計算や、配列をそのままカラムに格納して配列関数で操作できる Array 型など、分析用途の機能がネイティブに揃っている点も大きな利点でした。Docker で本番と同じエンジンをローカルに立てられる点も開発体験として魅力でした。ドキュメントが充実しており、日本法人から直接サポートを受けられる点は安心材料でした。
導入の成果
主要な集計クエリが平均6〜10倍、最も効果が大きい時間帯別アクティビティ集計では18倍高速化しました。ただし18倍の分は、移行に合わせて生イベントのその場集計から事前集計テーブルの参照へ集計方法を見直した効果も含みます。画面表示の体感でも8秒程度かかっていたページが2秒程度になり、約4倍の改善です。重い集計を ClickHouse に逃がしたことで MySQL 側の負荷軽減にもつながっています。
体制面では、2025年12月に PoC を実施し、2026年2月の実装開始から約2ヶ月で最初の画面を本番投入しました。実装は主に2名で進めました。既存の MySQL 実装を残したままフィーチャーフラグで切り替えていく方式だったので、少人数でも安全に進められました。
導入時の苦労・悩み
一番苦労したのは、ミュータブルなデータ (あとから変わる・消えるデータ) の扱いです。ClickHouse が最も得意とするのはログのような追記専用データの集計ですが、私たちが扱うプルリクエストやイシューは、取り込んだあともステータス変更やマージ、ラベル付けで更新され続けます。RDB では当たり前だった更新・削除を、ClickHouse の前提で組み立て直す必要がありました。
更新は、同一キーで新しい行を INSERT すると古い行がバックグラウンドのマージで置き換わる ReplacingMergeTree で表現しています。マージまでは古い行も残るため、最新状態を読むにはクエリ時に重複をマージする FINAL 修飾子か、最新行の値を取り出す集約関数 argMax() を使います。FINAL は手軽ですが、付けたクエリでは Projection (同じテーブル内に別のソート順でデータのコピーを持つ仕組み) が使われなくなります。かといって argMax() への書き換えも機械的にはいかず、列ごとに更新されうるかを見極めながら、クエリごとにどちらを使うか判断しています。
削除は、当初の ALTER TABLE ... DELETE (mutation) では負荷が積み上がったため、削除マークだけを付けて物理的な整理はマージに任せる Lightweight DELETE に切り替えました。日常的に削除が発生するテーブルでは、削除フラグを立てた行を INSERT する論理削除にして、更新と同じ仕組みに揃えています。その場で書き換えるのではなく、整理はバックグラウンドのマージに任せる。これが ClickHouse と付き合う前提だと学びました。
ミュータブルなデータと付き合ううえで軸にしているのは、それぞれの値が不変か可変かを意識し、可変な部分を局所化するという設計方針です。
- 書き込み時に確定する値: 集計対象と同じテーブルに非正規化して埋め込み、クエリ時の JOIN を減らす
- あとから変わる属性: 別テーブルに分離してクエリ時に JOIN する
- 頻繁に変わるデータ: そもそも ClickHouse に持ち込まず、MySQL 側で解決した ID をクエリパラメータとして渡す
可変な部分を MySQL に寄せられるのは、データの本体を MySQL に残すハイブリッド構成ならではです。
導入に向けた社内への説明
上長・チームへの説明
まず小さく PoC を実施し、既存の MySQL クエリとの実測比較で5〜8倍の高速化という定量的な結果を出してから、設計ドキュメントとして社内に提案しました。ドキュメントには次の内容を含め、新しいミドルウェアを増やすことへの不安に先回りして答える形にしました。
- 「なぜ MySQL では限界なのか」を OLTP と OLAP の違いから説明する背景
- 他の OLAP データベースとの比較表
- リスクと対策、コスト試算
- フィーチャーフラグによる段階導入の計画
既存の MySQL 実装をすべて残してフォールバック経路とする方針も、「失敗しても元に戻せる」導入として合意を得やすかったポイントです。
活用方法
チーム・メンバー単位の開発生産性メトリクス (プルリクエスト数、リードタイム、レビュー数、DevOps 指標など) の集計クエリと、時間帯別アクティビティの集計を ClickHouse で処理しています。MySQL から同期したイベントデータを、画面からのリクエストごとにリアルタイムに集計する使い方です。
よく使う機能
- ReplacingMergeTree: 同一キーの重複をマージ時に排除。MySQL からの差分同期と相性が良い
- argMax() + GROUP BY:
FINALを使わずに最新行を取得するイディオム - quantile(): パーセンタイル計算がネイティブ関数一発
- Array 型 + hasAny(): MySQL では 1:N の別テーブルに正規化していた属性を配列カラムに埋め込み、JOIN なしで絞り込む使い方をしている
- Projection: 同一テーブル内に別ソート順のコピーを持ち、クエリに応じて自動選択
- Dictionary: マスタデータをメモリに載せてキーから直接値を引ける仕組み。マスタ参照の JOIN を
dictGet()に置き換えている
ツールの良い点
ClickHouse 本体
- 集計クエリが圧倒的に速い。列指向 + 高圧縮で、MySQL で数秒かかる集計がサブ秒で返る
- パーセンタイル、配列操作、ウィンドウ関数など分析向けの SQL 機能が最初から揃っている
- オブザーバビリティが標準で備わっている。全クエリの実行履歴がシステムテーブルに残り、読み書きした行数・レイテンシ・メモリ使用量まで SQL で確認できるので、遅いクエリの特定や改善効果の計測がしやすい
- Docker イメージで本番と同じエンジンをローカルに再現できる。自動テストも実際の ClickHouse に対して実行できていて、開発体験が良い
- 公式ドキュメントが充実している (日本語版もある)
- クエリ単位の
SETTINGSで実行時の挙動を切り替えられる。JOIN アルゴリズムの指定や、検証時に Projection を無効化して結果を突き合わせるといった使い方ができ、チューニングと検証がクエリ1本の中で完結する
ClickHouse Cloud
- 使い始めが簡単。サービスを作って接続情報を受け取るだけで、迷うところがなくすぐにクエリを投げられた
- 運用負荷からの解放。サーバ管理・バージョンアップ・バックアップといったデータベース運用を任せられ、新しいミドルウェアの導入にもかかわらず運用の手間がほとんど増えなかった
- オートスケールにより、小さめのインスタンスから始めて負荷に応じて伸ばせる。私たちは 8GiB × 2 レプリカという、オートスケールを有効にしたときの最小構成のまま本番トラフィックを捌けている
- コンピュートとストレージが分離されていて、データはオブジェクトストレージ (S3) に置かれる。列指向の高圧縮と相まってストレージコストが安い
- コンソールの AI 機能で調査ができる。クエリログを AI に調べてもらい、ボトルネックの分析から改善案の提案まで任せられる
- 課金がコンピュートの稼働時間とストレージ量で決まり、クエリ数やスキャン量には比例しない。ユーザー操作のたびに集計する画面バックエンドでも費用が読みやすい
- バージョンアップのリリースチャンネルを環境ごとに選べる。ステージングは早めのチャンネル、本番は通常のチャンネルにしておくと、新バージョンをステージングで先に踏んでから本番に届く流れが自然にできる。アップグレード作業そのものは Cloud 側に任せられる
- セキュリティ面が整っている。Private endpoint (AWS PrivateLink) で VPC 内に閉じた経路で接続でき、SOC 2 Type II にも対応しているので、顧客データを扱う SaaS の要件に沿いやすい
- 日本法人から直接サポートを受けられる
ツールの課題点
最初の2つは、更新・削除の多いデータを扱う私たちの使い方で顕在化したものです。ログやイベントのような追記中心のデータや、更新頻度の低いデータを分析する用途では、ほぼ問題になりません。
- UPDATE / DELETE の設計転換が必須。「その瞬間に書き換わってほしい」という RDB 感覚のまま mutation を多用すると、負荷が高くなる。ReplacingMergeTree による更新や Lightweight DELETE を前提に設計すれば対応できる
- 重複排除が結果整合のため、
FINALやargMax()など「正しく最新を読む」ための知識が常に求められる - オートスケールはスケールアップの完了までに時間がかかるので、急な負荷スパイクにはメモリ不足への備え (リトライやフォールバック) がアプリ側に必要。負荷のピークが予測できるなら、API で最小スケールをあらかじめ引き上げておく方法もある
- 小さな書き込みが苦手で、同期パイプラインの設計 (バッチング・同時実行数制御) に工夫が要る
- 開発が活発で機能追加が速い分、新しめの機能の組み合わせでは未修正のバグを踏むことがある。挙動がおかしいときは公式リポジトリの Issue を確認する心構えが必要。Issue には状況と回避策が整理されていることが多く、私たちも回避策で乗り切れた
ツールを検討されている方へ
ClickHouse というと、数兆行規模のデータや秒間数百万行の書き込みを捌くような超大規模な事例が有名で、「うちはそこまでのデータ量ではないから関係ない」と感じるかもしれません。私たちも最初はそう思っていました。ところが PoC で試してみると、ClickHouse の世界では小さな部類の私たちのデータ量でも十分いけそうな手応えがありました。そして実際に、「既存の OLTP データベースで集計クエリだけが遅い」という悩みに対するアクセラレータとして、本番でも期待どおりの効果が得られています。
構成の面では、MySQL や PostgreSQL を本体に残したまま、分析レイヤーだけ ClickHouse を併用する形が定番になりつつあります。この構成なら、既存実装をフォールバック経路として残しながらフィーチャーフラグで段階導入でき、リスクを抑えつつ効果の大きい画面から高速化できます。
この記事では苦労した点を多めに書きましたが、その多くは更新の多いデータを扱うという私たちの使い方に由来し、パターンさえ掴めば工夫次第で乗り越えられるものでした。その条件でも、集計に関しては圧倒的に速く、運用の手間もほとんど増えていません。RDB の集計クエリの遅さに悩んでいるチームには、頼もしい選択肢としておすすめします。
今後の展望
ClickHouse 化しているのはまだ集計の一部で、対象の画面・メトリクスを段階的に広げているところです。その先では、ClickHouse だからこそ実現できる分析の拡充にもつなげていきたいと考えています。
ファインディ株式会社 / hatachan
メンバー / バックエンドエンジニア / 従業員規模: 301名〜500名 / エンジニア組織: 51名〜100名
ファインディ株式会社 / hatachan
メンバー / バックエンドエンジニア / 従業員規模: 301名〜500名 / エンジニア組織: 51名〜100名
レビューしているツール
目次
- アーキテクチャ
- 導入の背景・解決したかった問題
- 活用方法