【AI DevEx Conference 2026】変更し続けられるシステムをどう保つか — AI時代のSSoTという設計原則
2026年7月22日、ファインディ株式会社が主催するイベント「AI DevEx Conference 2026」が、JPタワーホール&カンファレンスにて開催されました。
本記事では、Dress Code株式会社 Product & Technology Tech Leadの河村 勇樹さんによるセッション「変更し続けられるシステムをどう保つか — AI時代のSSoTという設計原則」の内容をお届けします。
セッションでは、AIによる実装速度の向上がむしろレガシー化を加速させかねないという課題認識を出発点に、「直し続ける」から「壊して作り直せる」への設計思想の転換と、それを支える「事実」をSSoT(Single Source of Truth)として残す考え方が語られました。さらに、Dress Codeが構築するCoreDBの仕組みや、ADR・SDDを用いた開発プロセスなど、事実を残すための具体的な実践例が紹介されました。
■プロフィール
河村 勇樹
Dress Code株式会社
Product & Technology テックリード
2019年に新卒で大手事業会社に入社し、航空気象サービスの開発に携わる。2021年にレバレジーズ株式会社に中途入社。レバテックCTO室のテックリードとして「レバテック」の開発・組織を牽引。レバテックのリアーキテクトやTiDBの導入を推進。2024年11月にDress Code株式会社に中途入社。アーキテクチャを中心にフルスタックに開発。ドメイン駆動設計やEvent Sourcing・CQRSを推進。採用や技術広報・組織設計にも携わる。趣味はお酒とゴルフとカワウソ鑑賞。
AI時代、変更し続けられる構造はむしろ難しくなっている
河村:Dress Code株式会社でエンジニアリングに関わることをだいたい全部やっている、かわうそこと河村と申します。基盤やアーキテクチャを考えるのが好きで、Event SourcingやNew SQLが好きなエンジニアです。
本日は「変更し続けられるシステムをどう保つか」というテーマで、AIによって実装は速くなった一方で、変更し続けられることはむしろ難しくなっているのではないかという話をしていきます。
皆さんのチームでは、1年前の設計判断を今も正確に追いかけられますか。AIが数秒で数千行を生成し、人が手を入れた先のコードを、半年後も自信を持って変更できますか。この問いについて、今日は考えていきたいと思います。
僕が考えているレガシー化を加速させる要因はこんなイメージです。実装速度がAIによってどんどん上がると、変更頻度も上がり、手を入れる回数も増えます。そうなると複雑性も構造が絡み合って上がっていき、ちゃんとした用語で言えばエントロピーがどんどん増えていく。これによってレガシーが加速するのではないかと考えています。
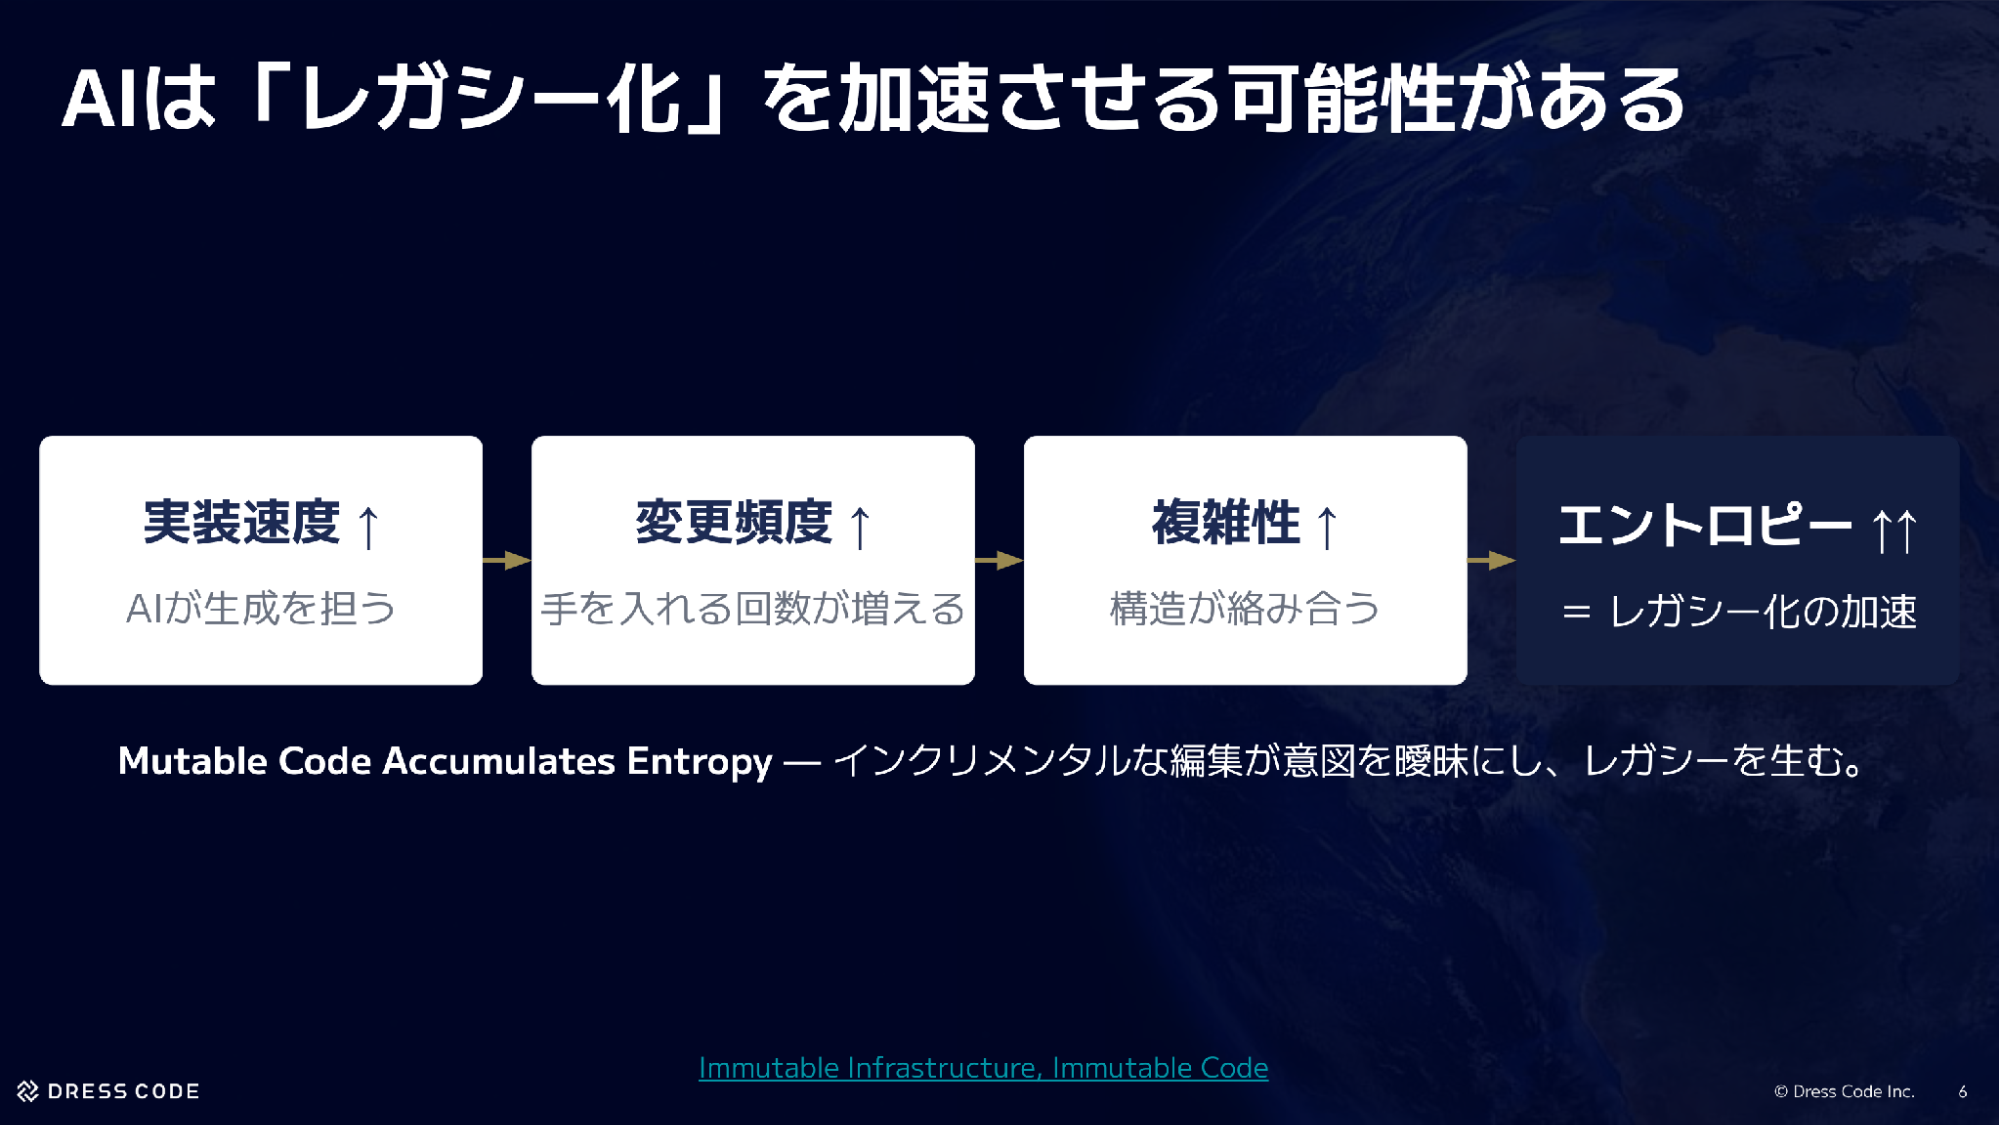
これまでのソフトウェア開発の基本戦術は「既存コードの修正」でした。インクリメンタルな変更は地層のように積み重なっていくものだと捉えられ、それによって整合性が壊れ、エントロピーが増大するという考え方があります。
達人プログラマーの本に書かれている「割れ窓理論」も、まさにこのインクリメンタルな変更の積み重ねが抱えるリスクを表しているのではないかと考えています。
AIは凄まじい速度で生成を行います。ここに人間やAIがインクリメンタルに変更を加えていくと、理解不可能なアーティファクトのようにぐちゃぐちゃになっていく可能性があり、これがむしろ脆いレガシーを作り出しているのではないかと考えています。
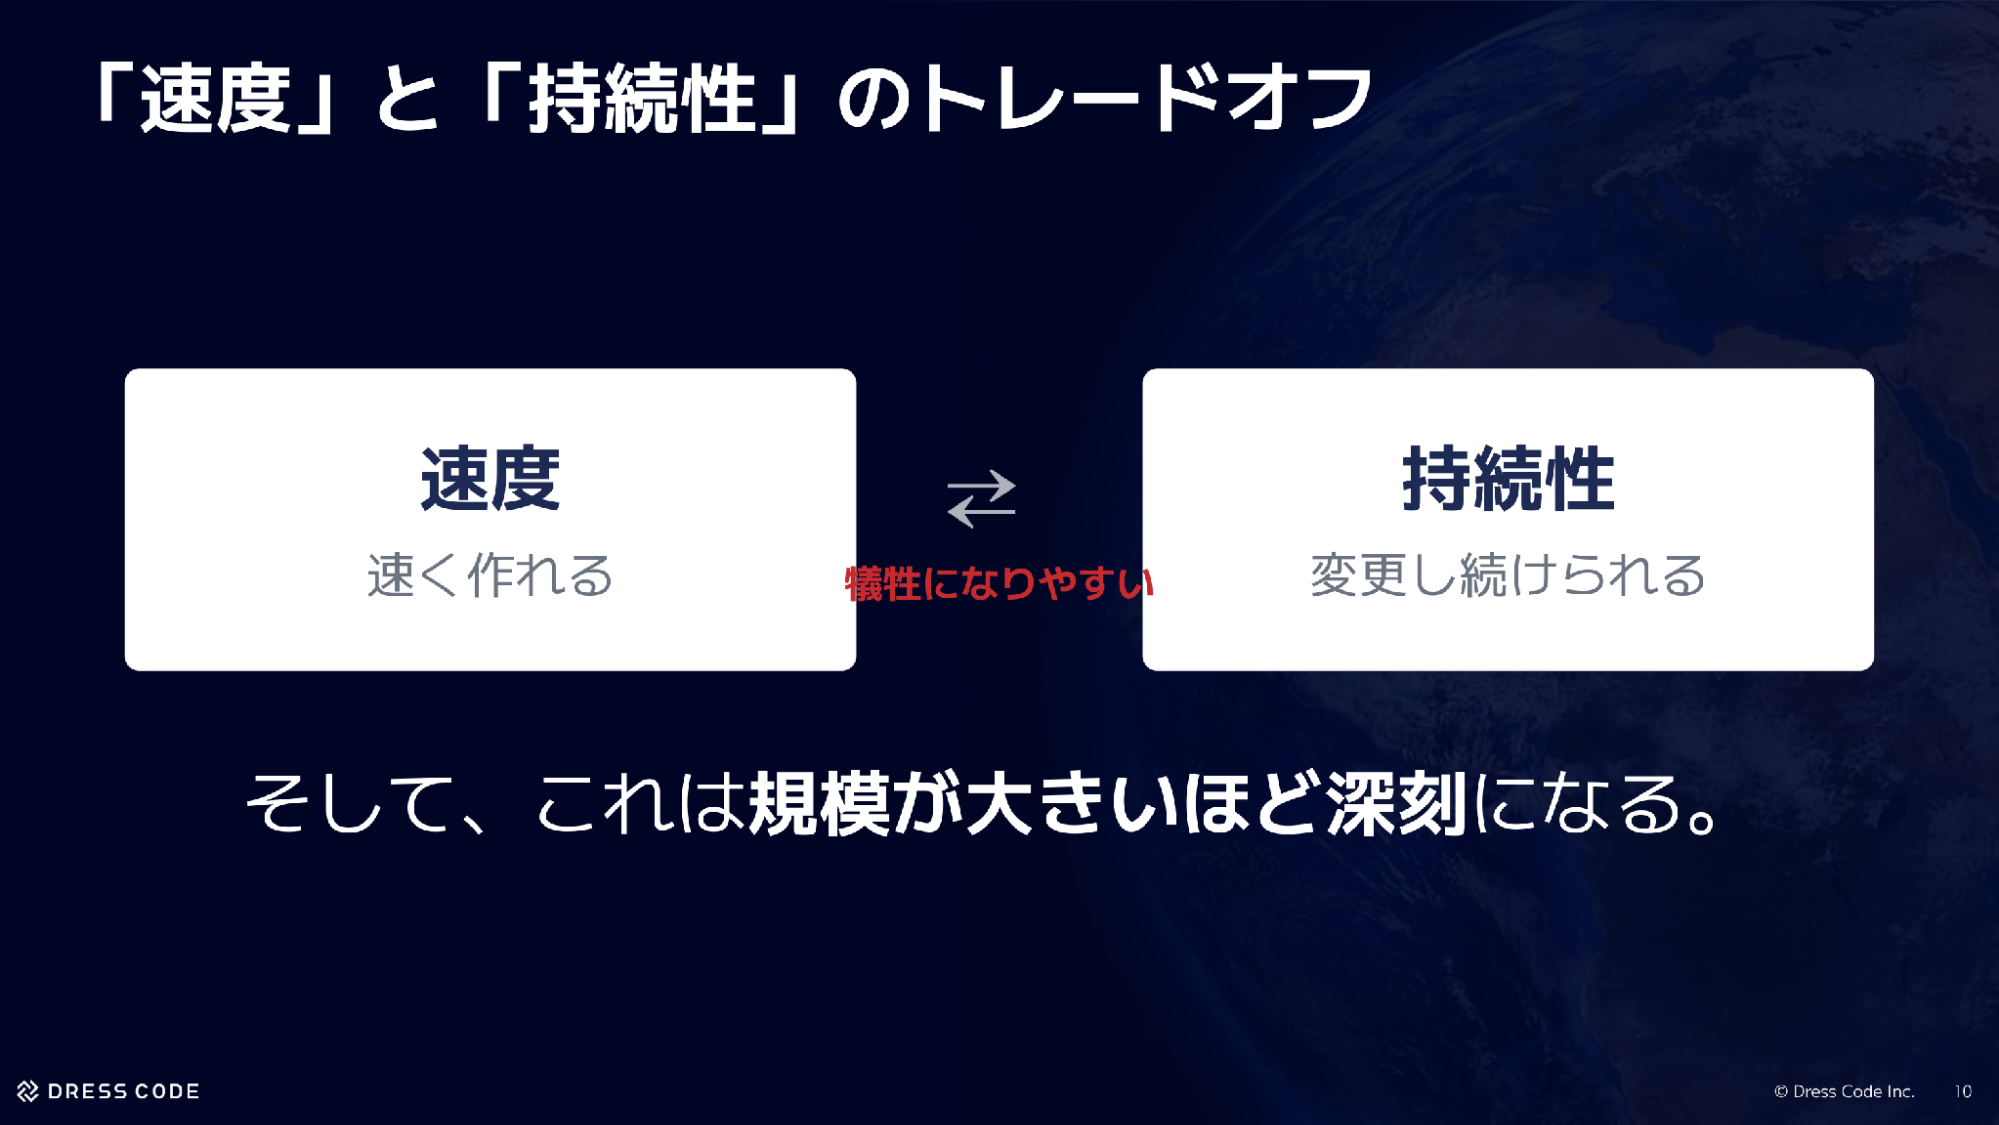
速く作れることと変更し続けられることは、犠牲になりやすい関係にあります。適当にどんどん早く作ったからといって、変更し続けられるわけではありません。これが規模が大きくなるほど深刻な問題になってきます。
直し続けるから壊して作り直すへ——AI時代のパラダイムシフトと犠牲的アーキテクチャ
だから、直し続けるのではなく、作り直せる形にしていくのがいいのではないかと考えています。守る対象を、コードという成果物から、事実という源泉へ移していく話に入っていきます。
AI時代のパラダイムシフトとして、昔は修正するコストの方が安かったと思います。1から作り直すのは大変で、いちいち修正のためにゼロから作るということはしてきませんでした。ですが今の時代は、修正するコストの方が高いのではないかと考えていて、仕様というものから作り直した方が正確で、求めているものをちゃんと実装できるのではないかと考えています。
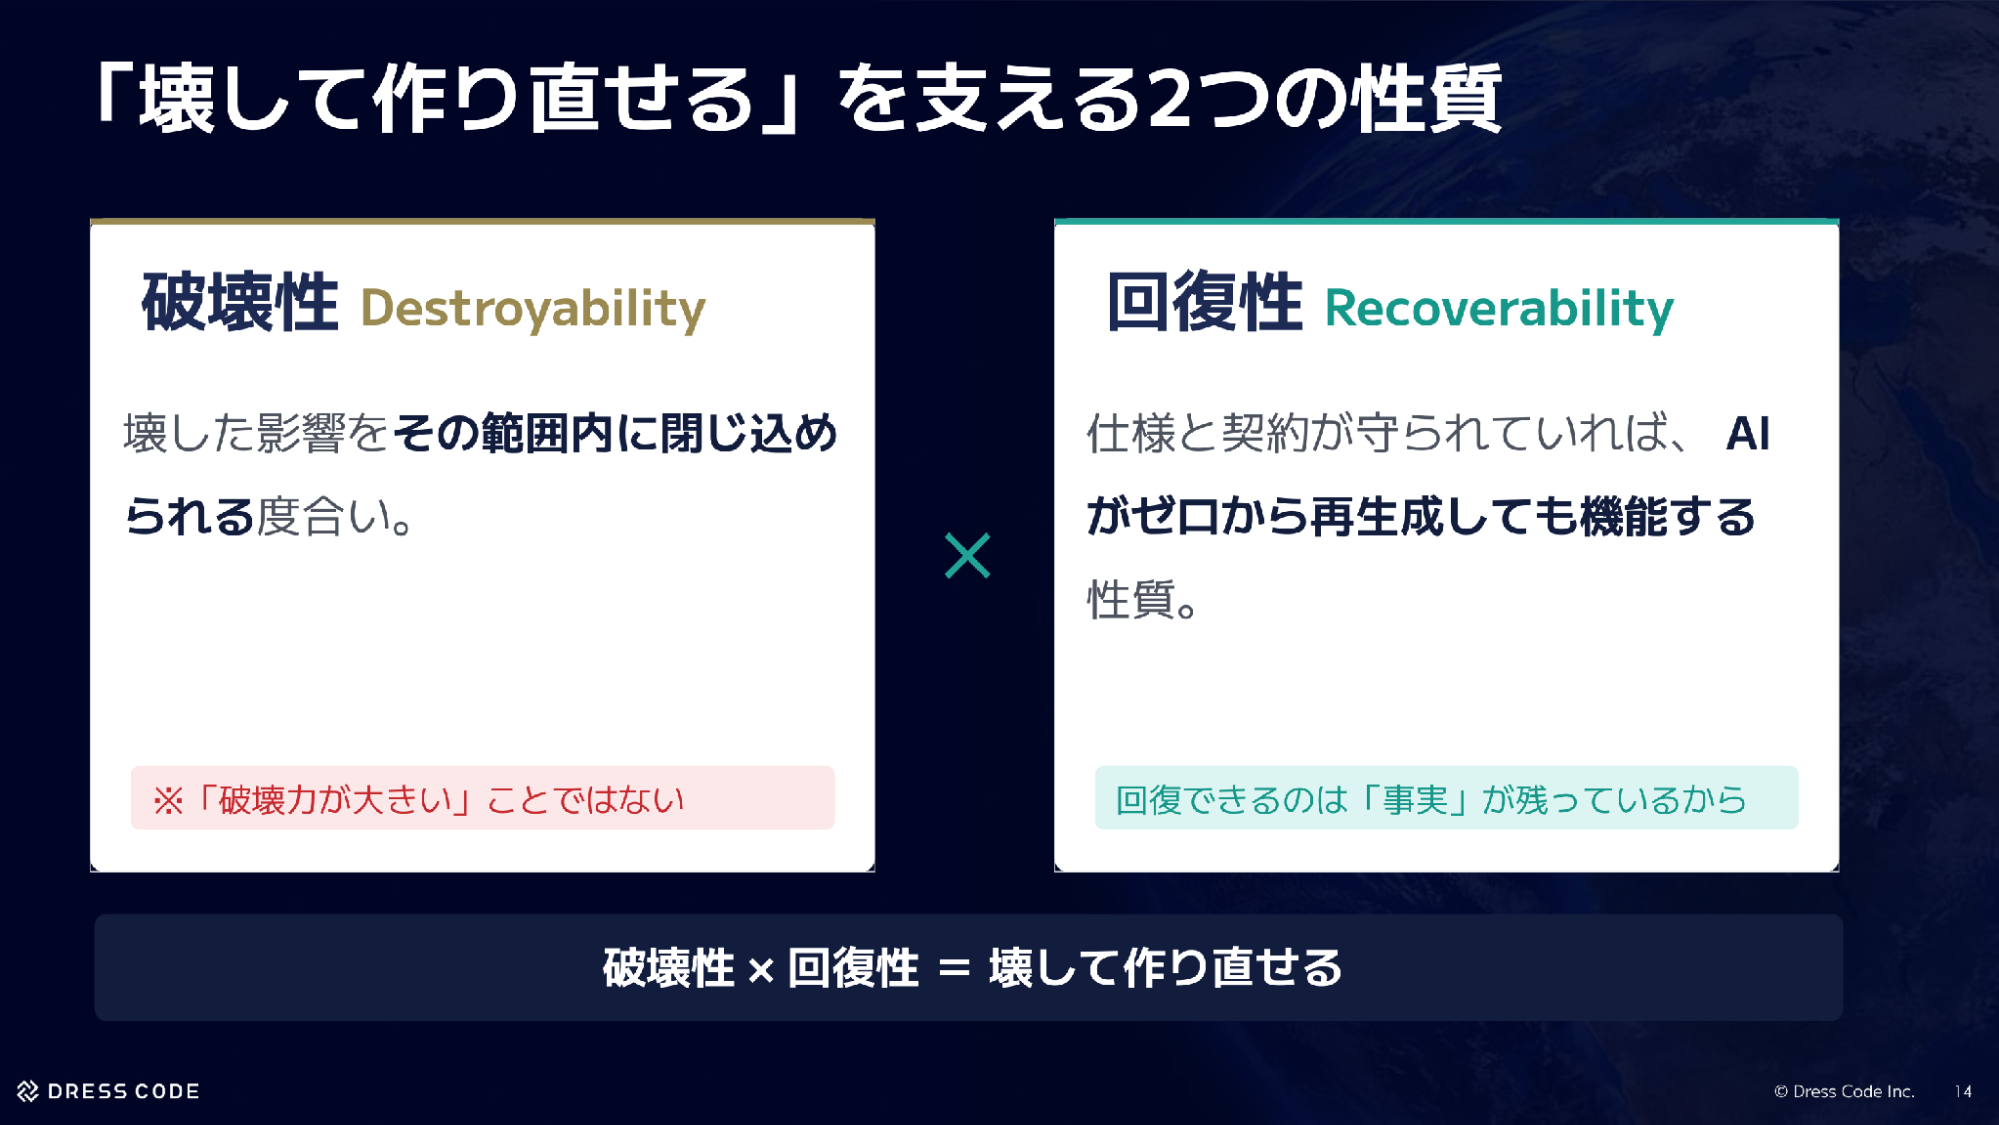
これも意外と昔からある話で、犠牲的アーキテクチャ(Sacrificial Architecture)という考え方があります。今作っているものは、そもそも数年後には破棄されるという前提を受け入れ、設計に織り込んでいこうという考え方です。マーティン・ファウラー氏が語っている考え方で、捨てるということ自体は失敗ではなく、その時点では正しかった判断であり、捨てられるようにやっていきましょうという発想です。
品質を捨てるわけではなく、モジュール性を大事にして、捨てる単位を絞れる状態にしていくことがポイントです。
「壊して作り直せる」を支える破壊性と回復性
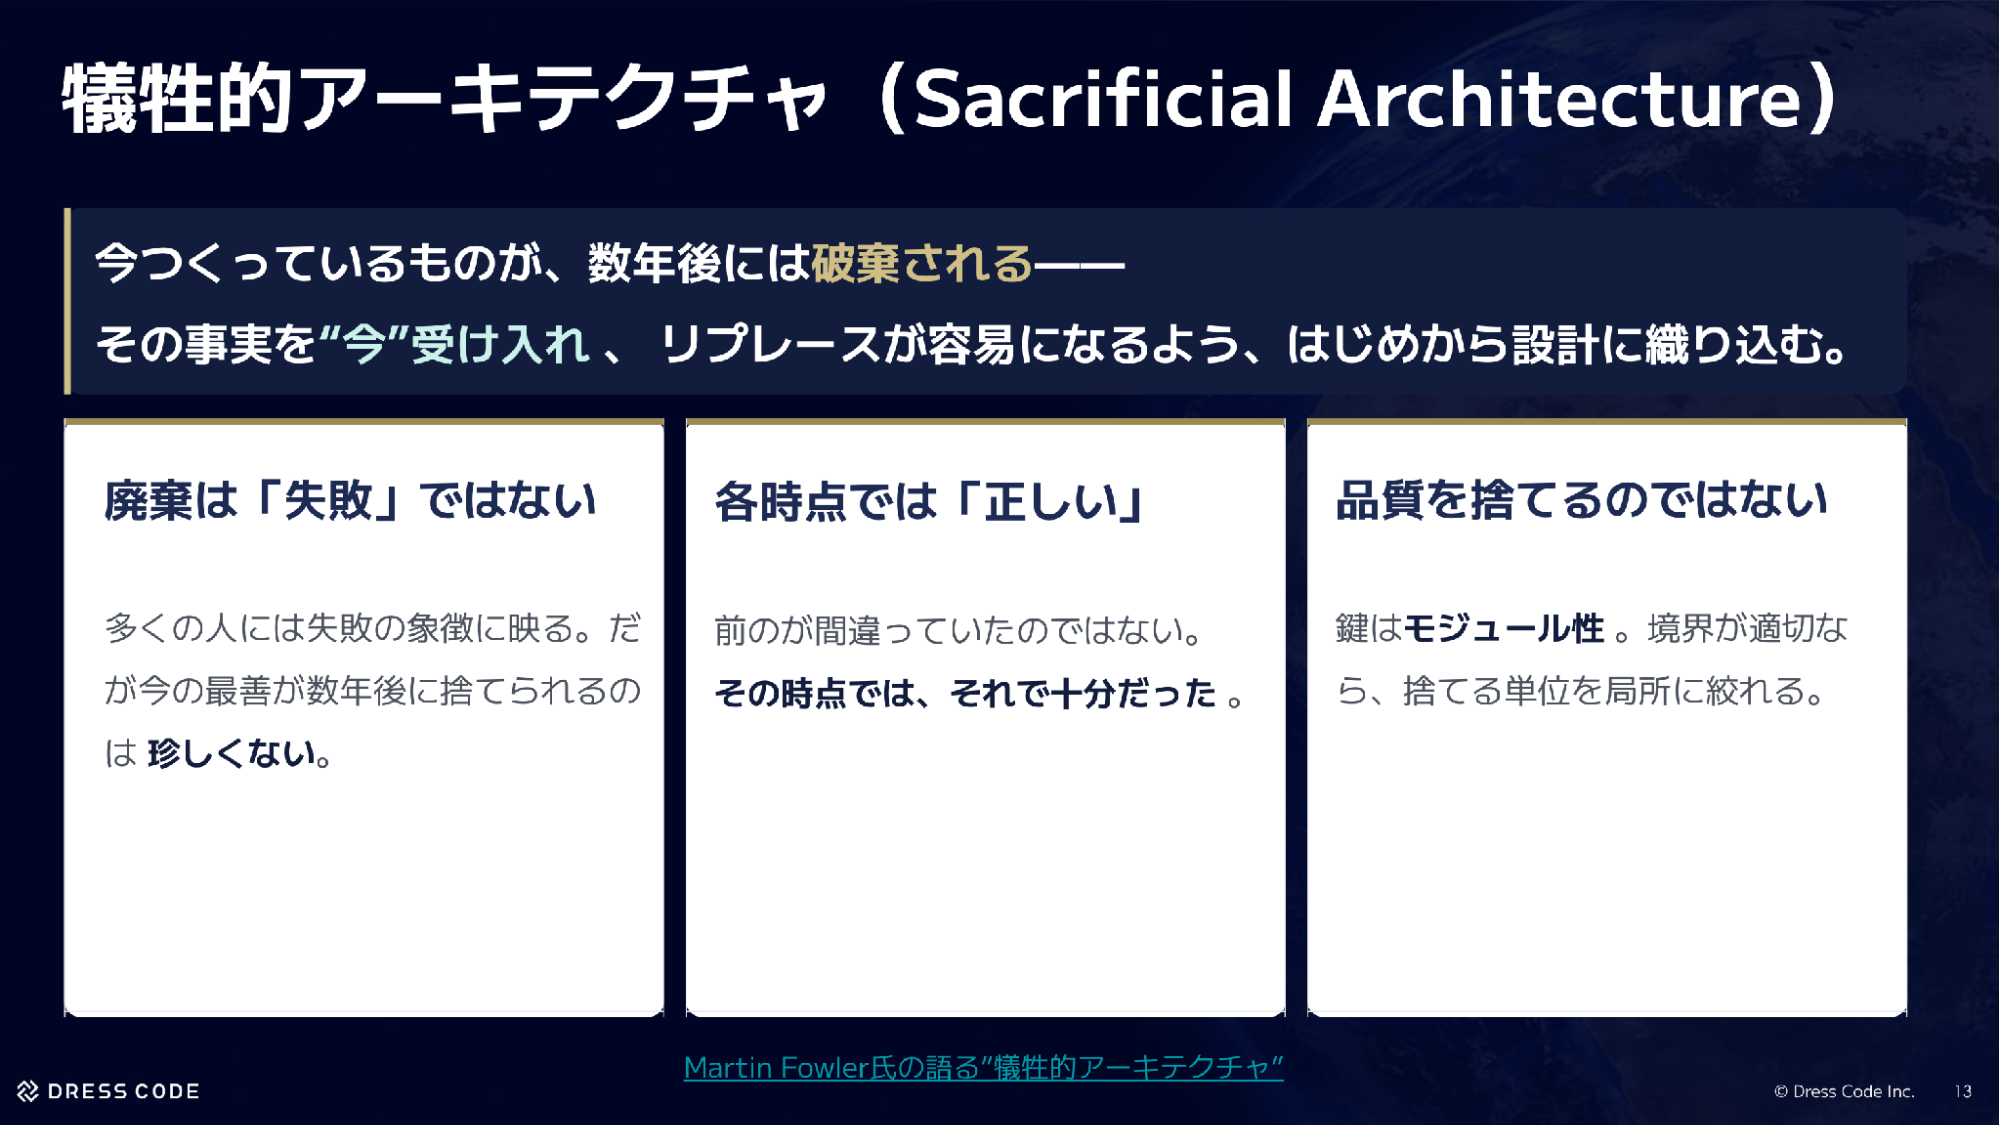
僕が考える「壊して作り直せる」を支える性質は2つあると思っていて、破壊性と回復性という言葉を使っています。破壊性とは、壊した時にちゃんと範囲内に閉じ込められる度合いのことで、破壊力が大きいという意味ではありません。
回復性とは、仕様や契約さえ守られていれば、ゼロから再生成しても機能するという考え方です。回復できるのは、事実がちゃんと残っているからで、この2つが揃って初めて壊して作り直せるという状態になります。
破壊性をもう少し見ていくと、壊しても影響をその範囲に閉じ込められるかどうかという話です。1つのモジュールを壊すと他も連鎖的に壊れてしまう状態は破壊性が低く、逆に消えても他は動き続ける状態は破壊性が高いと言えます。これはAI以前からある設計思想ですが、AI時代には壊して再生するコストが激減したことで、現実的な選択肢になってきていると考えています。
回復性は、壊した部分を差し替えて機能を再び実現できるかという性質です。仕様やインターフェースという事実さえ守られていれば、実装そのものはAIがゼロから再生成しても動く、これが回復性が高い状態です。破壊性だけ高くても再生できなければ意味がなく、回復性だけ高くても壊すと波及するようでは怖くて壊せません。両方揃って初めて成立します。
ここまでの話をまとめると、成果物を守るのではなく、事実をちゃんと残していくということです。事実さえ残っていれば、AIが壊して作り直せる状態にしていくことが重要だと考えています。AIは生成は得意ですが、事実はまったく作ってくれません。
これはコードを守るなという意味ではありません。品質を軽視して技術的負債を放置していいという意味でもなく、守る対象の優先順位を成果物から事実に移していこうという意味です。この事実を残す具体的な形が、今日のタイトルにもあるSSoT(Single Source of Truth)です。
事実をSSoTとして残す——守るべきは成果物ではなく源泉
もう少し補足すると、壊して作り直せる形にしていくのがアーキテクチャだと思っていて、破壊性も回復性も事実があってこそ成り立ちます。その事実を活かしていく器がアーキテクチャという位置づけです。
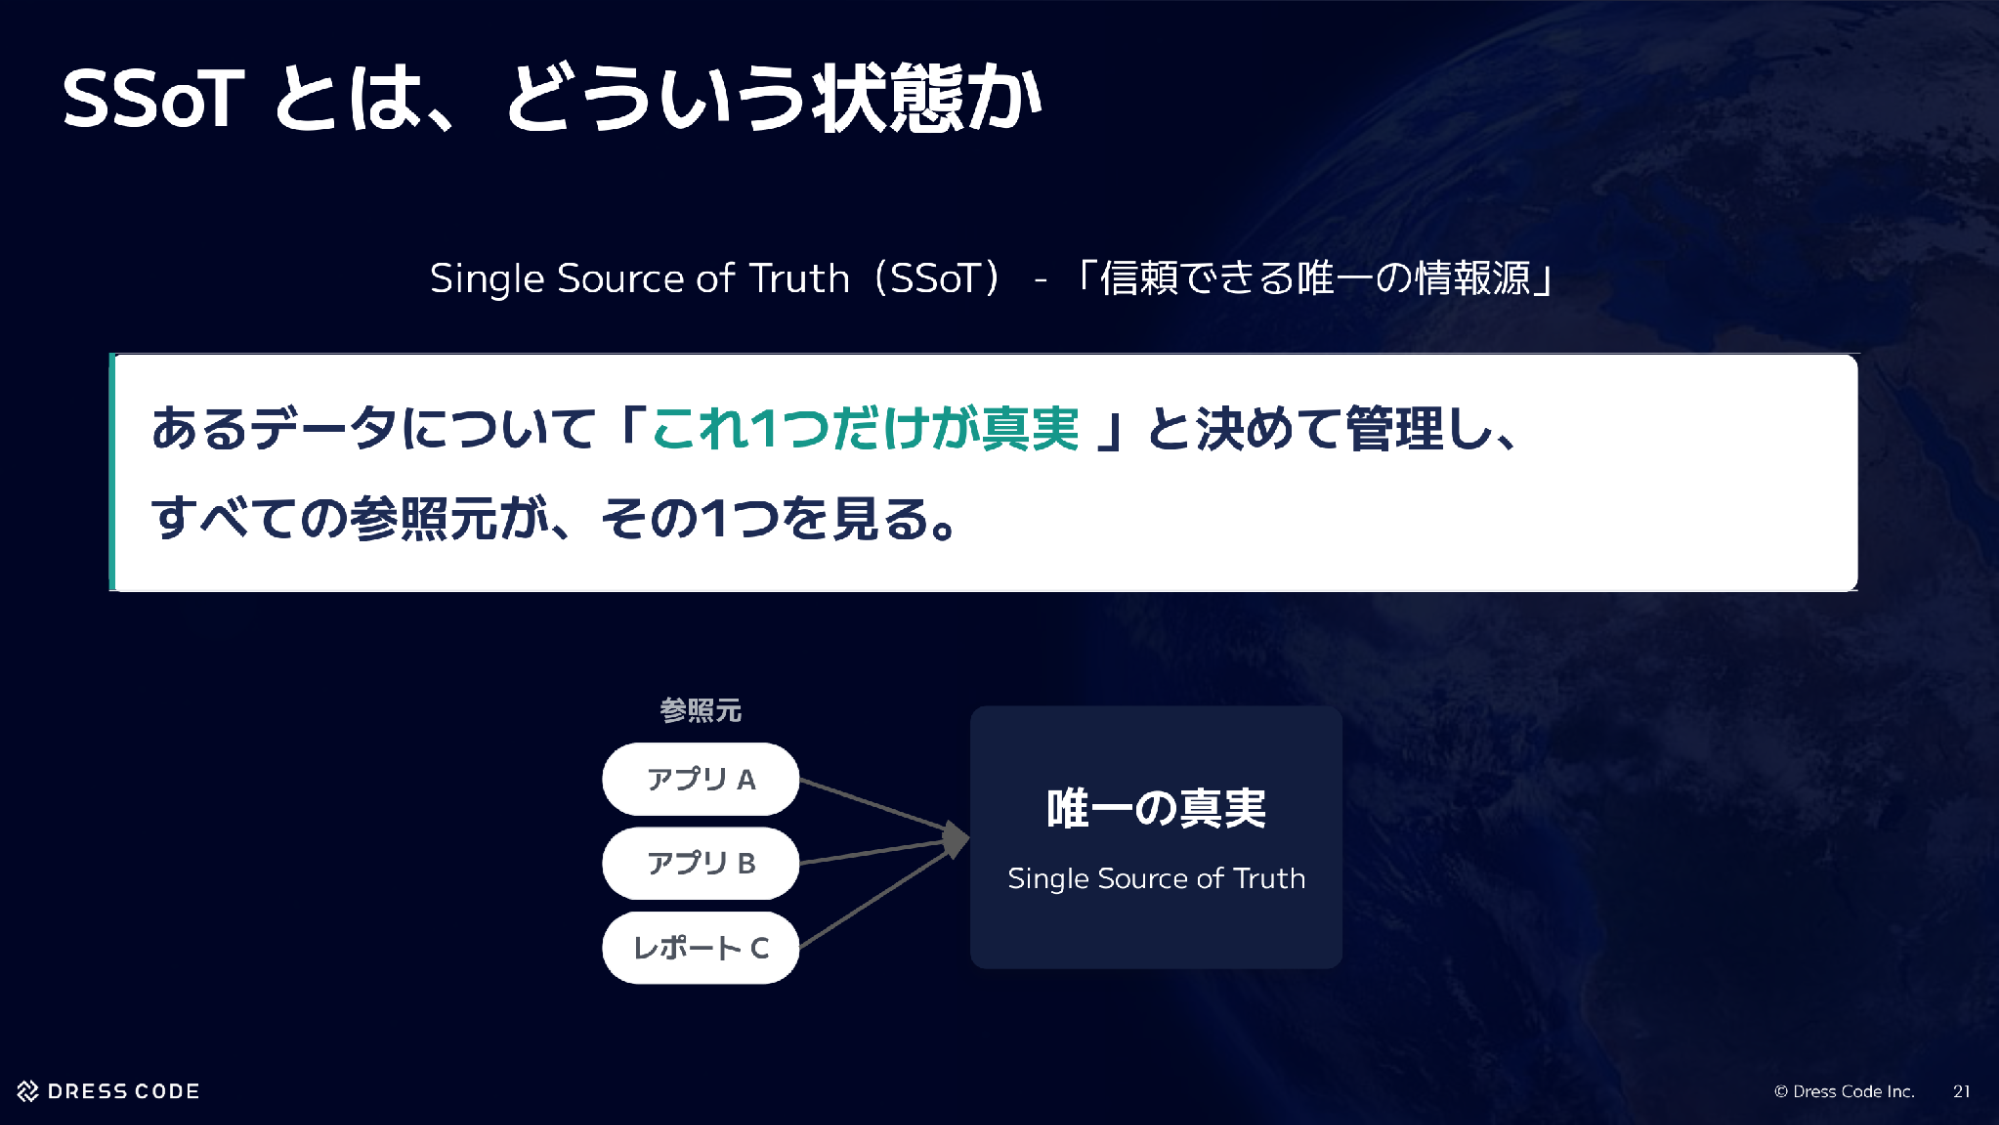
SSoTとは、あるデータについて「これ1つだけが真実」と決めて管理し、すべての参照元がその1つを見るという考え方です。信頼できる唯一の情報源という意味になります。
僕が前提として大事にしているのが、状態や結果は事実からしか作られないということです。可変なものに設計の意識が向きがちですが、何が事実で何が不変なのかを残し、事実に基づいて導出していくことをベースに考えています。
これをデータ、コード、アーキテクチャという3つのレイヤーで、それぞれの事実と導出が何かを図に表してみました。
データ:事実はイベント(誰がいつ何をしたか)。導かれるものは現在の残高や在籍状態
コード:事実は仕様(どう振る舞うべきか)。導かれるものは生成されたコードそのもの
アーキテクチャ:事実は意思決定。導かれるものは構成図
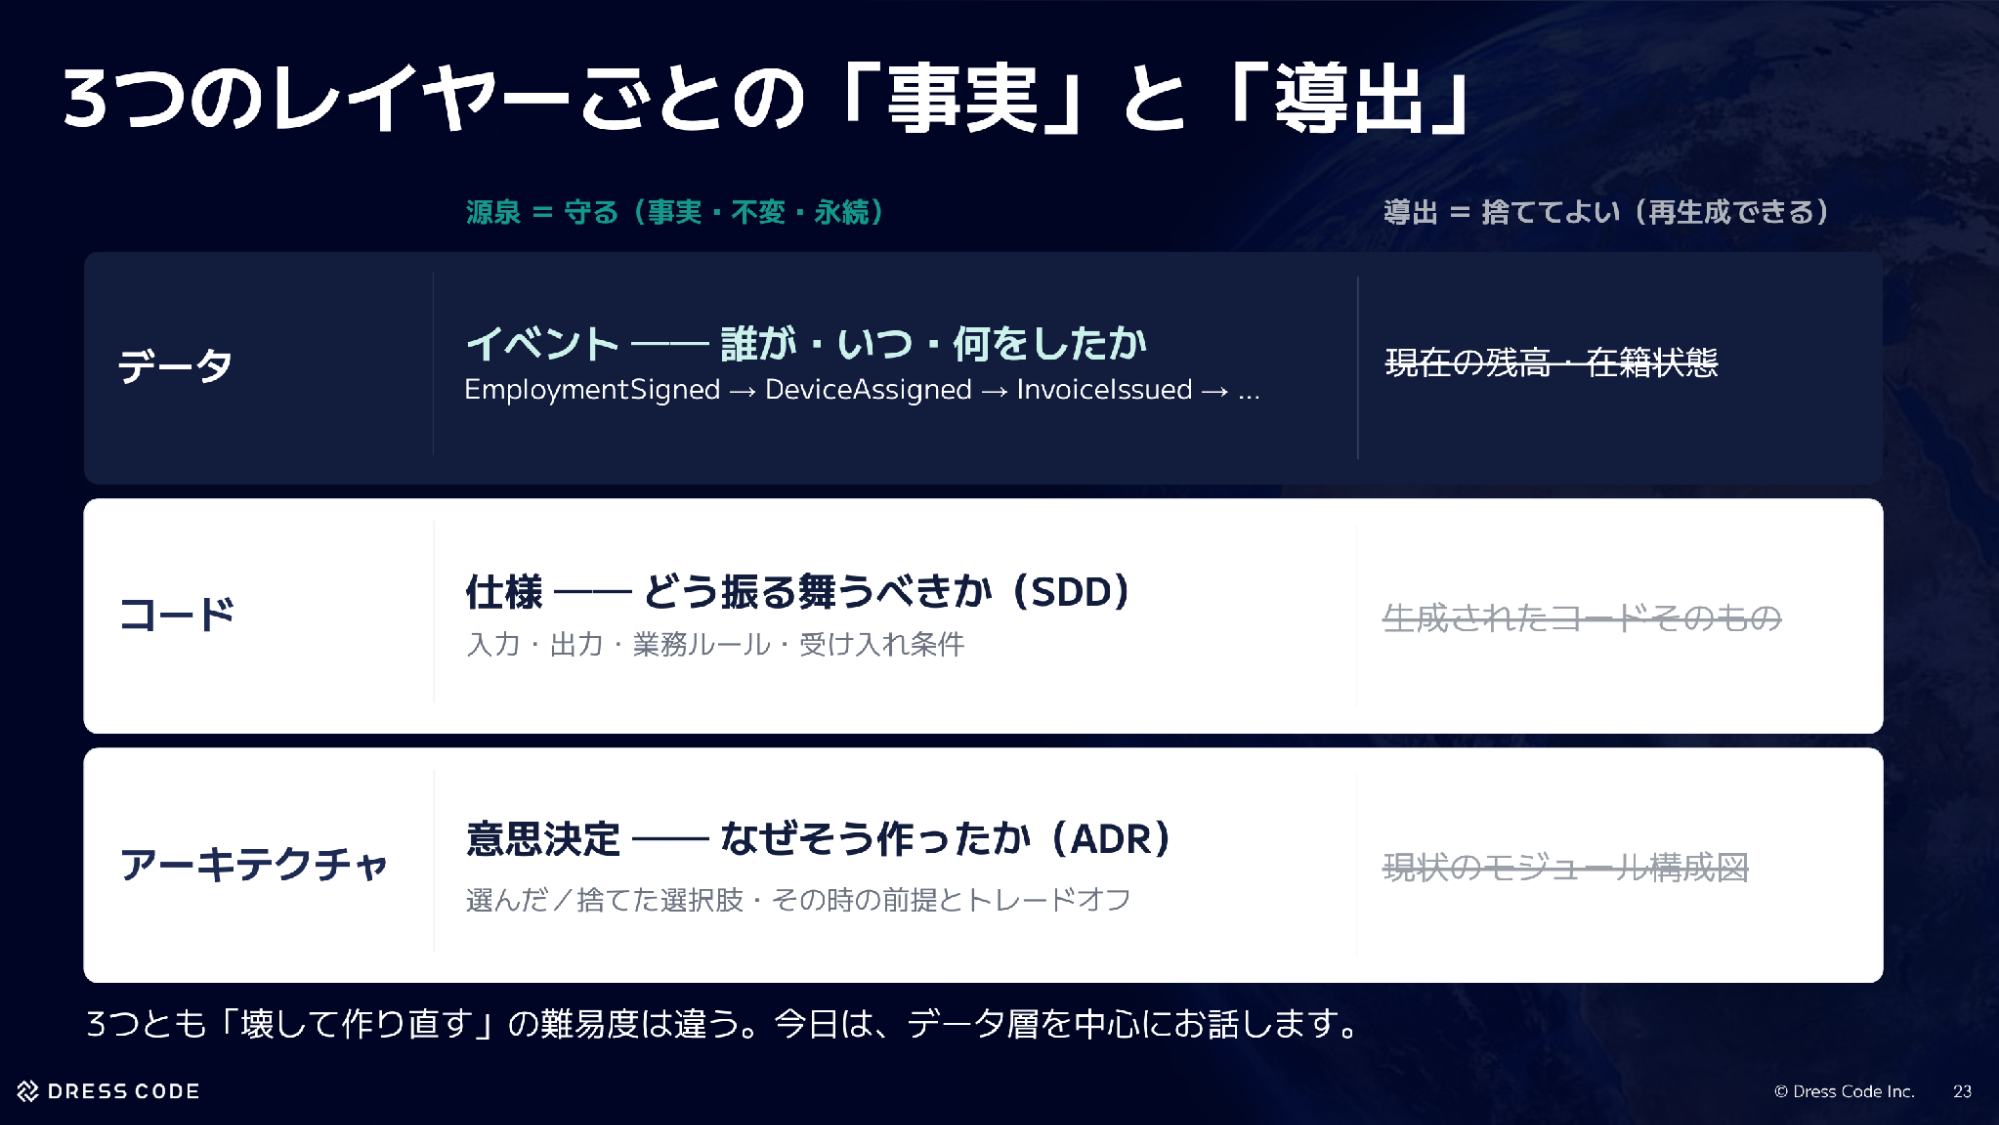
普段の設計では導出物である状態や結果の方に意識が向きがちですが、これは事実がないとできないことです。例えば従業員のデータも、僕は状態だと捉えていて、入社手続きをしたという事実があって初めてその人は従業員になり、在籍することになります。事実がまずあるということを、ちゃんと考えた方がいいと思っています。
それぞれのレイヤーで難易度は全然違いますが、今日はデータ層を中心に話しつつ、後半で開発プロセス周りも話していきます。データ層の思想として大事なのは、状態はあくまで揮発的なもので、イベントが永続的な事実だということです。現在の状態、いわゆるリードモデルは、残された事実からいつでも作り直せるものだという認識が重要だと考えています。
Dress Codeの挑戦領域とプラットフォームケイパビリティ
ここからは、Dress Codeがこの原則をどう実現しているかという話に入っていきます。前提として、まず会社の紹介をさせてください。
Dress Codeは2025年4月に正式創業した、とても若い会社です。特徴の一つとして、創業当時から海外展開をしていて、日本以外にインドネシア、ベトナム、シンガポールなどで事業を展開しています。
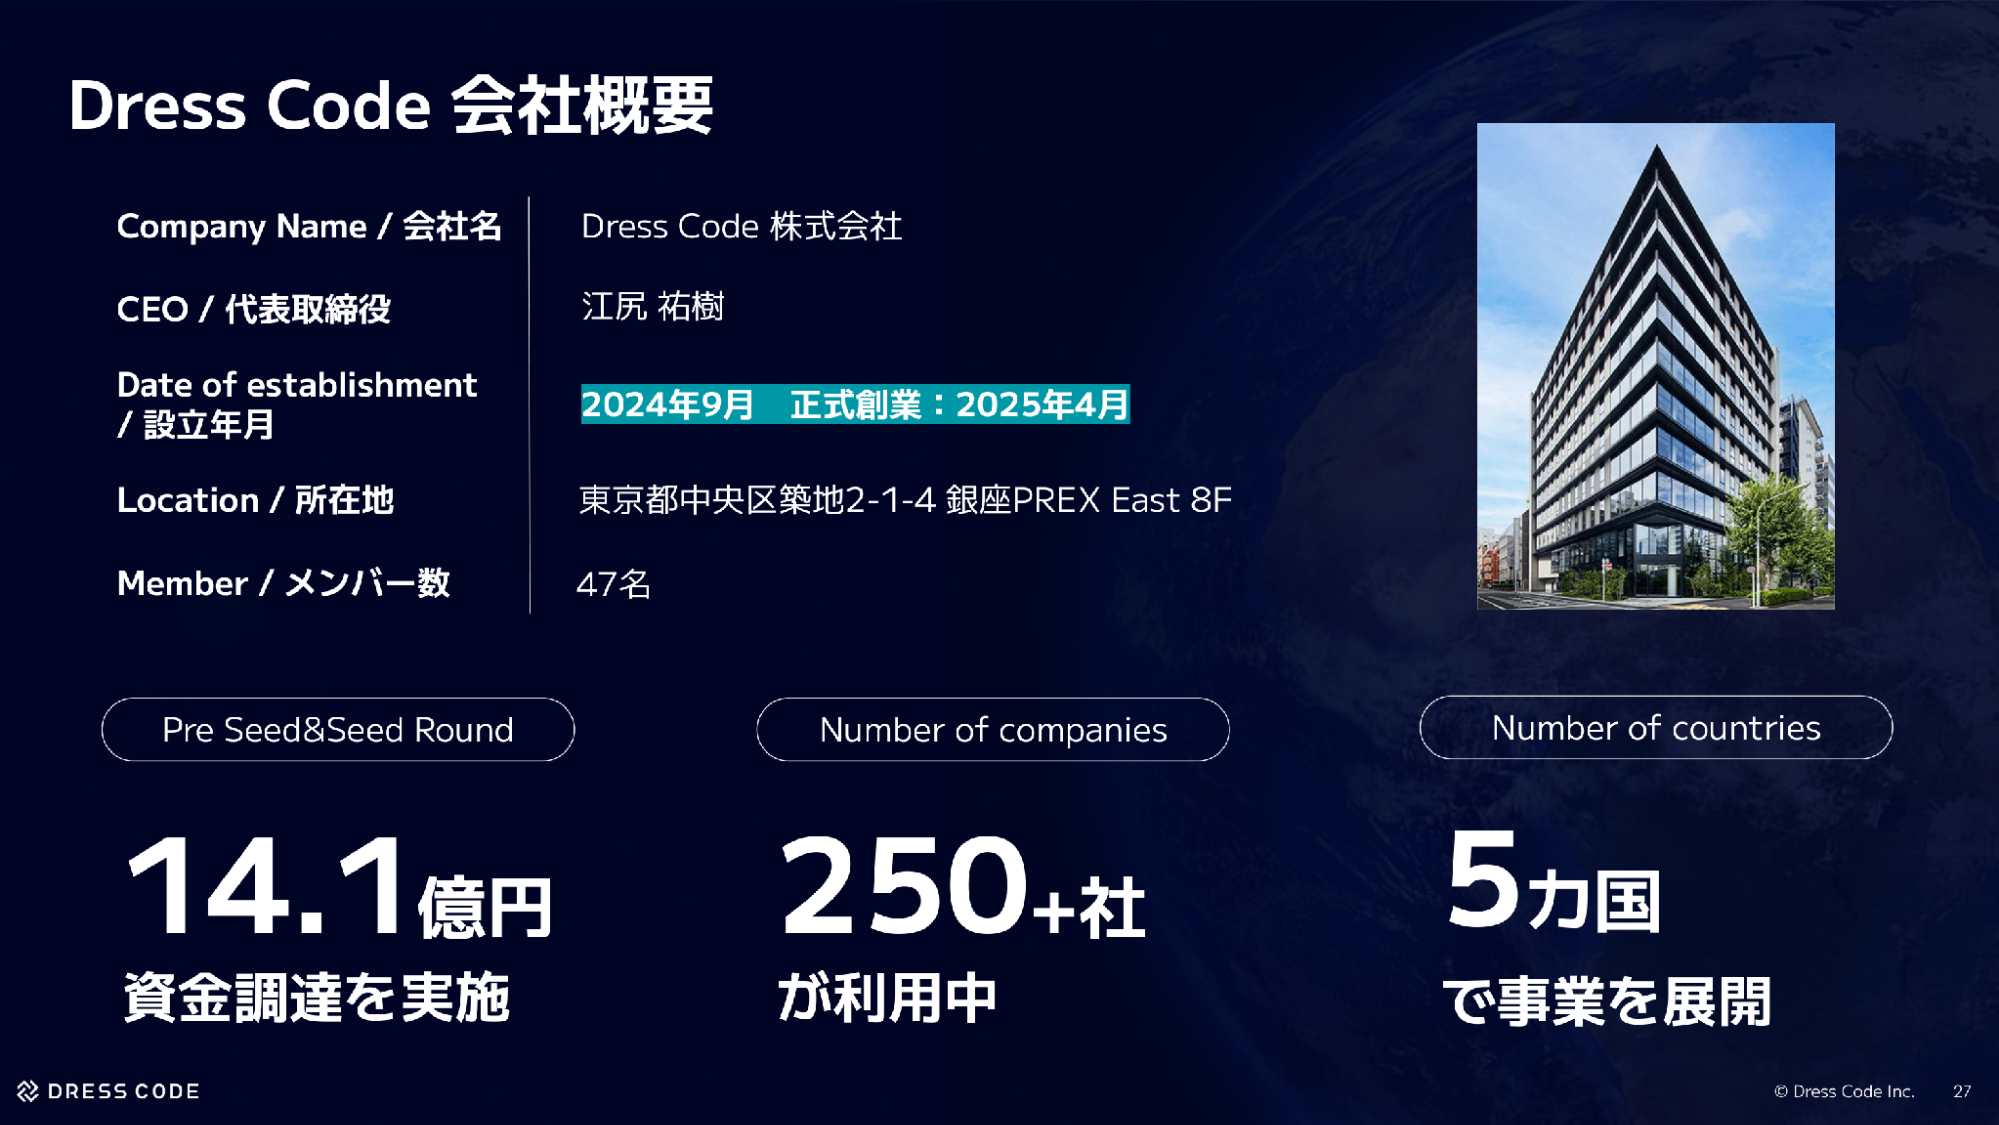
メンバー数は47名(2026年7月時点)で、Pre Seed・Seedラウンドで14.1億円の資金調達を実施し、250社以上に導入されています。
僕たちはバックオフィス向けの領域全般、ワークフォースマネジメントと呼んでいる領域を解決するプロダクトを提供しています。従業員が入社してから退職するまでに発生する採用や労務、コーポレートガバナンスを含めた領域を解決していこうと考えています。
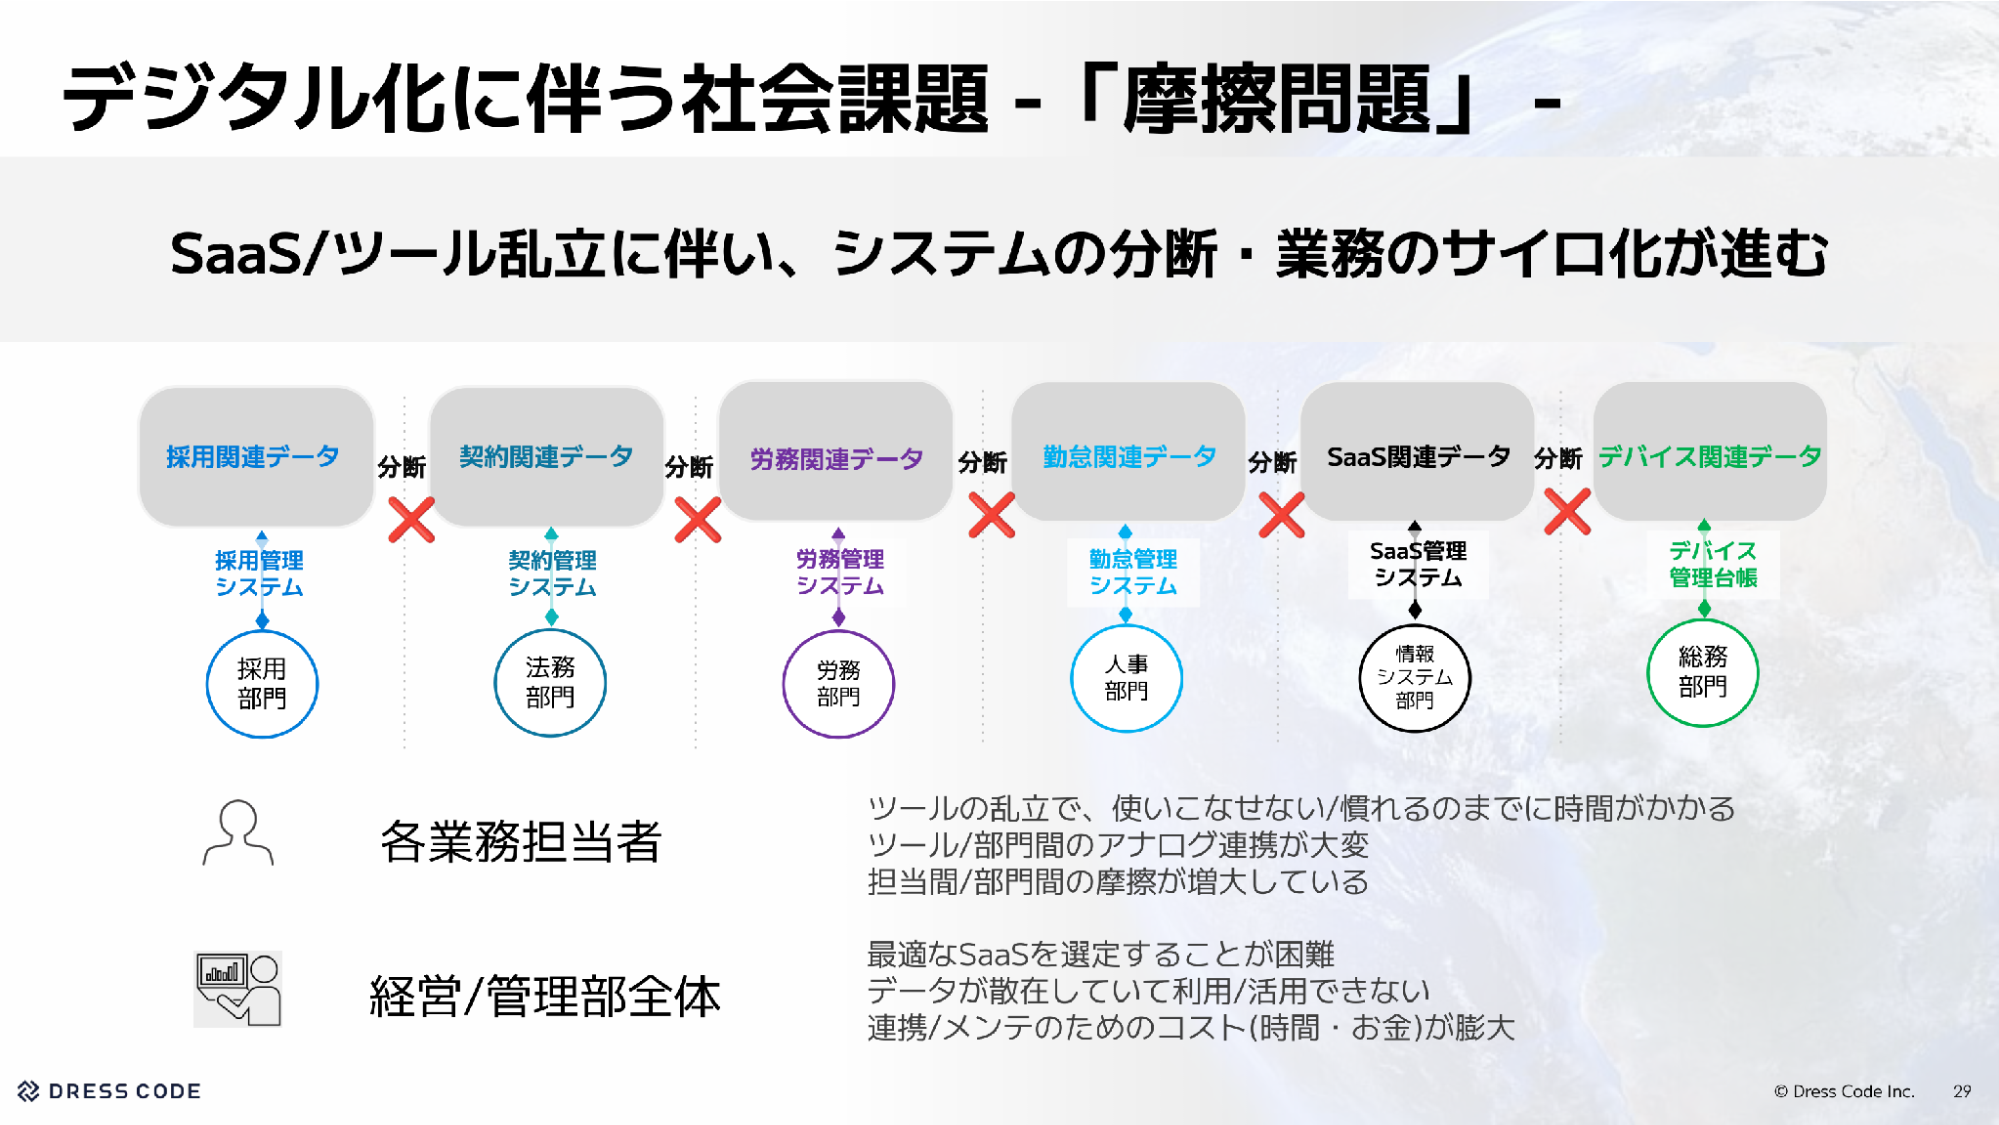
なぜやっているかというと、「摩擦問題」と呼んでいる課題があります。バックオフィスの部門は部門ごとに独立していて、それぞれで最適化されているため、分断や業務の再度化がすごく起きている領域です。
例えば入社という業務ひとつをとっても、採用でオファーを出し、契約で雇用契約を締結し、労務で入社手続きを行い、入社日までにデバイスを用意するというように、部門をまたいで業務が流れていきますが、ここが分断されていると非常に苦しいのがバックオフィスです。ここを解決しようとしているのがDress Codeです。
今は上長向けのITForceや労務向けのHRForce、総務・採用向けのGLといったプロダクトを、従業員ライフサイクルを一気通貫でオペレーションできる形で横展開しています。
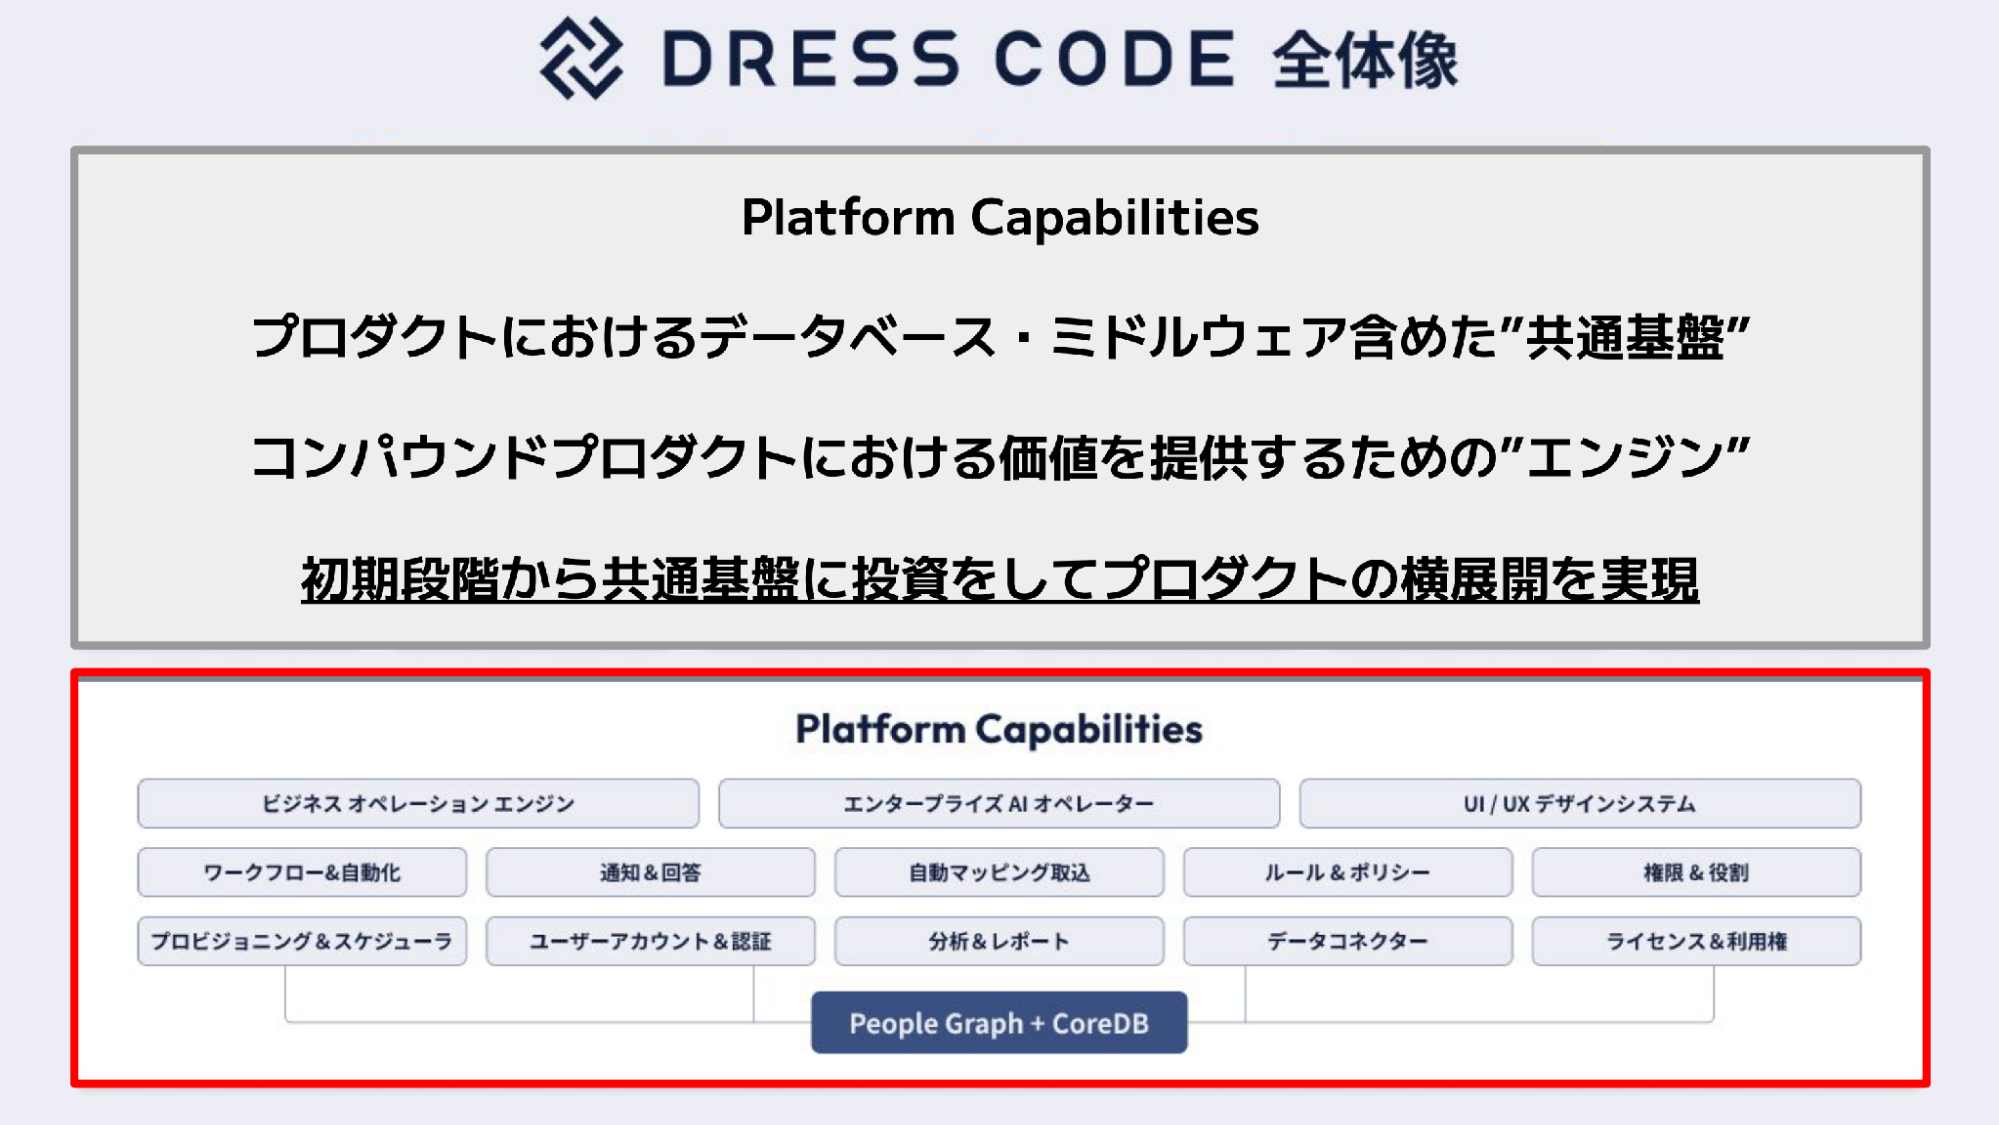
この全体像の中で僕たちが重要視しているのが、プラットフォームケイパビリティーズという基盤です。データベースやミドルウェアを含めた共通基盤、いわばプロダクトのエンジンにあたるもので、これを最初から、初期段階から投資してプロダクトの横展開を実現しているのが特徴です。
共通基盤を最初から作るというのは珍しいと思いますが、ここに最初から投資してきたのがDress Codeです。今日話すのは、この基盤の中でもPeople GraphとCoreDBと呼んでいる部分です。
CoreDBの構成——イベントソーシングとCQRSで事実を管理する
CoreDBは、Dress Codeにおける固有名詞のような基盤で、出てくる情報の信頼できる情報源にあたります。従業員をはじめ業務で使われるデータをSSoTとして管理する仕組みを、大きな基盤として作っています。各プロダクトからCoreDBが参照される形になっていて、各プロダクトでデータを分散・重複管理させず、従業員のデータもSSoTとして管理する仕組みになっています。
AIには「作る」と「働く」という2つの側面があると思っていて、SSoTはこの両方に効くものだと考えています。ここまで話してきたのはAIが作る側面で、事実があれば壊して作り直せるという考え方です。もう1つの側面が、AIが働くという話です。僕たちはバックオフィス系のSaaSを作っていますが、業務をAIに任せるためには事実がちゃんと残っていないと任せられないので、ここにも事実を残すことが効いてきます。
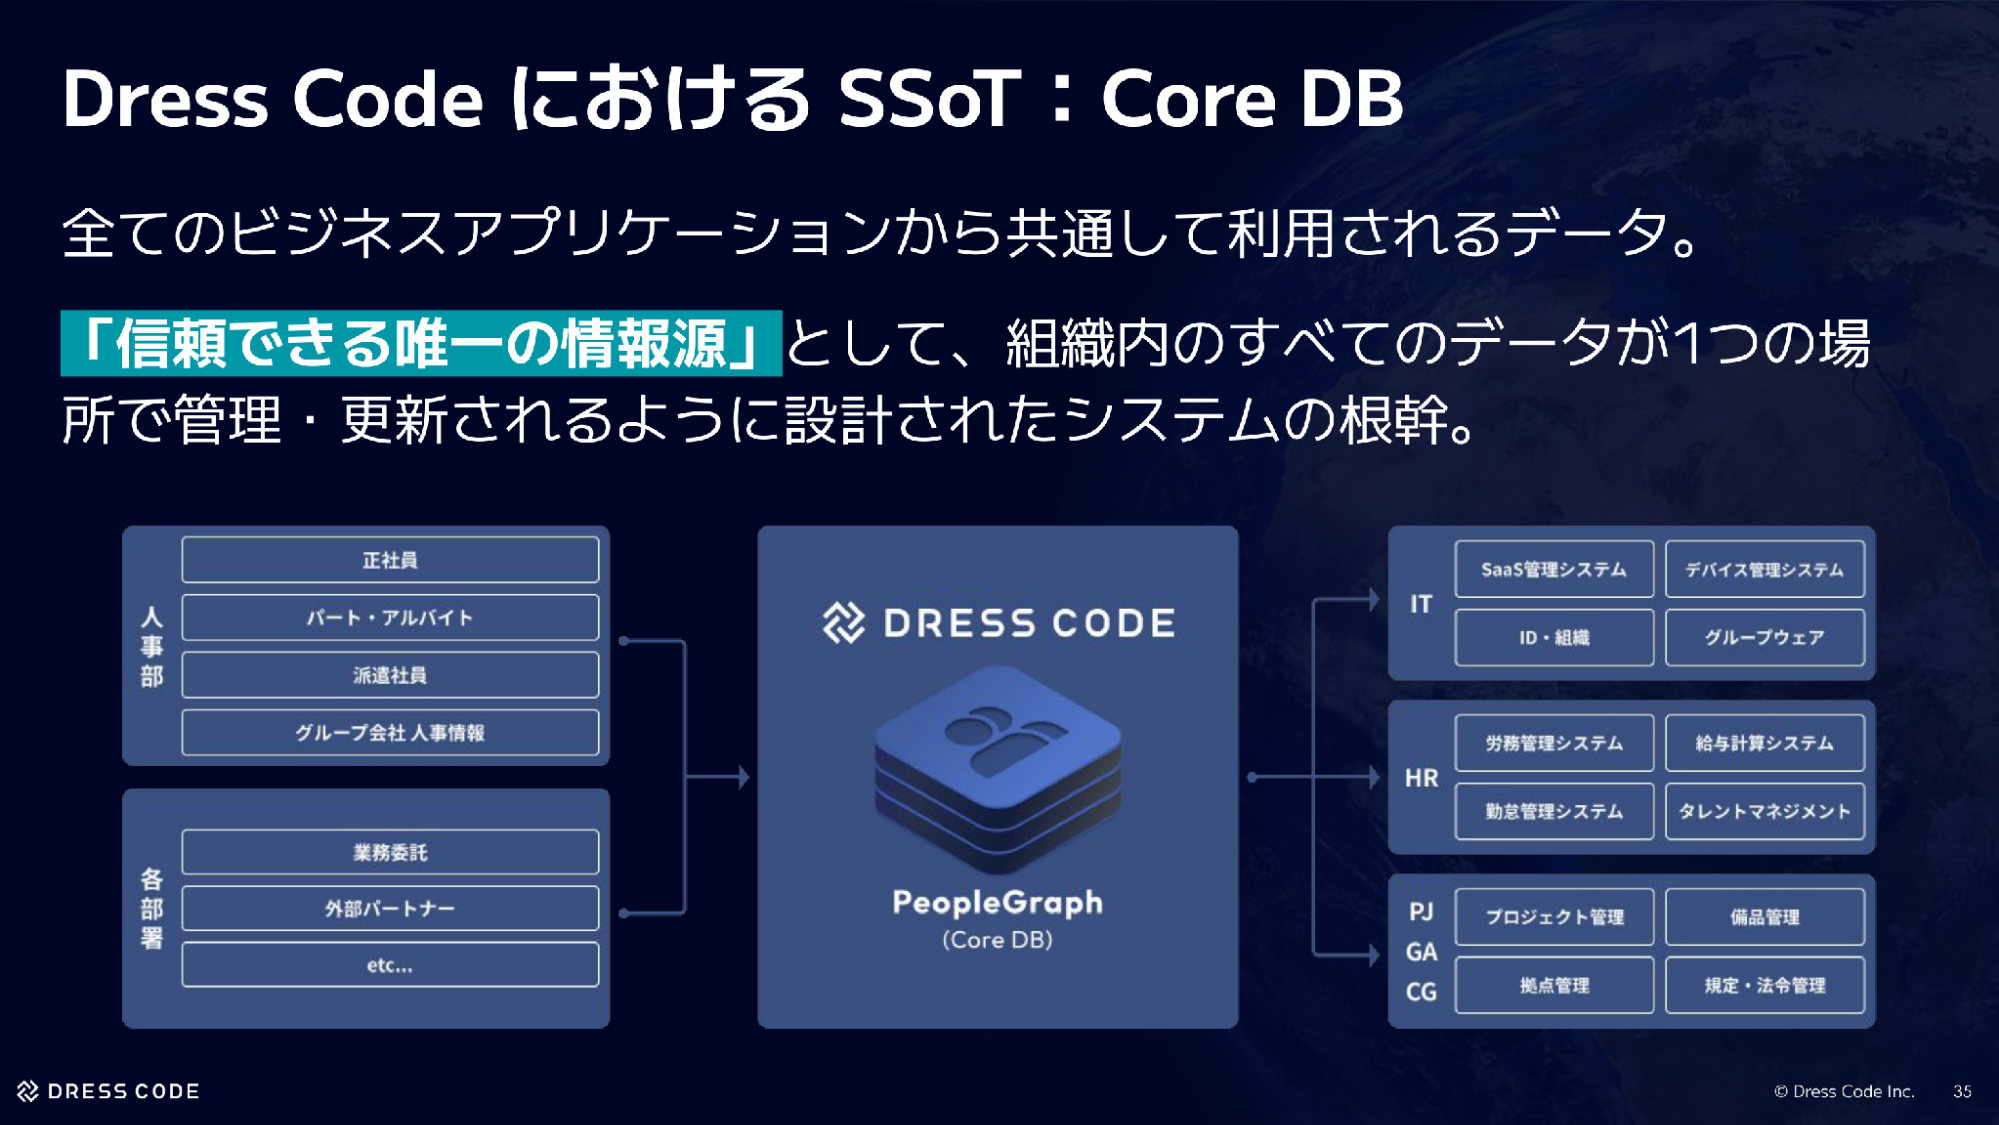
なぜSSoTな仕組みを作っているかというと、理由は3つあります。1つ目は業務自動化の土台として、ぶれない事実を作っていくことです。2つ目は、状態管理はどんどん変わっていくので、そうではなく事実を残すことで、AIの読み書きに食い違いを生まない、安全に読み書きできる仕組みにすることです。3つ目は、プロダクトを横断しても事実が一致していることです。例えば労務向けでは従業員が営業職になっているのに、給与計算では開発職になっている、といったことが起きないようにする考え方です。
CoreDBを具体的に見ていくと、大きくはイベントソーシングとCQRSで作っています。左側がコマンドで、人事部が異動を発令したといった業務における操作にあたります。それによって事実を記録するイベントストアがあり、そこに対してプロジェクションされたものが、業務で使われる状態、僕たちはグラフと呼んでいますが、そういう構成になっています。
これは従業員だけでなく、組織やデバイス、ソフトウェア、契約、勤怠、取引も含めて、SSoTとして管理するためにCoreDBに乗せています。
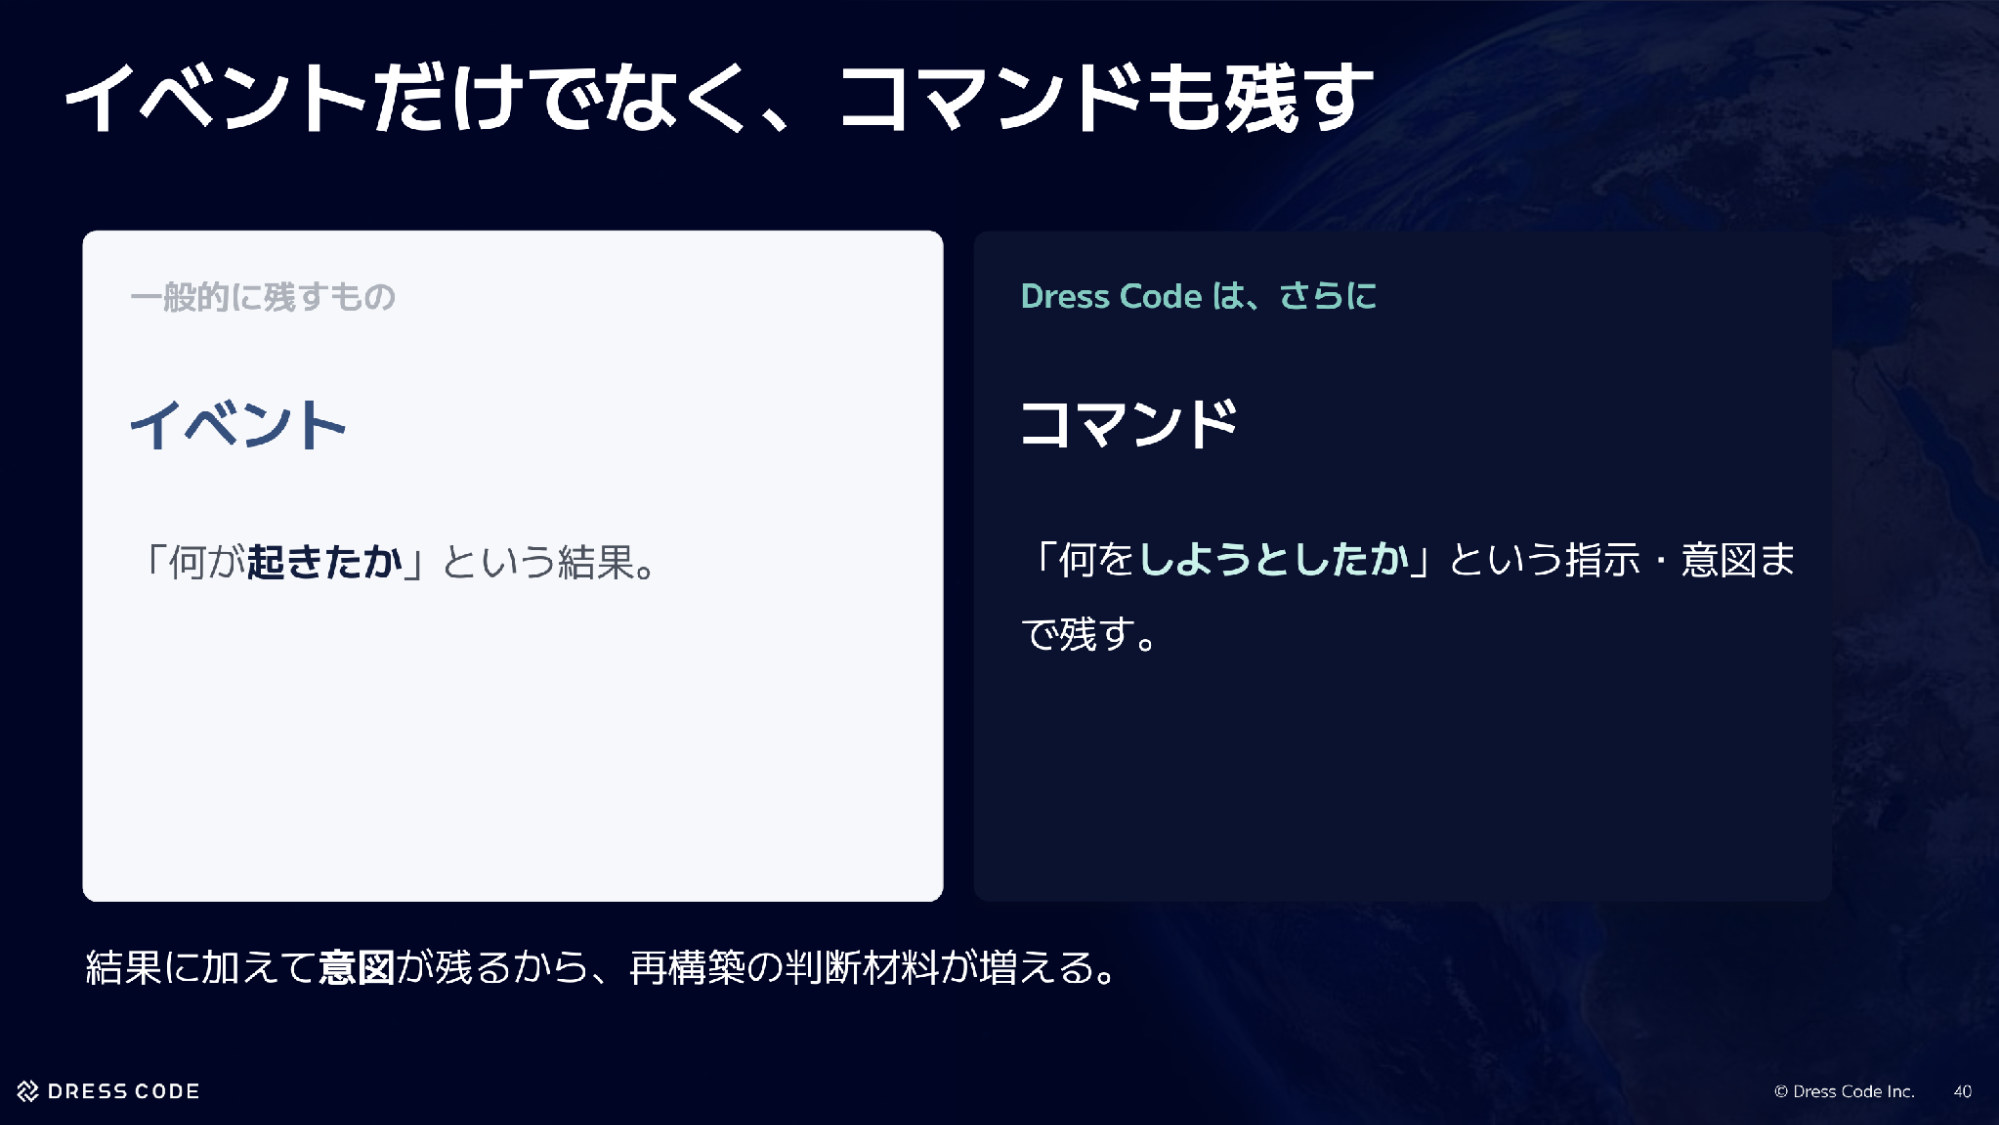
意外なところとして、イベントだけでなくコマンドも残しています。イベントは何が起きたかという結果ですが、コマンドは何をしようとしたかという指示・意図です。ここを分けて考えないと、コマンドだけが残っていてイベントがないということが起きます。例えばエラーが起きた時にイベントが取れていない場合もあるので、コマンドも残すことは意外と重要だと考えています。
CoreDBはあくまで設計思想で、実現方法はデータ特性によって変えています。アクセス系のデータはデータ量もノイズも多いので、S3に貯めてGlueで加工して状態として使えるものにしていく一方、従業員データはDynamoDBに積んで、スパイクに耐えられるトランザクションにしていくといった作り方をしています。
結局、壊して作り直すためには事実を残していくことが重要です。状態は使い捨てでいいという考え方をとっていて、リードモデルが壊れても、積み上げた事実さえ残っていれば、リハイドレートして新しい状態を再生成することが事実上できます。
この「事実上できる」という状態を作っていくことが、今の僕の設計で大事にしていることです。状態側のテーブル設計はどんどん変わっていくので、陳腐化したら躊躇なく壊していける方が楽だと考えています。
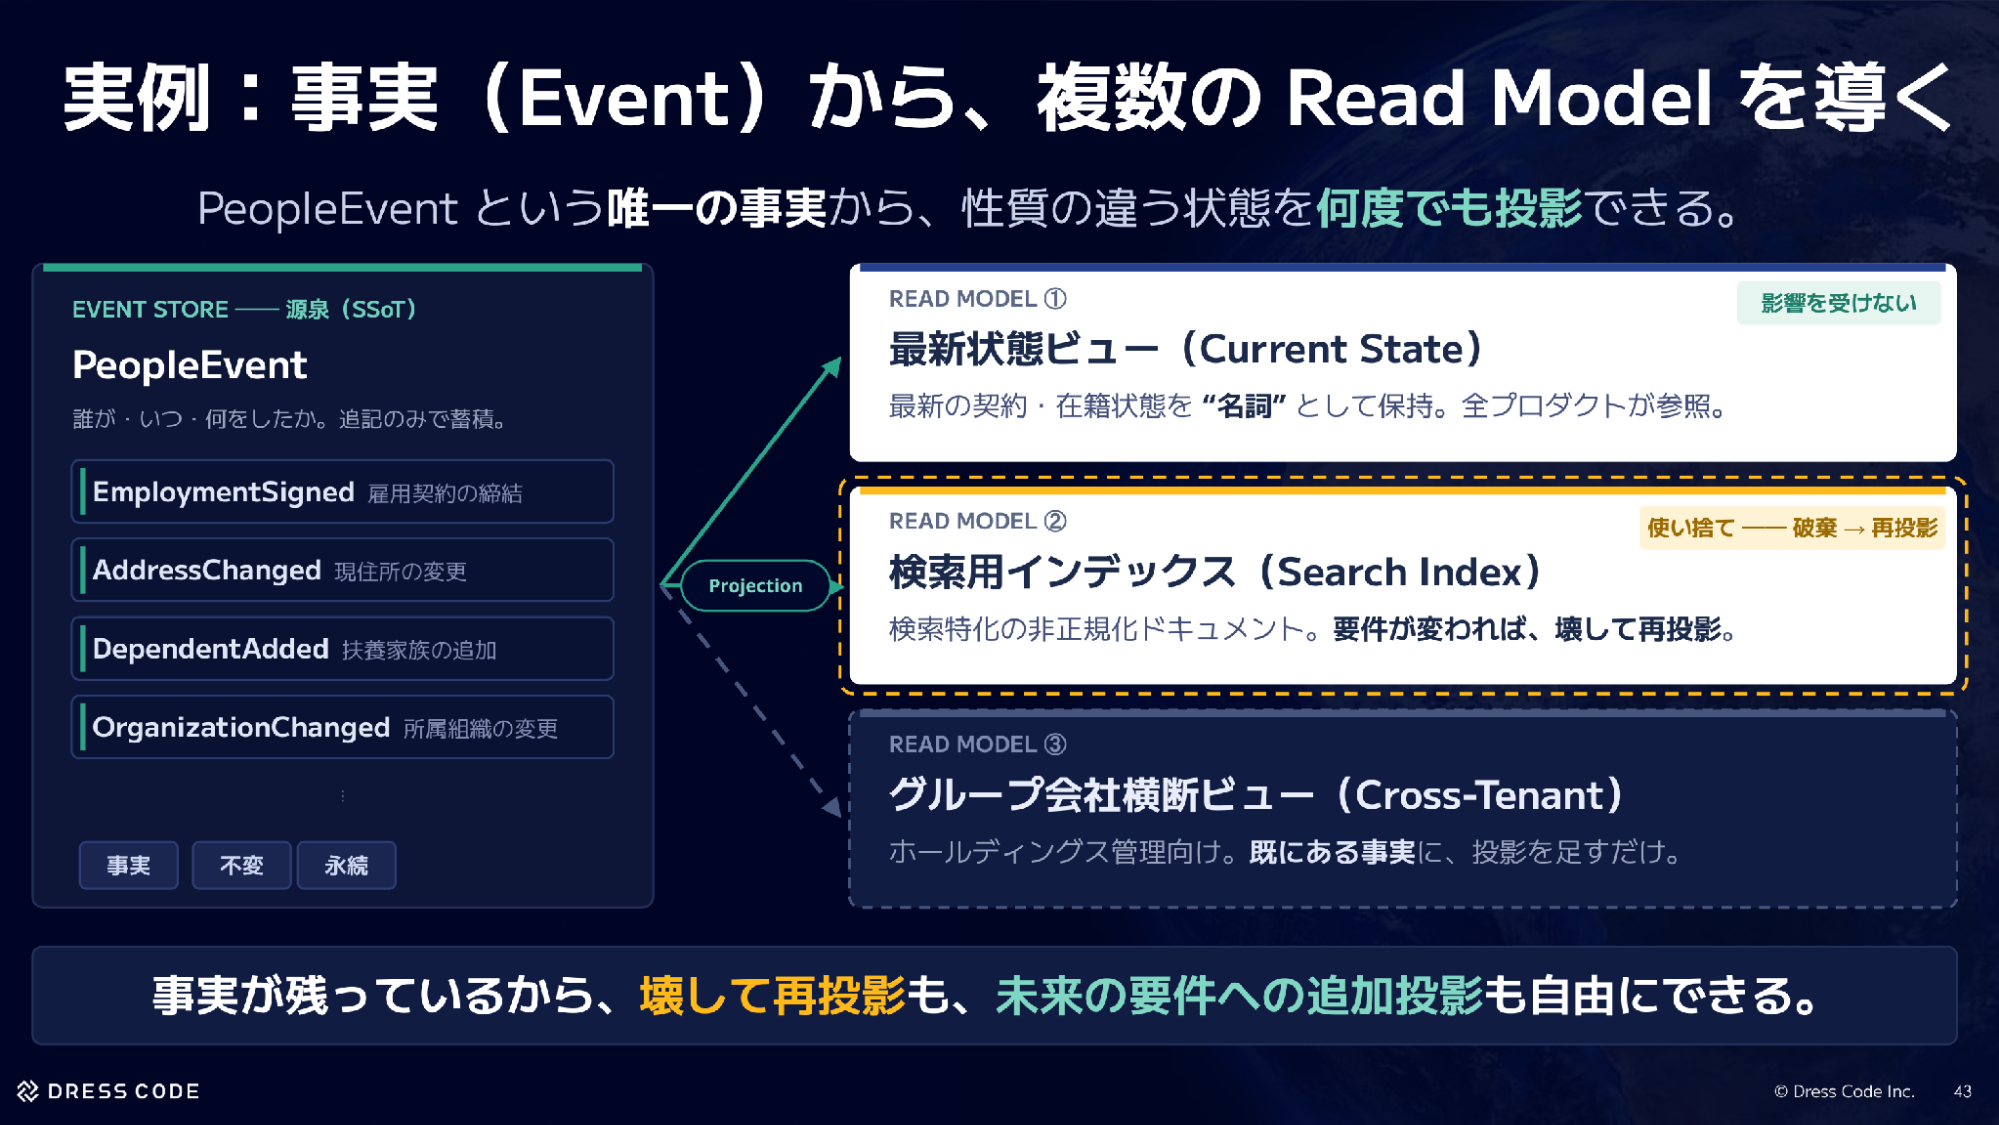
実例として、CoreDBには人にまつわるイベントを貯めていきます。雇用契約の締結、現住所の変更、扶養家族の追加といったイベントが積み重なっていき、それによって作られるリードモデルはたくさんあります。よく使われるのは従業員の最新の状態を示すビューで、ほかにも検索用に特化したインデックスや、ホールディングス向けにグループ会社をまたいで使えるビューなどもつくっています。
真ん中の検索用インデックスなどは何度も壊して、使い捨てて新しいものを作るということをやれるのもポイントです。未来の要件が追加されても投影し直せることが、イベントを残しておくことの重要な点だと考えています。
開発プロセスにも事実を織り込む——ADR・SDDという仕組み
ここからはデータではなく、開発プロセスの話をしていきます。僕たちはADRとSDD、仕様駆動開発という流れで、事実をどう残しているかという話です。これは先ほどの図で言うと、コードとアーキテクチャのレイヤーにあたる部分です。
開発プロセスに織り込む形として、まずADRを書き、SDDで仕様を作り、その上で実装していくという流れにしています。土台のアーキテクチャとしてはモジュラーモノリスやDDD、クリーンアーキテクチャを採用していて、無秩序な実装にはならない仕組みにしています。
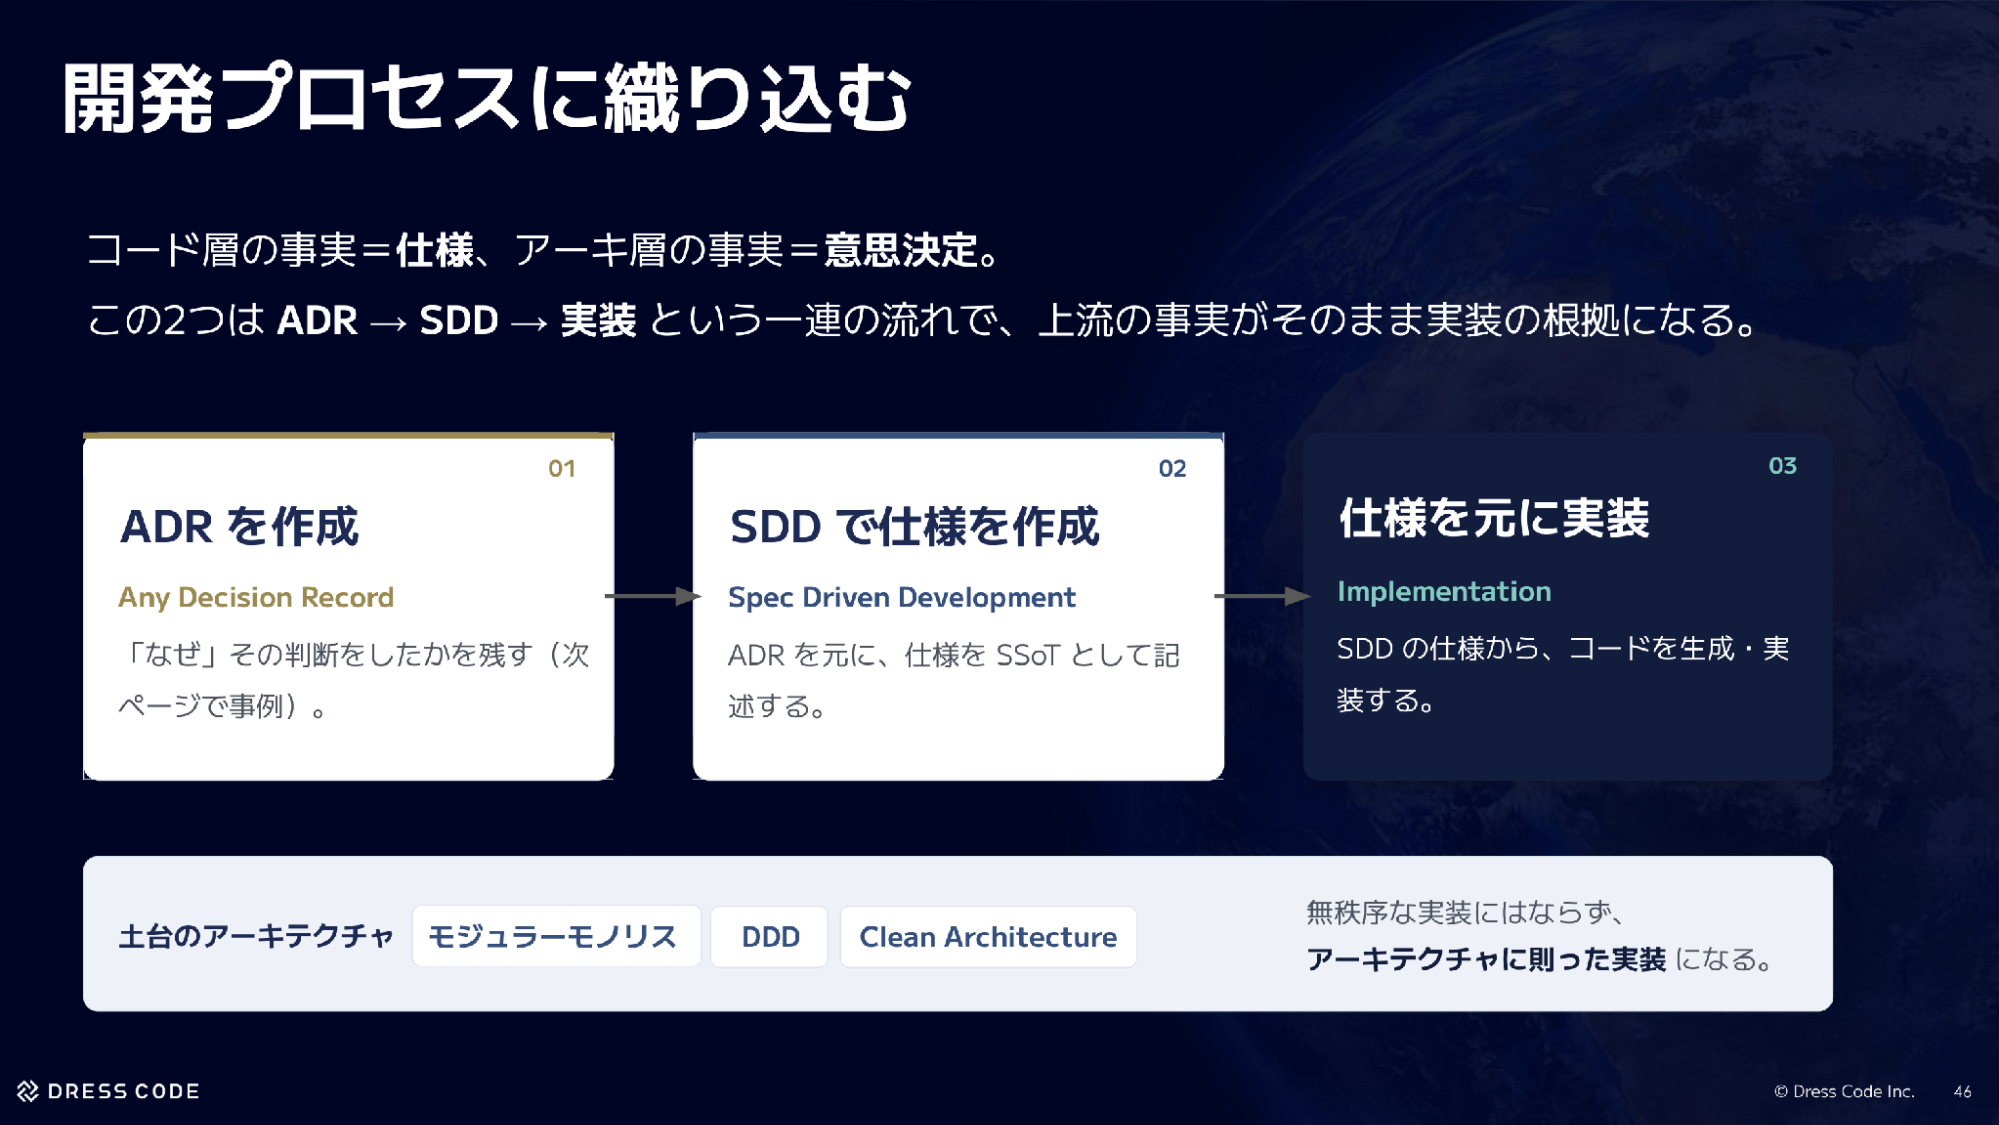
ADRについて、Dress CodeではArchitecture Decision RecordではなくAny Decision Recordと呼んでいて、領域も大小も問わず「なぜ」をすべて残す文化にしています。
基本的にNotionにどんどん貯めて、Slackで共有してフィードバックをもらい、文化にしていく。後から「なぜそうなったか」を追えるようにしていく、という考え方です。アーキテクチャのレイヤーでは、意思決定を残すということをこの仕組みで体現しています。
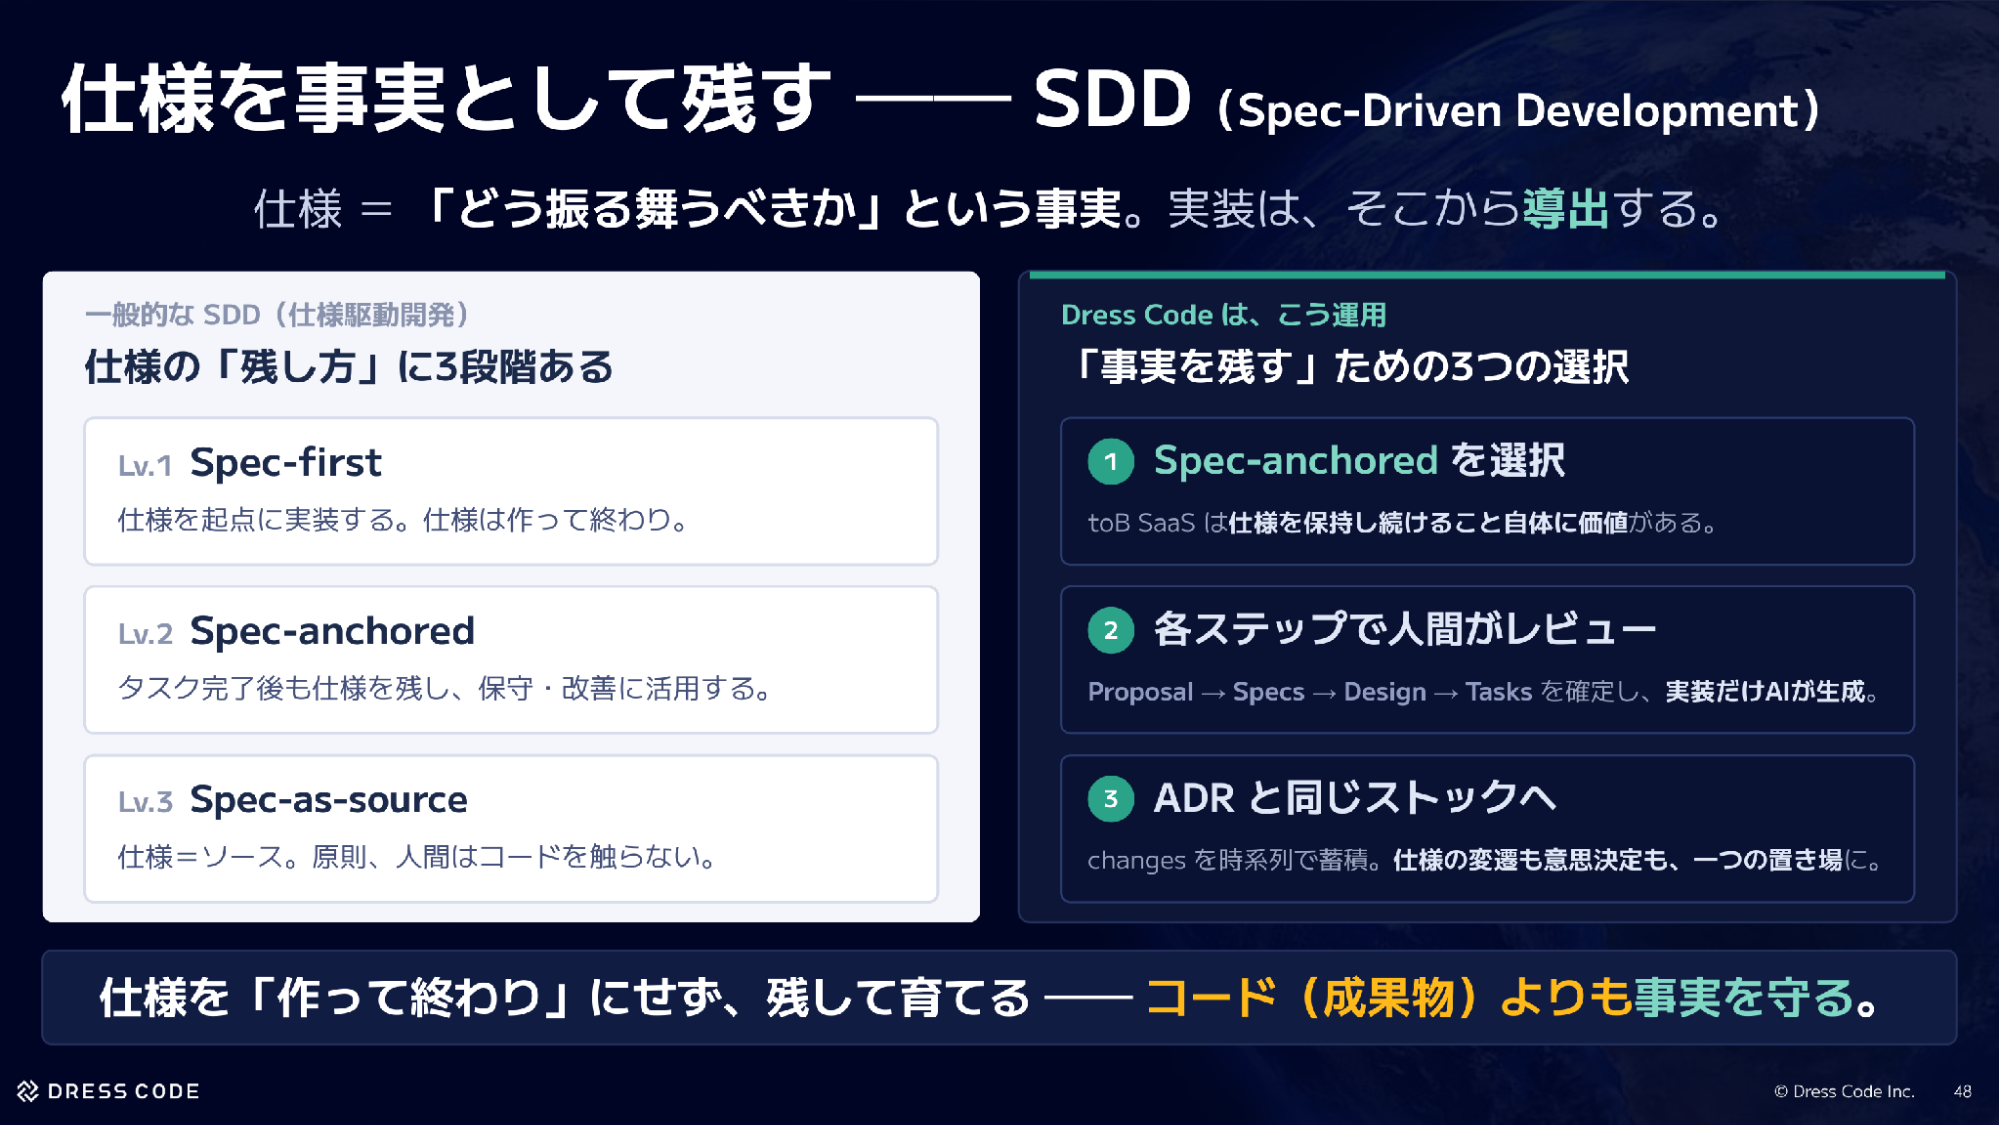
もう1つがSDD、スペック駆動開発です。仕様の残し方には3段階あり、スペックファーストやアンカード、オーソリタティブソースといった段階がありますが、僕たちはレベル2まで、アンカードした仕様をちゃんと残して、事実としてブラッシュアップしていくというやり方をとっています。ADRと同じで、事実がちゃんと残っていくことがポイントで、コードという成果物よりも事実を守ることを優先しています。
「壊して作り直せる」は万能ではない、まとめ
色々話してきましたが、壊して作り直すというやり方は万能ではなく、銀の弾丸でもないと思っています。イベントソーシングとCQRSは、運用や学習コストがかなり高いです。全システムに適用すべきというわけではなく、データ移行や整合性、ダウンタイムといった制約は現実に残ります。
この点を考えつつ、事実を残す価値が大きいところから取り組んでいくのがいいのではないかと考えています。SSoTを残すということは、すべてイベントソーシングにしましょうという話ではなく、残すべき事実をちゃんと見極めてやっていくことが本質だと思っていて、イベントソーシングはそのための1つの手段だと捉えてもらえればと思います。
冒頭の問いに戻ると、1年前の設計判断を今も正確に追いかけられますかという問いには、ADRで意思決定を事実としてすべて残しているので、「なぜ」はNotion AIに聞けば返ってくる状態になっています。
もう1つの、AIが書いたコードを半年後も自信を持って変更できますかという問いについては、もう変更するのをやめて、最初から仕様をもとに作り直した方がいいのではないか、その中でSDDのようなやり方が合うのではないか、というのが今のDress Codeの現在地です。
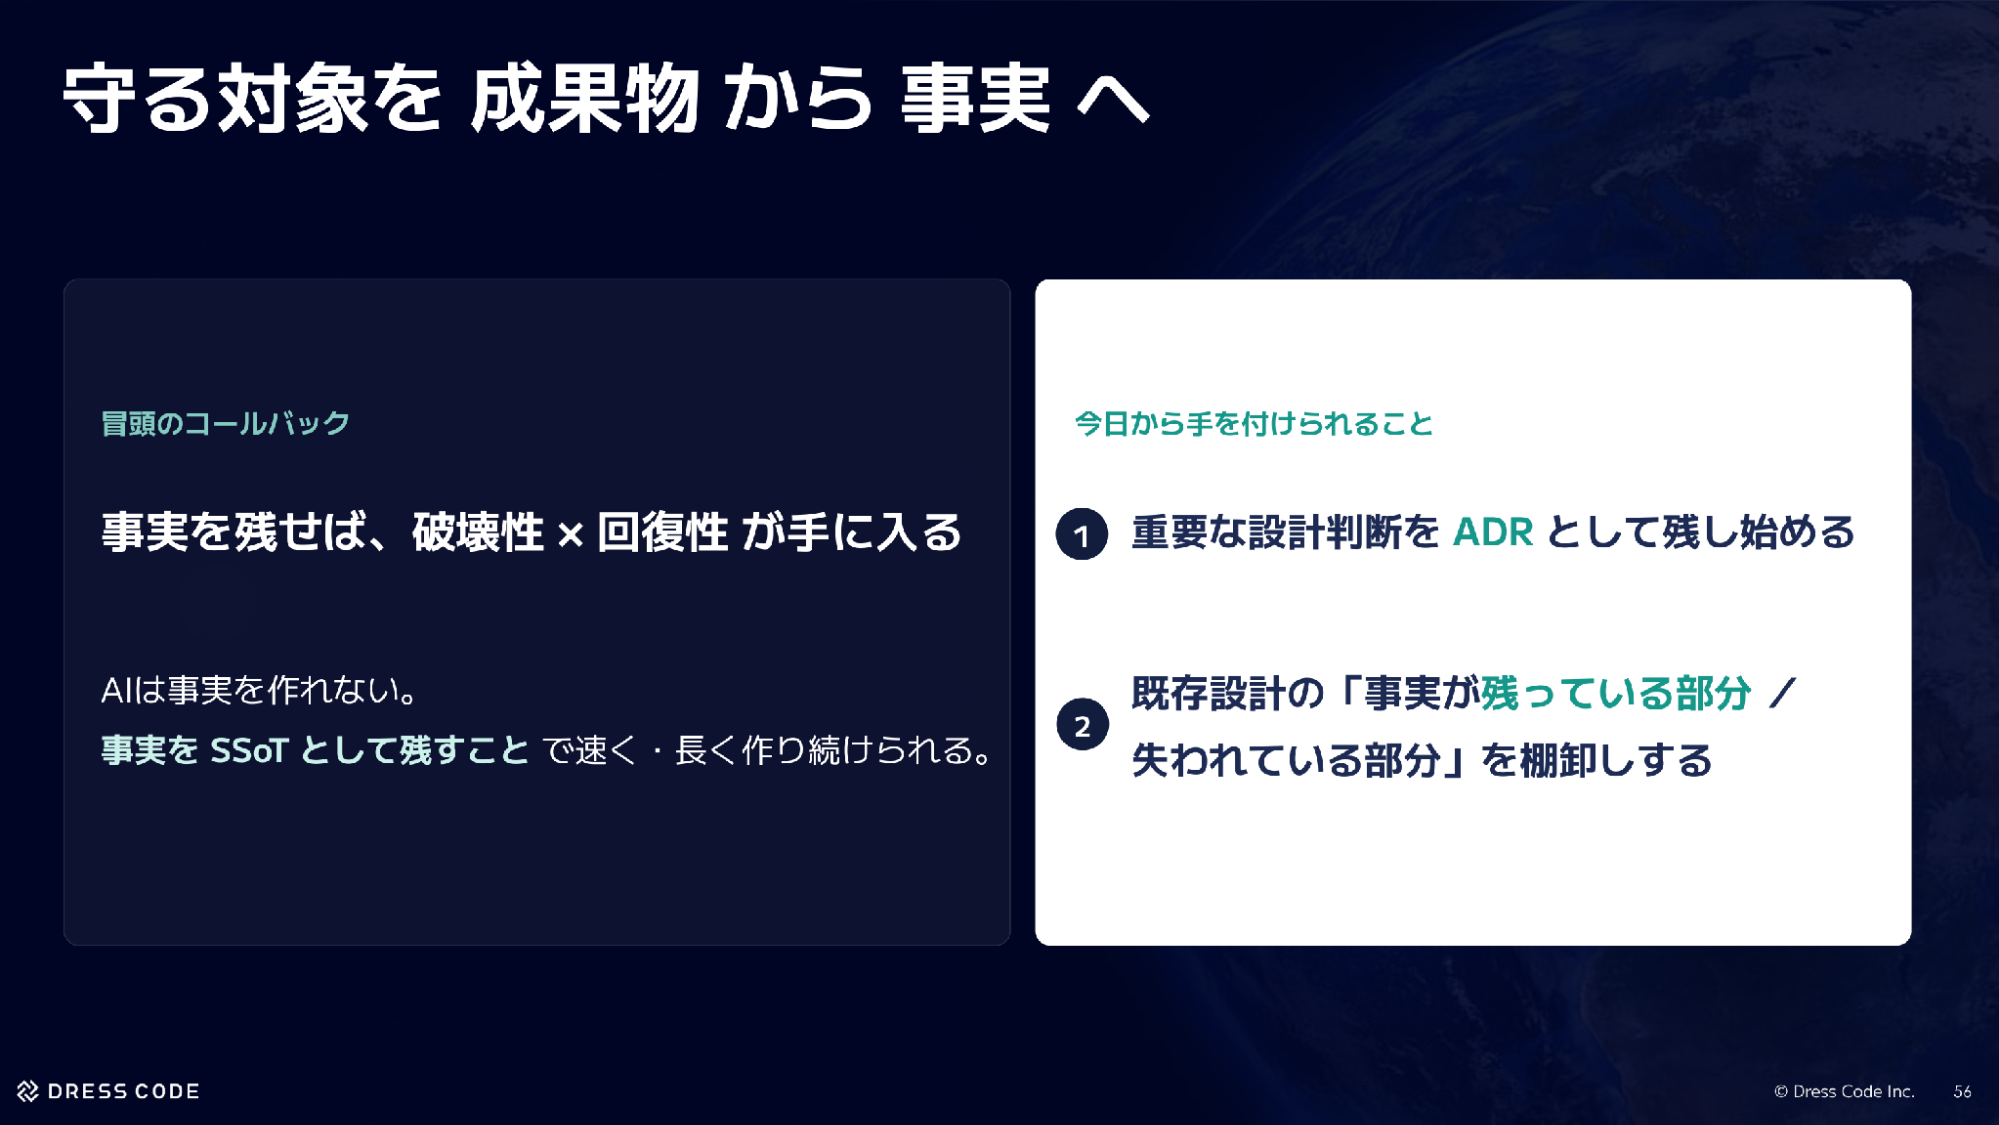
まとめです。なぜ事実を残すのか。AIは事実を作ってくれません。あくまで生成してくれるだけなので、事実をちゃんと残した上で、作り直せる状態を作っておくことが今は大事だと考えています。
AIが働く拠り所になるという意味でも、ぶれない事実を作っていくことが今後の鍵になるのではないかと考えていて、業務自動化に向けてSSoTを土台化していこうとしているのがDress Codeです。守る対象を成果物から事実に移していくことをおすすめします。
皆さんもよかったら、ADRやSSoTの中に残っている部分、失われている部分がないか棚卸ししてみて、ぜひ取り組んでみてもらえればと思います。
アーカイブ動画・発表資料
イベント本編は、アーカイブ動画を公開しています。また、当日の発表資料も掲載しています。あわせてご覧ください。
▼動画はこちら
※動画の視聴にはFindyへのログインが必要です。