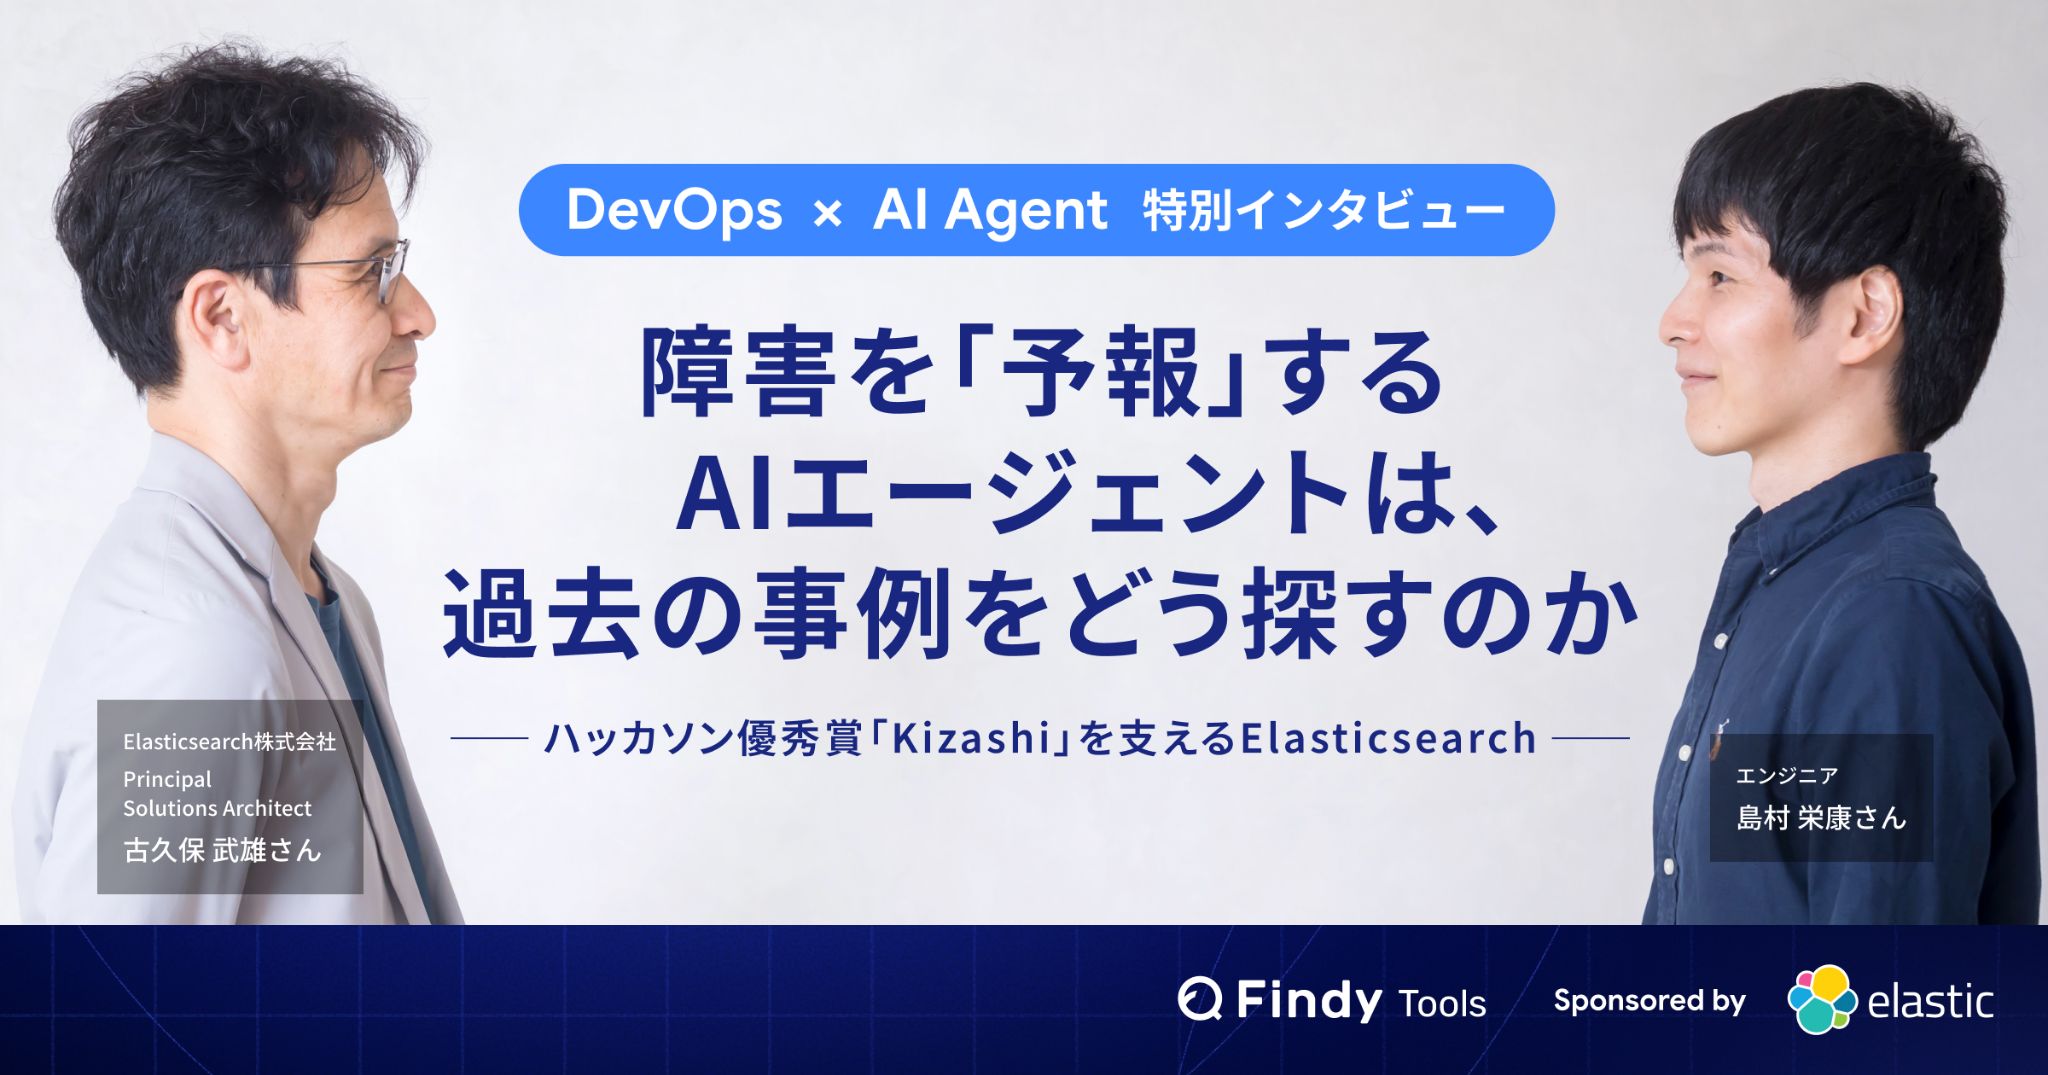
障害を「予報」するAIエージェントは、過去の事例をどう探すのか ~ハッカソン優秀賞「Kizashi」を支えるElasticsearch~
2026年8月に最終ピッチが開催された「DevOps × AI Agent Hackathon 2026」(ファインディ株式会社主催)では、二次審査を経た10チームが決勝に進みました。その中から優秀賞(3チーム)に選ばれたのが、島村さんが個人で開発したAIエージェント「Kizashi(兆し)」です。
Kizashiは、未マージのプルリクエストや負荷の予定、過去のアラートを突き合わせ、障害のリスクを事前に「予報」します。障害が起きた後の調査で、過去の障害から似た事例を探す役割を担っているのが、大量のデータから目的の情報を素早く探し出す、オープンソースの検索エンジン「Elasticsearch」です。
今回のハッカソンの大きなテーマであったAIエージェントの開発において、Elasticsearchの検索技術はどのように生かされたのか?評価されたポイントはどこにあったのか?
開発者の島村さんと、審査員を務めたElasticsearch株式会社のPrincipal Solutions Architect 古久保さんをお招きして、その開発の裏側を伺いました。
プロフィール
島村 栄康さん
エンジニアとしてシステムの保守案件で、アプリケーション開発とアラート対応を担当してきた。「DevOps × AI Agent Hackathon 2026」に個人で参加。日常業務の気づきを生かし、AIエージェント「Kizashi(兆し)」を開発。優秀賞を受賞。
古久保 武雄さん
Elasticsearch株式会社
Principal Solutions Architect
複数の外資系IT企業でプリセールスとしてソリューションの提案に携わる。2022年1月にElasticsearch株式会社に入社し、プリンシパルソリューションアーキテクトとして、アカウント営業やエンタープライズ営業とともに顧客の課題解決に取り組んでいる。「DevOps × AI Agent Hackathon 2026」では審査員を務めた。
アラート対応の手間から生まれた「予報」と、AIを使う場面の見極め
── このたびは優秀賞の受賞、おめでとうございます!まずは本ハッカソンに参加したきっかけを教えてください
島村:もともと関心のあったAIエージェント開発に、運用に携わってきた自分の業務と重なるDevOpsの切り口で取り組めて、しかも使い慣れたGoogle Cloudで開発できることに惹かれました。それまで独学でソフトウェア設計とシステム設計を学んでいて、インプットばかりが続いていたので、アウトプットして自分の理解を血肉にするよい機会だと思って参加を決めました。
── 受賞作品である「Kizashi(兆し)」は、どのような問題意識から生まれたのでしょうか
島村:私はSESとして、Google Cloud上で稼働するシステムの保守プロジェクトに携わっていました。現在は育児休暇をいただいています。
日常業務のなかで、アラートが上がった後の調査やレポートの作成にかなり手間を取られていました。これがきっかけで、自律的にアラートの原因調査やレポート作成対応を任せられるAIエージェントがつくれないか、と考えるようになりました。
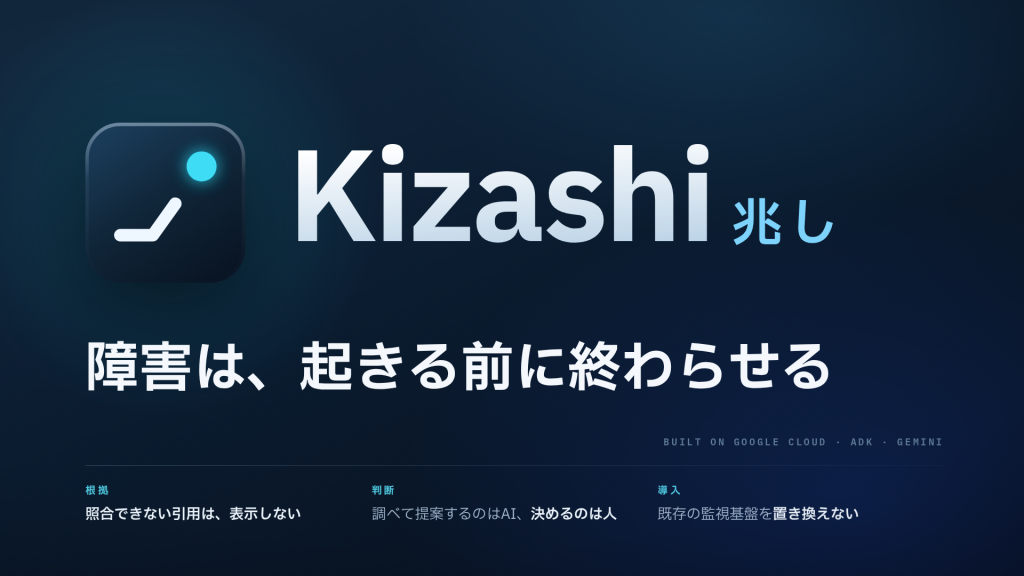
Kizashi(兆し)の作品概要はProtoPediaで公開中
古久保:普段のアラート対応で、AIは導入されていなかったのですか。
島村:はい。長い間手作業でした。ログを調べて原因を特定し、報告用のレポートを書くところまで人が回していました。私が育児休暇で担当を離れる少し前に、チームでAIを使ってログを確認する試みが始まりました。実際に触ってみて、調査そのものを自律的に任せられないかと考え、Kizashiの開発に着手しました。
ところが開発を進めるうちに「障害が起きた後の調査をAIでできるのなら、障害が起きる前にその兆しをつかむこともできるはずだ」と気づいたんです。障害が発生する前に手を打つことができれば、本番環境で実際に起きるリスクそのものを低減することができます。そこで、Kizashiの開発コンセプトを変更し、障害の兆しを捉える「予報」にメインに取り組むことにしました。
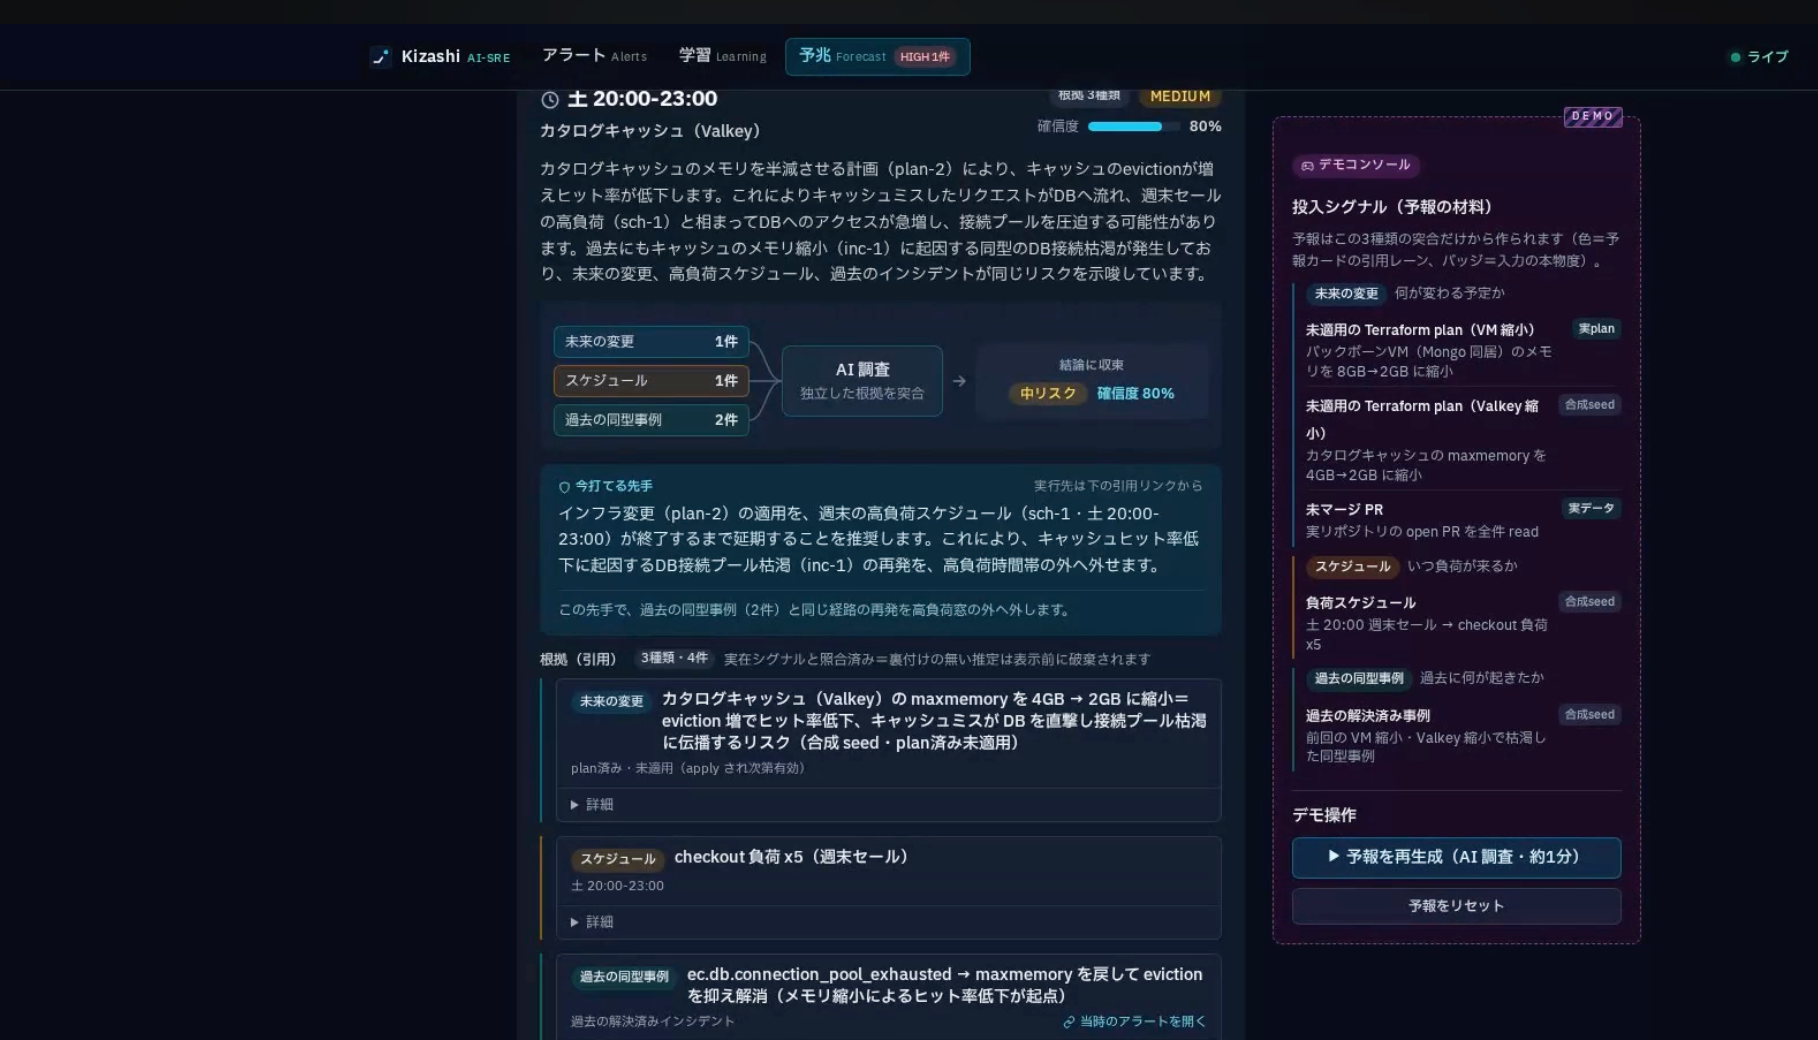
Kizashiの予報画面。未適用のインフラ変更や週末セールの負荷予定、過去の同型事例を突き合わせ、障害のリスクと確信度、今打てる先手を示す( 出典:https://www.youtube.com/watch?v=dCInLD72unU )
── Kizashiの中では、AIエージェントがどのように使われているのでしょうか
島村:Kizashiでは統括役を含めた8つのエージェントが稼働しています。
まずはじめに、届いたアラートを3つに分類します。過去に何度も起きている「既知」。既知に似た「類似」。これまでに起きたことのない「未知」の3つですね。AIエージェントを使うのは「未知」に分類されたときに限定し、統括役が追加の証拠を取りに行くエージェントや、仮説を立てて確信度を考えるエージェントなどに依頼をかけて調査を進めます。
── では既知のアラートは、どのように扱うのですか?
島村:既知の障害には、AIエージェントを使いません。既知は何度も起きていて、人が「これは決まった処理ですぐ判定してよい」と判断した障害なので、あらかじめ定義した処理で調査レポートを返すようにしています。何でもAIエージェントに任せると時間もトークンコストもかかるので、リソースを使うべきところに集中させる設計にしました。
古久保:たしかに、AIを使う場面は絞ったほうがいいですね。Elasticsearchの思想もまったく同じです。AIを開発や運用に導入する企業は増えましたが、どの企業もトークンコストに悩んでいて、決まった処理で済むところにはAIを使わない考え方が一般的になっています。
過去の障害を探す役割をElasticsearchに任せた
── Kizashi(兆し)の中で、Elasticsearchはどのような役割を担っているのですか
島村:Elasticsearchは、過去の障害の事例を探すために使っていて、出番があるのは類似と未知のアラートを扱うときです。未知のアラートでは、追加の証拠を取りに行くエージェントが、似た事例を探すときにElasticsearchを使います。
類似については、細かく分けると「準既知」と「類例」の2つがあると考えています。準既知では、Okapi BM25(検索語の出現回数や珍しさから、文書ごとの関連度を点数にする計算方法)で似ていそうな候補を取ってくるところにElasticsearchを使いました。候補が本当に似ているかを判定する部分は、Jaccard係数(2つの文章に共通する単語の割合を測る指標)を使って、自前の決まった処理で判定しています。障害名は違っても中身が似ているものを拾う類例は、兆しの次のステップです。
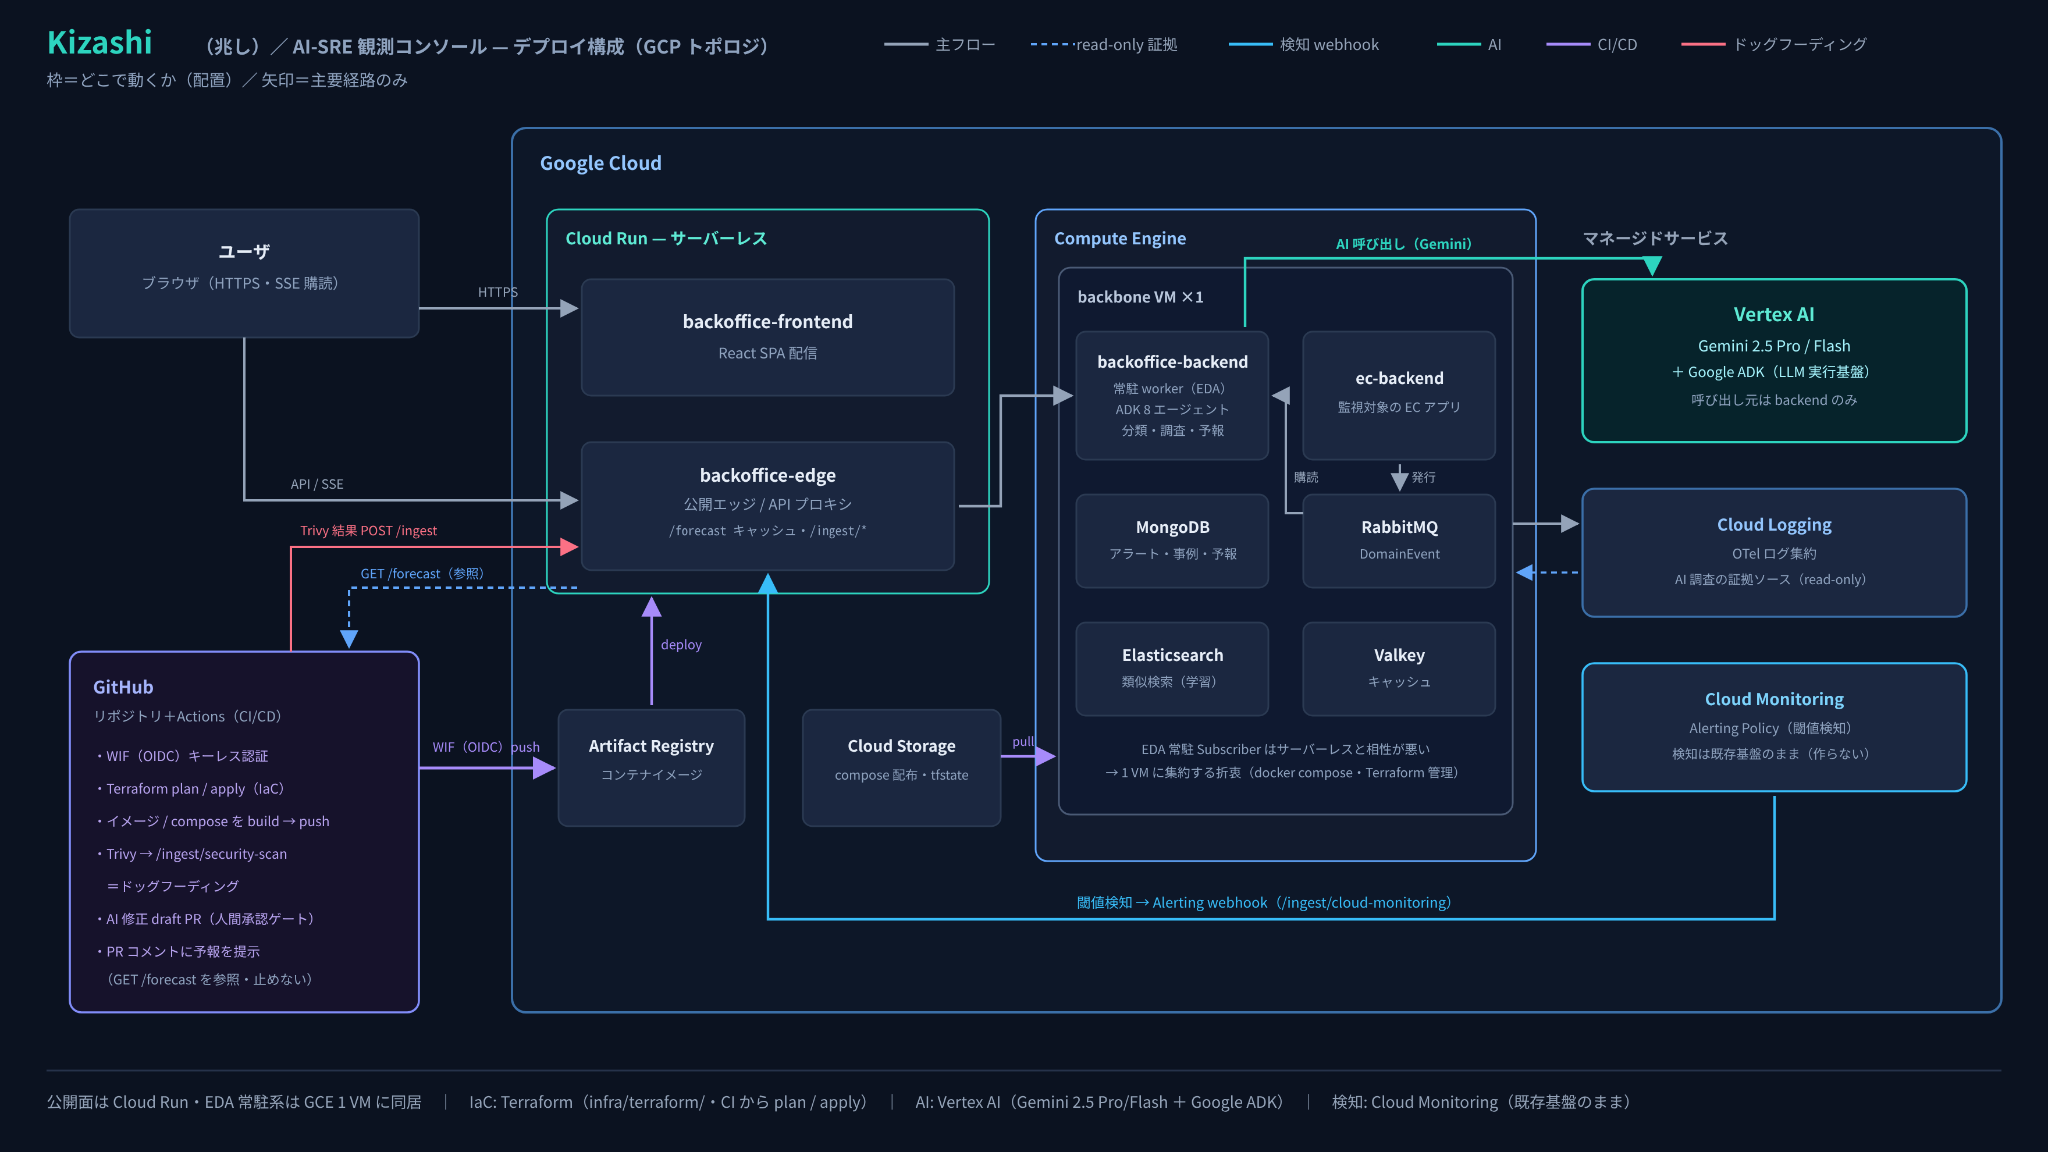
兆しのデプロイ構成。Elasticsearchは、過去の障害事例の類似検索に使われている(出典:https://github.com/nagoyamanaka/ec-monitoring-agent )
── 準既知とは、どういう状態を指すのでしょうか
島村:現場の感覚では、同じ障害が何度も起きて、毎回同じ対処で済んでいれば、次からは決まった処理で判定してよさそうです。でも1回や2回では、まだ不安が残ります。そこで、人の承認が重なって既知に昇格するまでの段階を「準既知」と呼んでいます。
── Elasticsearchを選んだ理由を教えてください
島村:既知と未知の間に類似を置くと、最初に思い浮かぶのは「似ている」「曖昧」という言葉です。Elasticsearchは検索や曖昧検索ですごく有名なプロダクトですし、ちょうどハッカソンのスポンサーでもあったので、使うことにしました。Elasticsearchを使うのは、今回が初めてでした。
古久保:初めてだったんですね。過去の障害の事例は、どのような形でElasticsearchに入れたのでしょうか。データを入れるところで苦戦はしませんでしたか。
島村:過去の障害のイベント名や、過去の調査の要約、障害がどういう原因で起きたかを、文章として入れています。いまはコーディングを支援してくれるAIエージェントがあるので、データを入れる作業は難しくありませんでした。設計の段階で、検索という抽象的な機能と具体的な実装を分けていたので、検索の実装としてElasticsearchを差し込めば使えたのはありがたかったです。
── 実装で苦労した点はありますか
島村:正直に言うと、私の知識が足りなかったところがあります。Elasticsearchが返すのは、検索結果がどれだけ関連しているかを示すスコアで、業務上、障害同士が似ているかどうかを示すものではありません。関連度と類似度の違いを知らないまま、限られた時間の中で開発を進めたので、似ているかどうかの判定は自前で組むことになりました。使ってみて初めてわかったことで、いい学びになりました。
古久保:初めて使って、短い期間でそこまで組み上げたのは見事だと思います。今回はキーワードで探すBM25を中心に使われていましたが、Elasticsearchでは、言葉の意味の近さで探すベクトル検索と組み合わせた「ハイブリッド検索」もできます。ハイブリッド検索を使えば、島村さんが自前で組んだ比較の一部も、検索側で担える可能性があります。類例の判定に進むときには、ぜひ試してほしいですね。
「探すことは、実は難しい」審査員が見たKizashiの価値
── 古久保さんは審査員として、Kizashiの設計をどう見ましたか
古久保:実務でアラート対応をされていただけあって、方向性が合っていると感じました。何よりうれしかったのは“探すことの難しさ”に気づいてもらえたことです。
多くの人は「検索はエージェントが勝手にやってくれる」と軽く見積もりがちです。でも、アラートのデータが100件なら似た事例を探せる可能性はあっても、それが1万件、100万件になったときにはそうも行きません。まさに検索の技術が非常に重要になってくるんです。
しかもKizashiのようなシステムでは、「未知」の障害を誤って「類似」に分類すると、以降の処理が変わり、システム全体に大きな影響を与えてしまいます。似た事例の候補を探す機能をAIに頼ったり、自分でつくったりせず、Elasticsearchを使った慧眼には感服しましたね。
── Elasticsearchは検索エンジンとして広く使われていますが、ほかにどのような使い方があるのでしょうか
古久保:Elasticsearchは、データの収集・変換・出力を行うETLツールであるLogstash、可視化するKibanaと組み合わせた「ELK Stack」(現在の名称はElastic Stack)として、ログの検索や集約にも古くから使われてきました。
ログのデータをElasticsearchに入れ、Kizashiのように障害のデータベースも入れておけば、両方をまとめて検索できます。ログと障害の事例を合わせてAIエージェントに渡せば、より解像度の高い判断ができるはずです。
Kizashiはまさに、Elasticsearchを使ってほしいところで使ってくれましたが、障害の事例にログも加えてもらえたら、さらにその性能を発揮していただけたはずですね。
── AIエージェントの開発で、Elasticsearchを活用するメリットはどこにあるのでしょうか
古久保:AIはGoogle Cloudがどう動くかという一般的な知識は持っていても、Google Cloud上でどんなシステムを組み、どんなデータが流れているかは知りません。AIに判断させるには、いまどういう状況なのかを教えてあげる必要があるのですが、100万行のログをそのまま渡すことはできません。
島村:AIに渡すデータの量は、Kizashiの開発でも悩んだところです。データを取りすぎると、トークンが増えて時間もお金もかかりますし、AIがどれを重視すべきか絞り切れなくなります。AIエージェントに渡す前に、必要なデータをどれだけ絞り込めるかが大事だと感じていました。
古久保:おっしゃるとおりです。関係ないデータまで入ると、AIはノイズに引っ張られて、おかしなことを言い出します。AIがノイズに惑わされないようにするには、正しい検索を実行し、しかも速く出すテクノロジーが必要なんです。
優秀賞の先に見据える「狼少年問題」
── ハッカソンに参加して、開発に対する考え方は変わりましたか
島村:最優秀賞を目指していたので、優秀賞はうれしかった一方で、悔しさも残りました。ただ、一番の収穫は、何を作るかと、どう作るかを一緒に考えるようになったことです。
今回は開発を進める中で、作品のテーマが「障害が起きてから現場を楽にする」から「障害が起きる前に終わらせる」へ変わりました。手を動かしながらプロダクトを進化させ、ユーザーに価値の高いものを届ける姿勢が大切だと、いまは考えています。
古久保:審査員の視点でも、Kizashiはコンセプトがよく、デモもよくできていてわかりやすかったですね。私以外にも推していた審査員がいて、優秀賞は納得の結果でした。
島村:ありがとうございます。ただ決勝の質疑で、誤検知が多すぎると予報が信用されなくなる「狼少年」の問題を古久保さんに指摘されたときは、痛いところを突かれたと思いました(笑)。予報を受けて手を打ち、障害が起きなかった場合、予報のおかげなのか、もともと起きなかったのかを見分けられないからです。そこで、予報を出したのに対処しなかった事例を対照群にすれば精度を測れるのではないかと考え、Zennの記事にまとめました。今は精度を測る第一歩として、出した予報を記録するところから実装を進めています。
── 最後にお二人から、AIエージェントの開発やハッカソンに挑戦するエンジニアに向けてメッセージをお願いします
島村:ハッカソンのように第三者に見てもらうと、社内とは違う視点で反応がもらえます。私も古久保さんの指摘をきっかけに、自分のサービスをどうよくするかを考え直せました。客観的に評価してもらう機会は、キャリアを考えるうえでも大切なので、ぜひハッカソンに挑戦してみてほしいです。
古久保:今回のハッカソンで審査をしていて感じたのは、インターネット上で公開されている情報だけを引用して完結する作品は、汎用的な生成AIとの違いを示しにくいことです。実際に審査していても「これGeminiやChat GPTでよくない?」と感じた作品がたくさんありました。
そういった意味で、今後開催されるAIを活用したハッカソンでは「作品そのもののコンセプト」はもちろん、「その会社や現場にしかないDomain-Specific Data」を活用していくことが重要になるのではないでしょうか。
そんな時はぜひ、Domain-Specific Data の中からAIに渡すものを絞り込むときの選択肢の一つに、Elasticsearchを入れてほしいですね(笑)。膨大なデータの中からAIが必要とするデータを絞り込むことは、私たちが一番得意とすることですから。