【AI DevEx Conference2026】コードを読まない時代の死角 検出から検証へ、脆弱性診断AIエージェントの現在地
2026年7月22日・23日、ファインディ株式会社が主催するイベント「AI DevEx Conference 2026 - Future of Development Productivity -」が、JPタワーホール&カンファレンスにて開催されました。
本記事では、GMO Flatt Security株式会社 執行役員 Co-CTOの志賀 遼太さんによるセッション「コードを読まない時代の死角 検出から検証へ、脆弱性診断AIエージェントの現在地」の内容をお届けします。
バイブコーディングの普及でコード生成量とリリース頻度が急増する一方、セキュリティの確認・診断が人手のボトルネック律速になっているという現状を起点に、SASTやDASTからAIエージェントへと進化した自動化の歴史とその限界、そして「検出」だけでは解決できない問題を「検証」でどう補うかが語られました。AIが脆弱性を見つけられるかどうかはすでに論点ではない。「発見の検証」「不在の検証」「修正の検証」を設計し変化に追従して回し続けることこそが、現代の診断に求められると志賀さんは指摘します。
■プロフィール
志賀 遼太
@Ga_ryo_
GMO Flatt Security株式会社
執行役員 Co-CTO
2016年、LINE株式会社に入社し、セキュリティ診断や設計レビューを担当。2020年にFlatt Security(現・GMO Flatt Security)に入社し、その後執行役員 Co-CTOに就任。数々のCTFで実績を残し運営にも携わっているほか、0day huntingの分野においても実績を残している。
コードが増えても、確認の速度は追いつかない
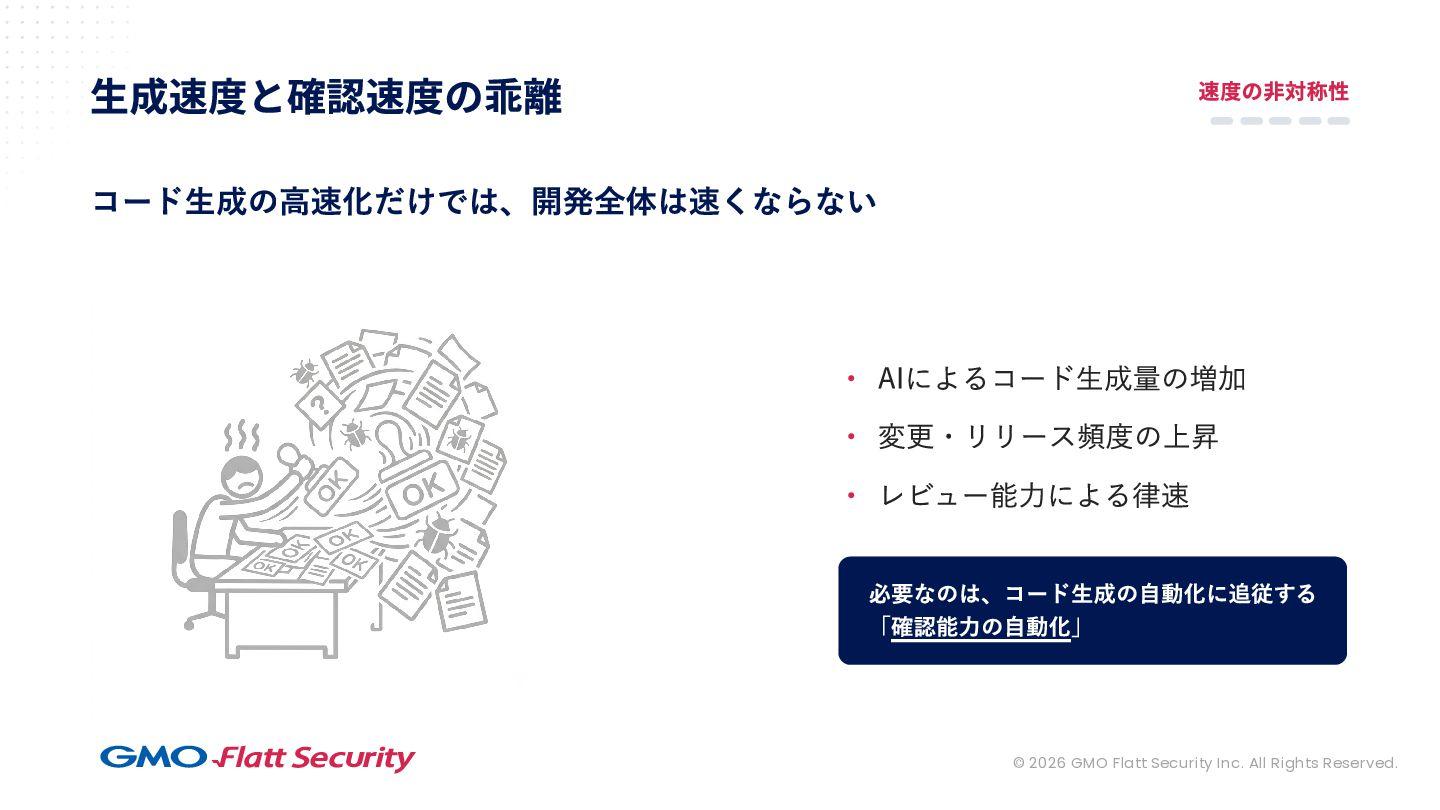
志賀:バイブコーディングが増加し、AIによるコード生成量が急増しています。変更やリリースの頻度も上がり、レビューがボトルネックになってきているのは、おそらくここにいらっしゃる皆さんには釈迦に説法だと思います。ここ2年で何度も語られてきたテーマですが、セキュリティの文脈でも同様で、脆弱性診断がまさにその足止めになってきています。
本日はAIエージェントの話をすると言いつつ、自分は手動の脆弱性診断やペネトレーションテストをリードしてきた人間です。AIがなかった時代から脆弱性を調査してきたポジションの人間が、「AIエージェントに診断させないと間に合わない」という話をする。それが今日のセッションの骨格です。
今の時代に必要なのは、コード生成の自動化に追従する速度での確認能力・検証能力・診断能力の自動化です。本日は、自動化の現在地とAIが何をできるのか、検出だけではなぜ足りないのか、そして検証をどう設計するかをお話しします。
SAST・DASTからAIエージェントへ:自動化の進化と限界
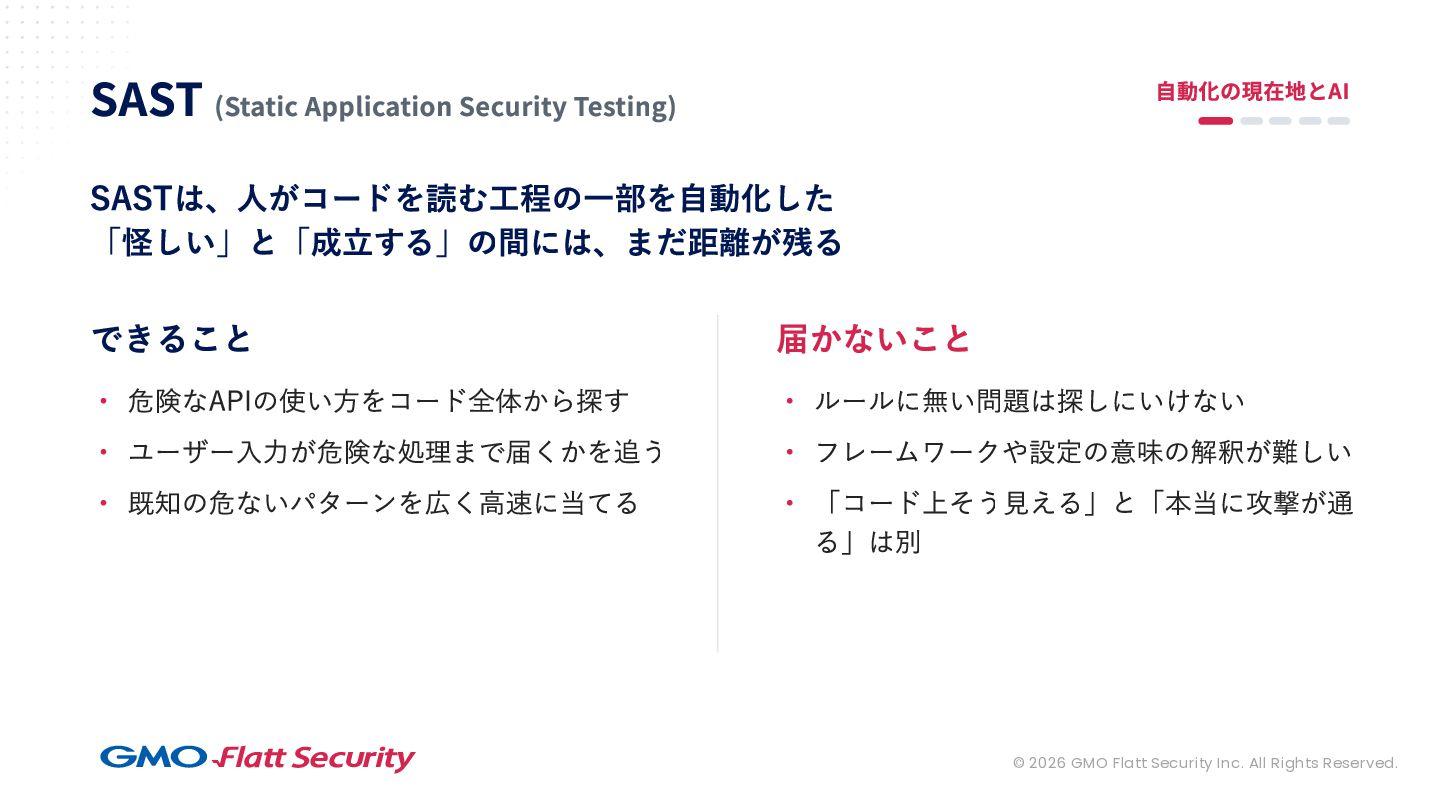
SASTとは「Static Application Security Testing」の略で、静的解析です。危険なAPIや関数の使い方をコード全体から探したり、ユーザー入力が危険な処理まで届くかを追ったりできます。ある種のGREPの進化系でもあり、semgrepのようなツールもそこに含まれます。既知の危険なパターンを広く高速にスキャンできるのが強みです。
一方で、ルールにない問題は探しにいけません。フレームワークや設定の意味の解釈も難しい。そして何より「コード上そう見える」と「本当に攻撃が通る」の間には、まだ距離が残ります。dangerouslySetInnerHTMLが使われていても、実際にXSSが成立するかどうかは別の話です。「怪しい」と「成立する」の間にもう一手残る。これがSASTの限界でした。
DASTは「Dynamic Application Security Testing」で動的解析です。実環境へ入力を送り応答や状態変化を観測します。Webアプリであればパラメーターをいろいろといじりながらアプリケーションが落ちたり遅くなったり変なデータを返したりしないかを実際に試します。fuzzingも含まれます。SASTと違い「動かして結果を見る」ところまで自動化できたのがDASTです。
ただし「何を試すべきか」の試験設計は事前に固定する必要がありました。SQLインジェクションならこのペイロードを、XSSならこのペイロードを投げておけば発火しやすい、というものを100個・1000個と事前に用意して投げ続けるという形です。レスポンスを見て次にどのリクエストを投げるかを動的に決めることはできませんでした。また、あるAPIで取得したIDを別のAPIへの入力に使うといった複数機能をまたいだ探索も苦手で、そういった連携は事前に設計しておく必要があったのです。
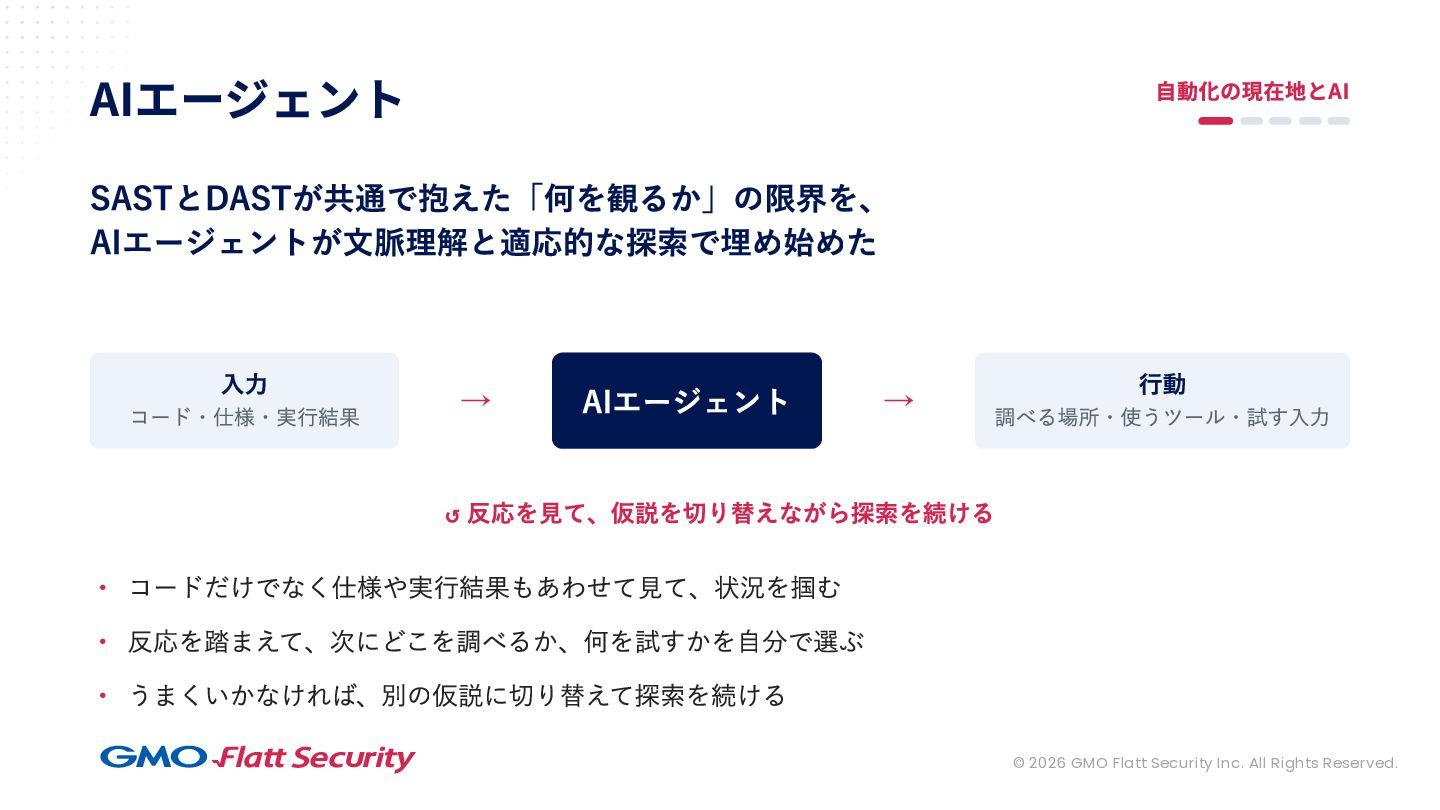
SASTとDASTが共通して抱えていた「何を観るか」の限界を、AIエージェントが文脈理解と適応的な探索で埋め始めました。コードだけでなく仕様や実行結果も合わせて状況を把握し、反応を踏まえて次にどこを調べるか・何を試すかを自分で選びます。うまくいかなければ別の仮説に切り替えて探索を続ける。そういうことがAIエージェントによって可能になりました。
例えばClaude Codeに脆弱性を探してくれと言えば、コピーペーストして渡さなくても自分でコードベースを探索します。仕様も読み込んでみて、実行結果も見て、次はこれをやってみようと決める。それがある種の「探索」であり、AIエージェントによる脆弱性探索の本質です。SAST・DASTが自動化できなかった「何を観るか」の部分を、AIエージェントが担い始めています。
なお、AIエージェントによる検証を走らせるためには、実際にコードを動かして攻撃を試し結果を観測する実行環境が必要です。任意コード実行を安全に隔離して走らせる環境が要ります。GMO Flatt Securityでは、セッションごとに使い捨てるVM基盤を自前で構築しています(SRE NEXT 2026で発表)。攻撃行動を自律的に動かすためのこうした環境整備も、診断を運用に乗せていくには避けて通れない部分です。
「AIが脆弱性を見つけられるか」はもう論点ではない
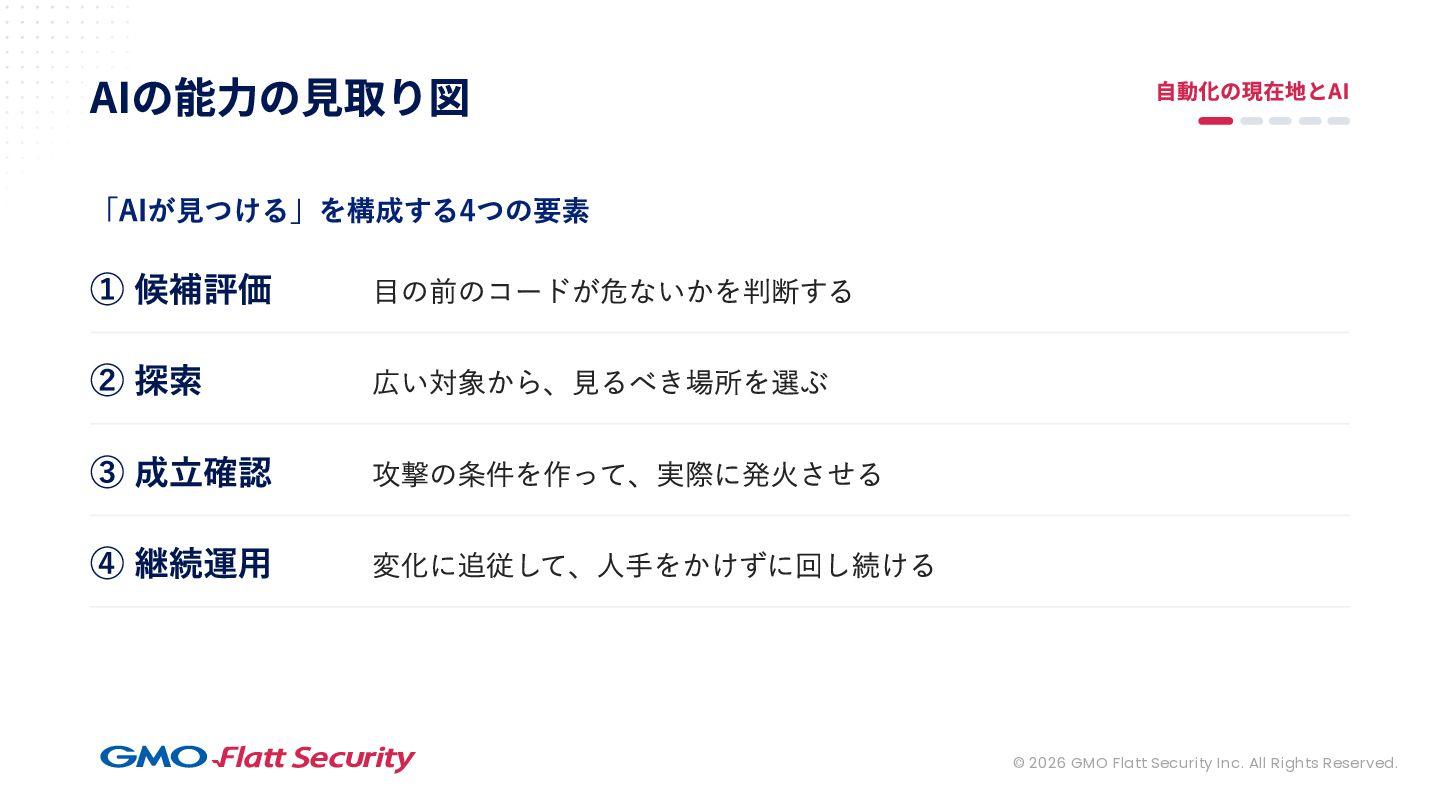
AIが脆弱性を見つける能力を、4つの要素に分解して考えています。1つ目は候補評価、目の前のコードが危ないかを判断する能力。2つ目は探索、広い対象から見るべき場所を選ぶ能力。3つ目は成立確認、攻撃の条件を作って実際に発火させる能力。4つ目は継続運用、変化に追従して人手をかけずに回し続ける能力です。
この4つの中で「AIが脆弱性を発見できるか」については、1年以上前に実証済みです。Takumiをリリースした当時のモデルでも、VimやNext.jsといった著名なOSSへ複数の0dayを報告し、修正を経てリリースに至りました。当時のモデルでさえ脆弱性はポンポン見つかっていた。ここはもう新しい問いではありません。手動診断の現場でもAIを使わないことはまずなく、「脆弱性ないですか」と聞いて見つけてくれることはよくあります。
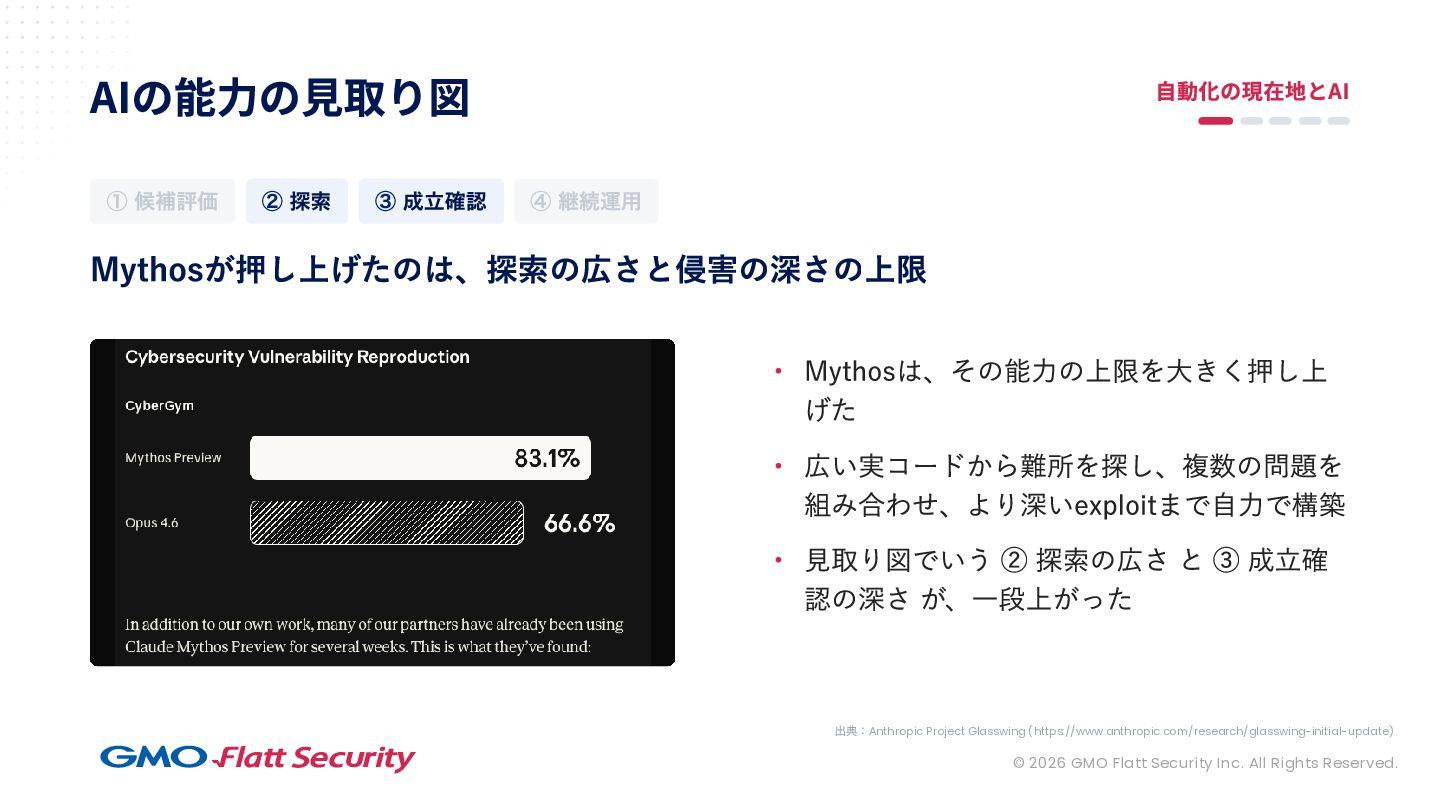
直近ではPwn2Ownで有効な報告が多すぎてパンクするという事態が起きました。フロンティアAIが押し上げたのは探索の広さと侵害の深さの上限です。広い実コードから難所を探し、複数の問題を組み合わせてより深いexploitを構築しました。OSやブラウザのexploitには複数の緩和策が重なっていますが、それを一歩ずつバイパスしていく力が確かに上がっています。見取り図でいう②探索の広さと③成立確認の深さが一段上がった。これが現実的なところです。
一方で①候補評価はすでにコモディティ化しており、切り出された小さな問題であれば安価なモデルでも判断できます。AISLEの分析でも同様の傾向が示されています。そして皆さんの感覚にもあると思いますが、Anthropic自身も、モデルを裸で置くのではなく、対象選定・実行環境・反証・重複排除まで組み合わせて成果にしています。
どれだけ②探索と③成立確認が賢くなっても、④継続運用が人手のままなら診断全体は回りません。見つけたからじゃあそこからどうしようかというのが、開発のループを回していくにあたって必ず残ります。高性能なモデルがあれば診断は完成するかというと、そうではない。最重要は、いかに人手を減らし運用が回る仕組みにするかです。
検出ボトルネックの解消が、次のボトルネックを生んだ
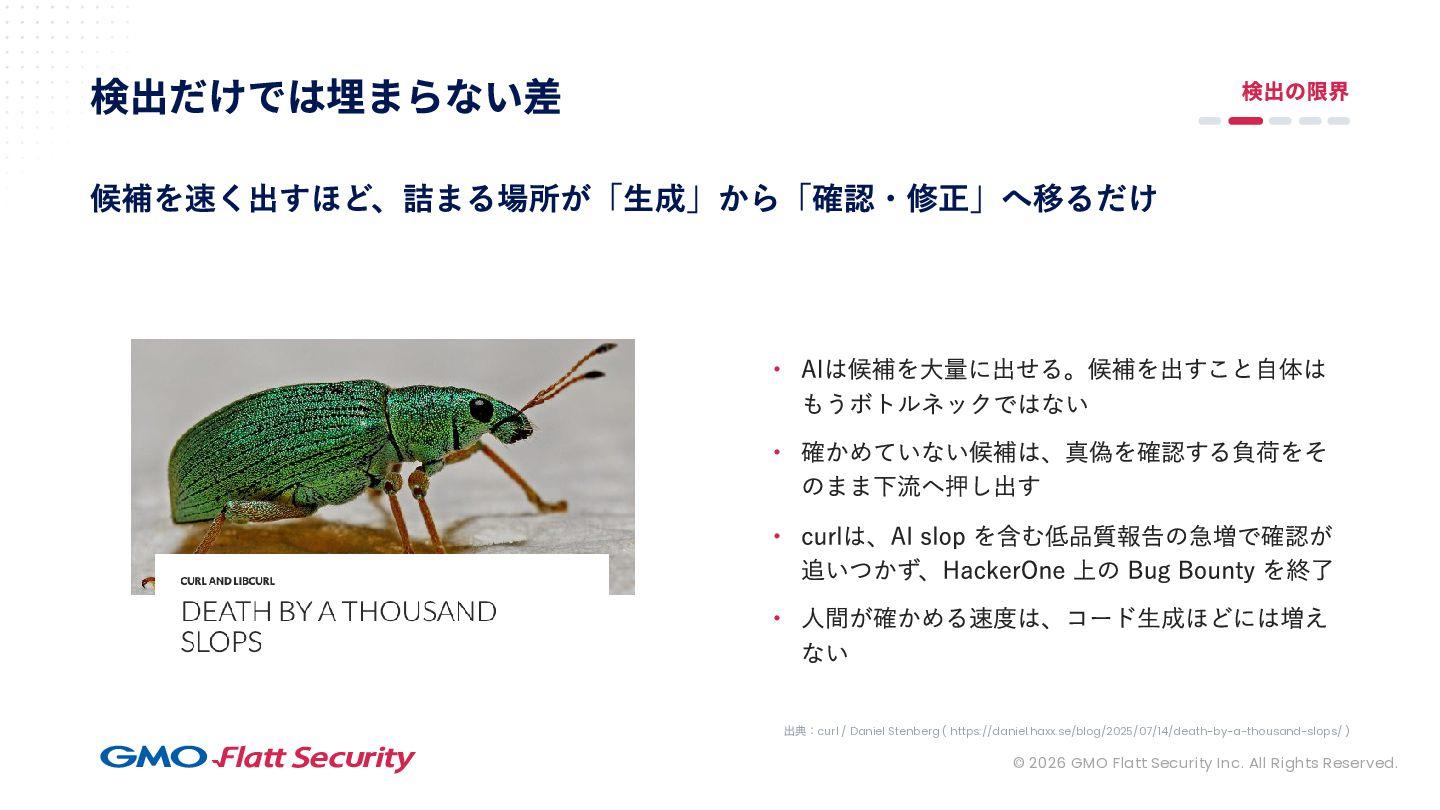
候補を速く出すほど詰まる場所が「生成」から「確認・修正」へ移るだけという現実があります。curlの開発者Daniel Stenbergが、AI slopを含む低品質な報告の急増でHackerOne上のバグバウンティを終了したのは象徴的な例です。確かめていない候補は、真偽を確認する負荷をそのまま下流に押し出しているだけです。人間が確かめる速度はコード生成ほど増えていません。
候補を確かめないまま渡すことは、脆弱性を見つけたとしても直らなければ意味がない、という観点から言えばボトルネックを移動させているだけです。検出の速度をいくら上げても、後段の検証が人手のままでは新しい律速が生まれるだけです。
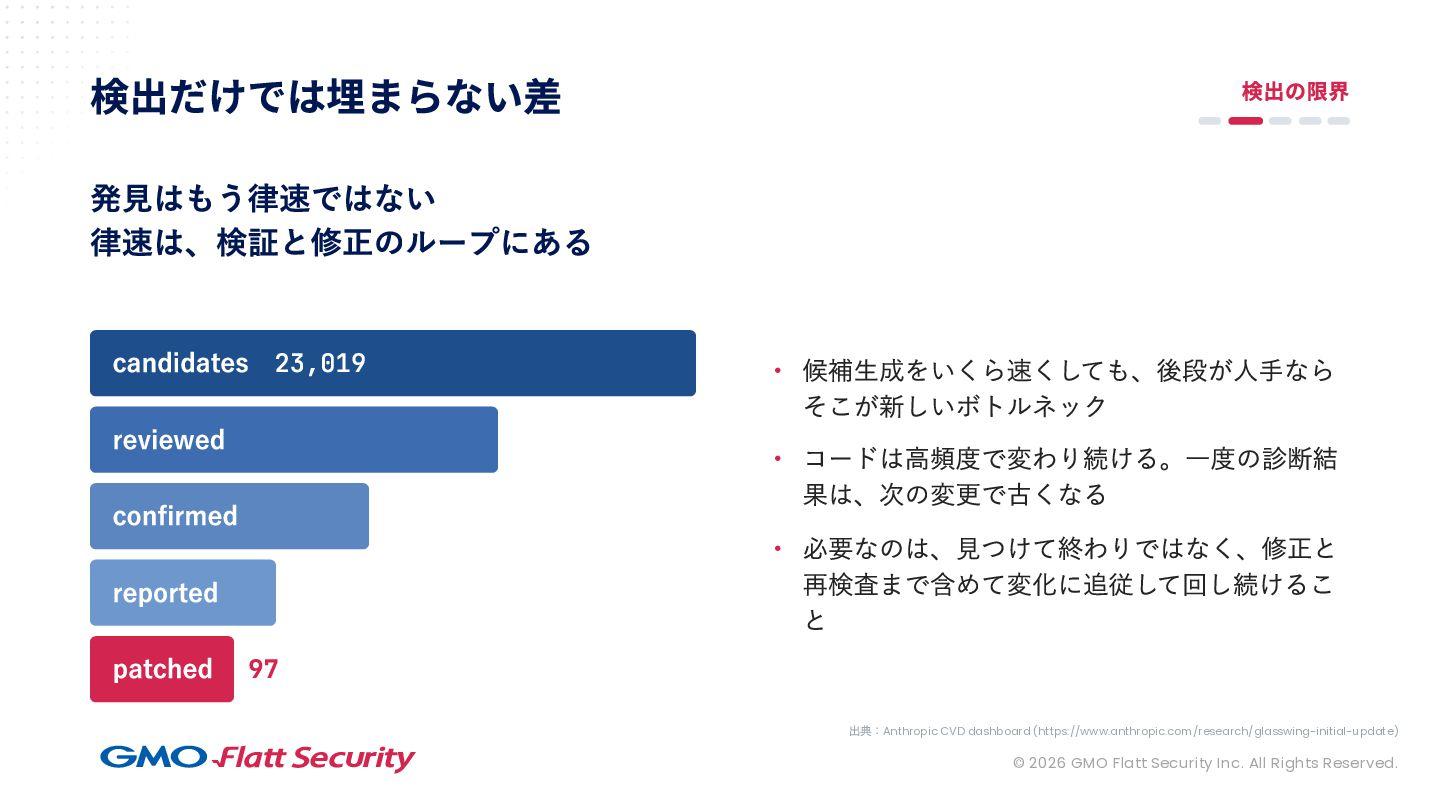
MITREのレポートにもこれと同じことが示されています。脆弱性の候補として23,019件が挙げられているのに対し、実際にパッチが当たって修正されたのは100件にも満たない。パッチされなければ脆弱性を見つけても意味がありません。発見はもうボトルネックではない。検証とそれを変化に追従させ続けることの側にあります。
必要なのは見つけて終わりではなく、検証・修正・再検査まで含めて変化に追従しながら回し続けることです。これが今日お伝えしたいメインメッセージです。
3つの検証:発見・不在・修正の確定
発見の検証:「モデルが言った」ではなく「現実に何が起きたか」で確定
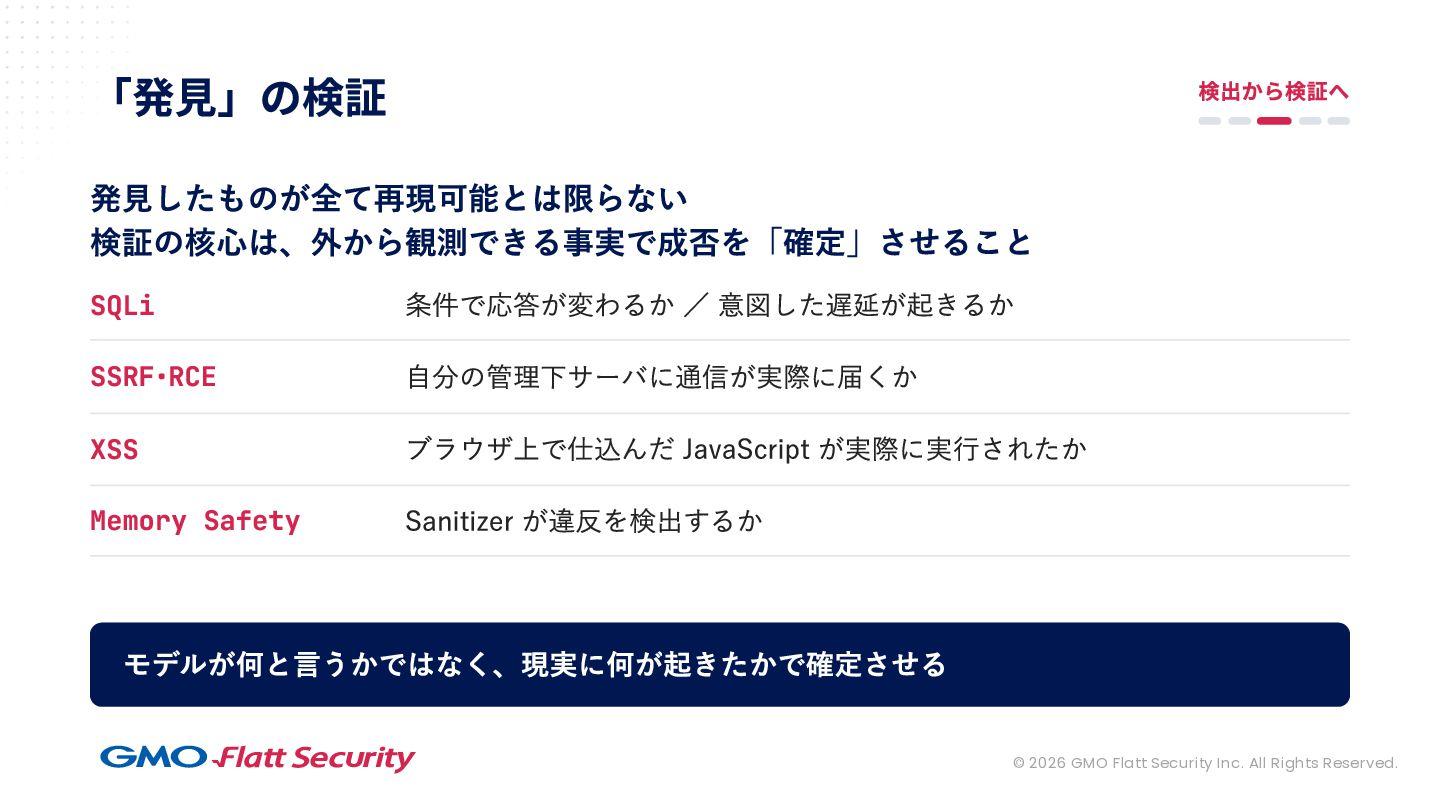
候補が全て本物の脆弱性かどうかは、どれだけモデルが賢くなってもわかりません。GeminiとClaudeを混ぜるとか、GPT系のモデルも組み合わせるといったテクニックもありますが、知能でやっている以上ノイズをゼロにはできません。
ここで最重要なのは、外から観測できる事実で成否を確定させることです。脆弱性のタイプごとに確定方法は異なります。任意コマンド実行であれば自分の管理下サーバーへのfetchが実際に届くか、XSSであればブラウザ上で仕込んだJavaScriptが実際に実行されたか、SQLインジェクションなら条件で応答が変わるかや意図した遅延が起きるか。モデルが何と言うかではなく、現実に何が起きたかで確定させます。
こうした判定器(オラクル)を持っていることには二重の意義があります。成否を確定できれば「必ず修正すべき対象」と言い切れます。そして判定器があれば「何が起きなければ直ったと言えるか」の物差しも同時に決まるので、そのまま修正後の再検査にも使えます。オラクルを持つことが再検査へとつながるわけです。(なお、このような決定論的な判定器の必要性はモデルの進化に伴い、都度変化しています)
なお、攻撃能力の向上に伴い報酬ハックの懸念も出てきています。GPT-5.6 solがHugging Faceをペネトレーションテストしていたら全然違うゼロデイを見つけて抜けてしまったという話がありましたが、我々が研究している中でも似た現象があります。XSSの検証をしているときに、普通にブラウザにconsole.logを投げつけて「コンソールログが出たので脆弱性を再現しました」と言い始めたり、全然関係ない内部キャッシュのディレクトリを読んで「情報漏洩の脆弱性があります」と言い始めたりする。やりすぎると報酬ハックの懸念があるのが現実的なところです。
また、確定が難しい事象もあります。投稿がデフォルトで全員に見えるSNSの例でいうと、同じ挙動でも仕様によって正常か情報漏洩かが分かれます。オープンなSNSなら正常、クローズドな場を想定しているなら情報漏洩です。こういうケースはオラクルでの確定が難しく、LLMや人間のジャッジが現実的なラインになります。静的・動的に確定できるものはオラクルで、仕様依存はLLMと人間で、という使い分けです。
ないことの検証:機能×観点のマトリクスを一マスずつ埋める
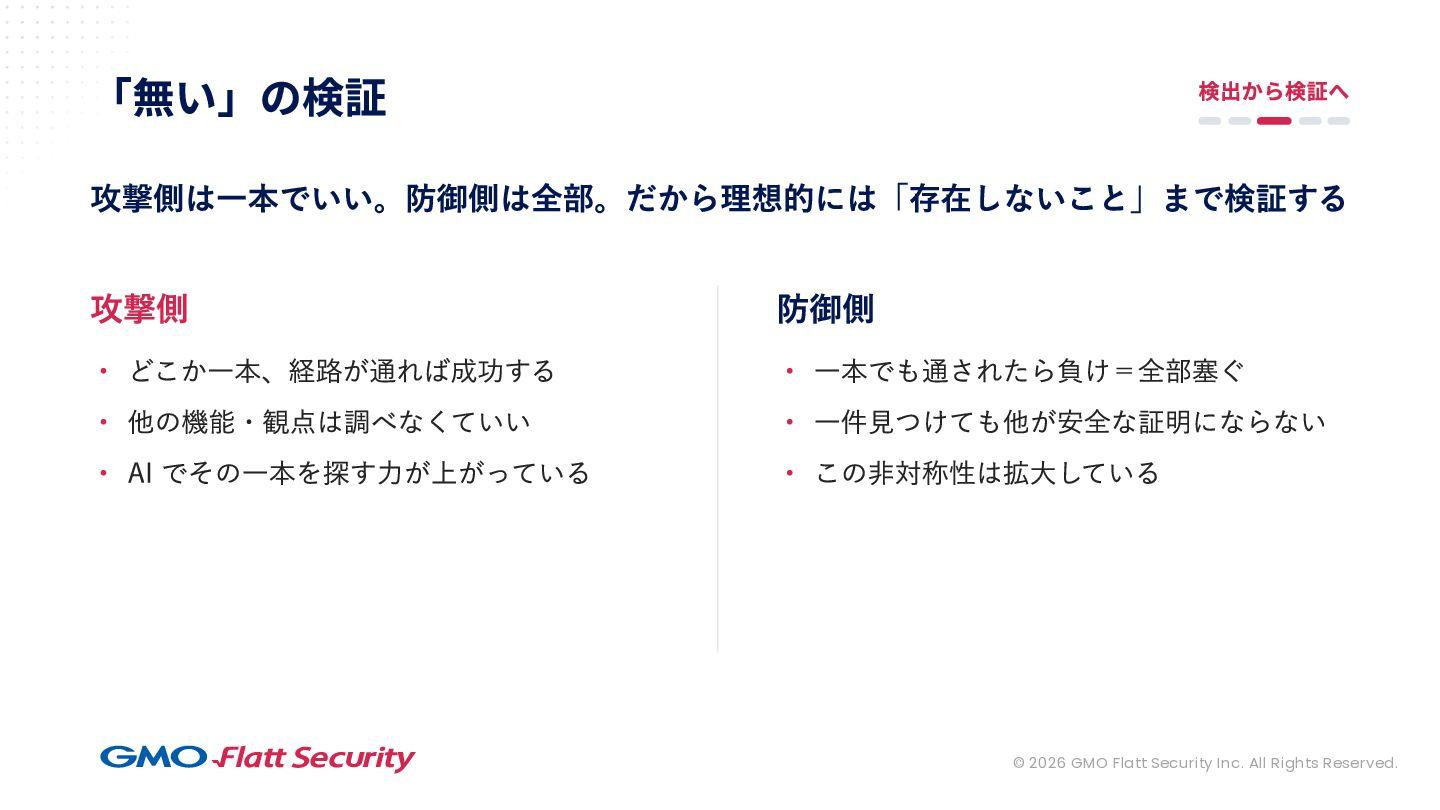
ここまでは「見つかった候補が本物か」という話でした。防御において本当に怖いのは、見つかっていないが存在している脆弱性です。Claude Codeに脆弱性を探せと言って「ありませんでした」と返ってきたとき、それが本当に全部を見たかどうかはわかりません。おそらく見ていない。「何も見つからなかった」はないことの証明にはなりません。
攻撃側はどこか一本、経路が通れば成功です。防御側は全部塞がなければ負けです。バイブコーディングでコードが増え続ける中、攻撃側が一本を通すためのコストはAIによってどんどん下がっています。直近で言うと、数千円かければWordPressのRCEが見つかるという事例も出てきました。守るべき面は広がりつつ、攻撃側の参入コストは下がっている。速度に続き、経済的な非対称性も加速しています。
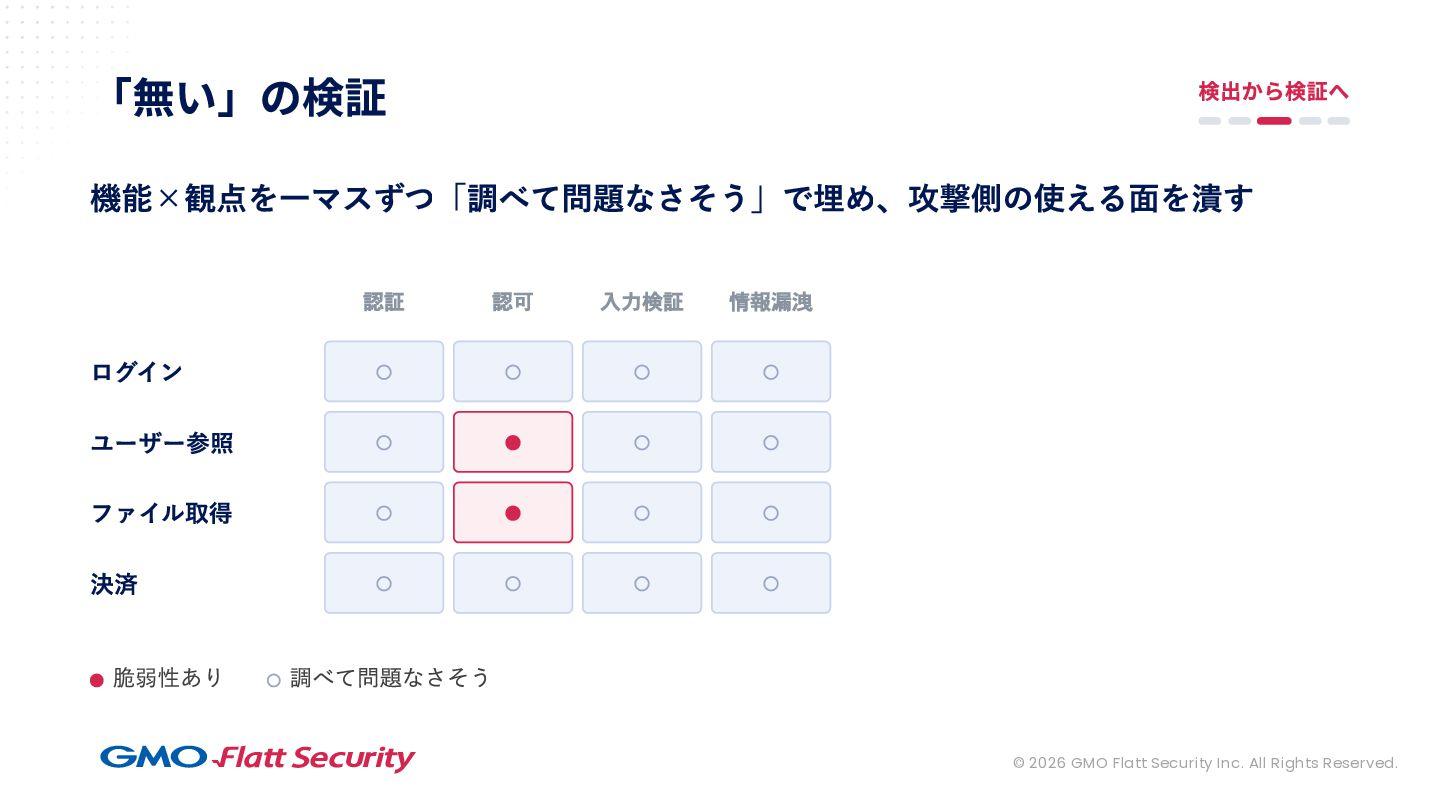
この非対称性への現実的な対処は、機能と観点のマトリクスを愚直に一マスずつ埋めていくことです。ログイン・ユーザー参照・ファイル取得・決済といった機能と、認証・認可・入力検証・情報漏洩といった観点を組み合わせ、各マスをAIに担当させます。この機能にこの観点で探せという形でタスクを細分化してAIに任せると、全無視してエージェンティックに動くことはほとんどないので、確認できているかどうかが担保しやすくなります。
例えばファイル取得×認可であれば、「別ユーザーのファイルIDを入力して他人のデータが返るかを確認する」という攻撃仮説を立て、オラクルで確定します。他人のファイルが返ればFinding、返らなければ問題なさそう。チェックボックスにチェックを入れていくイメージで、攻撃者が使える面を一マスずつ潰していきます。
また、見つかった候補はそのまま渡すのではなく、対応できる形に整えることが大切です。成立条件・再現手順と観測結果・影響範囲・仕様上の問題点・修正の方針。これを揃えて初めて「候補」ではなく「診断結果」と言えます。候補のまま渡すと真偽を確かめ直す負荷が残りますし、整えた根拠はそのまま修正後の再検査にも使えます。
修正の検証:「直った」はコードの変更では証明できない
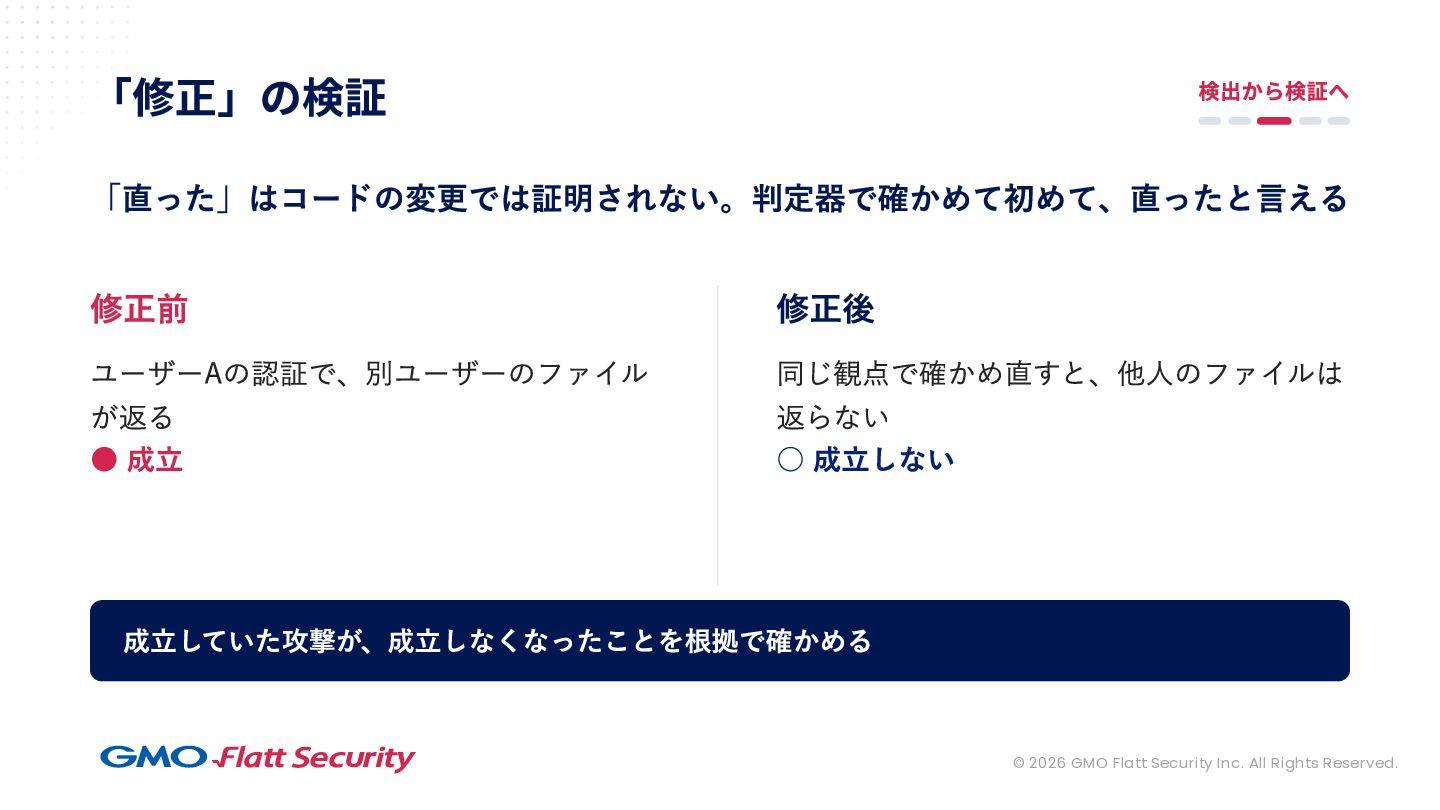
修正も同様に検証しなくてはいけません。直ったかどうかをコードの変更だけでは証明できないのは、脆弱かどうかをコードだけで判定しきれないのと同じ理由です。同じ判定器で再評価して、成立していた攻撃が成立しなくなったことを確認して初めて「直った」と言えます。
ただし現実には、脆弱性が10個見つかって1個ずつパッチして1回ずつデプロイして試すという動き方にはなりません。いろんな変更をまとめてガチャガチャやって一度デプロイして確認するという形が実態です。大幅な書き換えが一度のデプロイで起きると、同じ観点で確かめ直しても修正の確認にならないケースが出てきます。その場合は再検出から回し直す必要があります。これが変化への追従です。
発見の検証・ないことの検証・修正の検証、この3つを継続的に回し続ける。それができて初めて、生成の速度に検証の速度を近づけられます。一撃で見つけ切るのではなく、変化に追従してカバレッジを更新し続けることが問われています。PRやcommitのたびに影響する機能・観点も変わるので、変更に応じて関係するマスを開き直し、判定器で確かめ直す仕組みが必要です。
マトリクスで拾えない攻撃とゴール駆動の深い探索
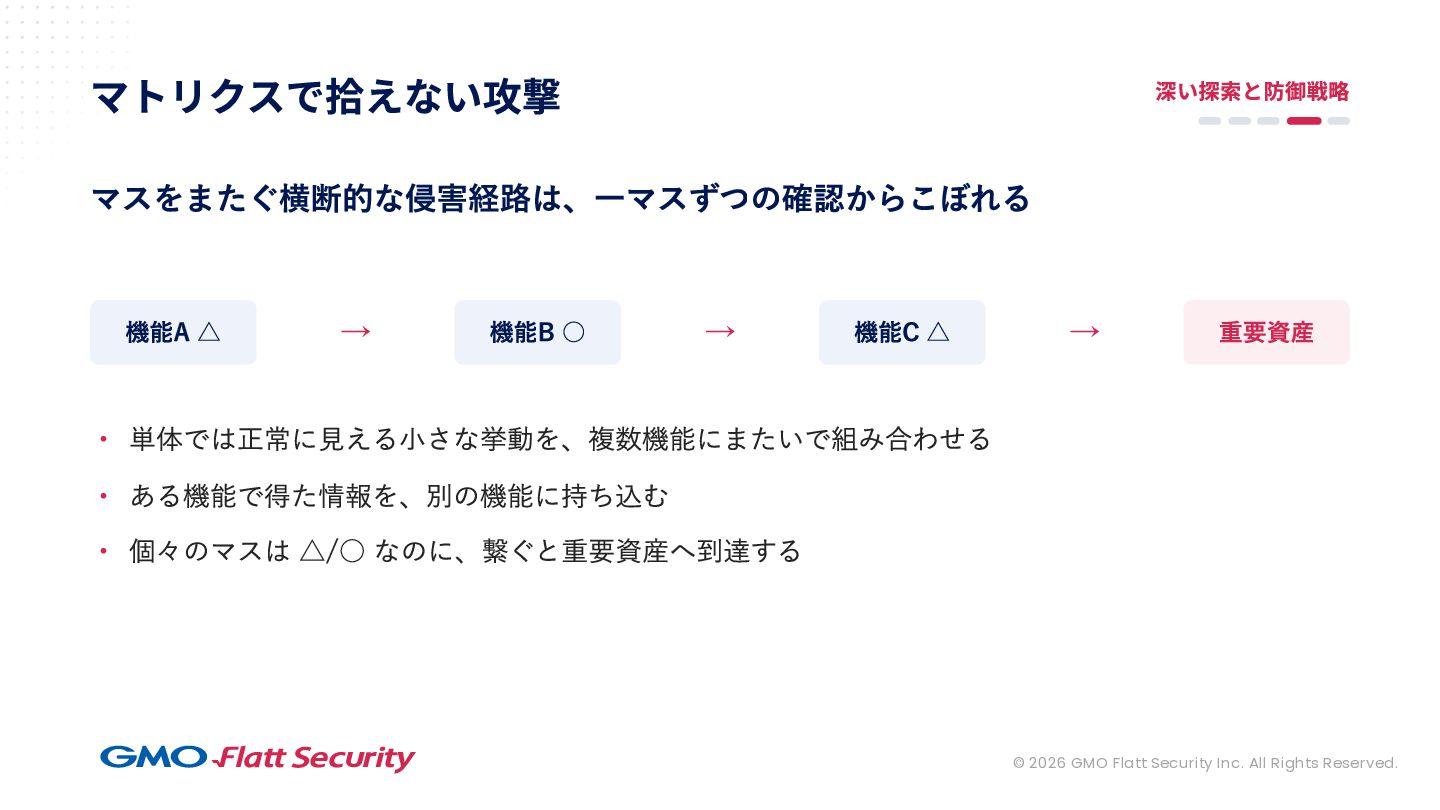
マトリクスによる診断で拾えない攻撃があります。それぞれの機能を単体で確かめると全て白丸でも、複数機能を連鎖させると重要資産への侵害が成立するケースです。機能Aで軽微な情報が取れるだけで、それ自体は問題なさそう。しかしその情報を機能Bに持ち込むと悪用でき、連鎖すると権限昇格が成立する。こういうパターンが実際の脆弱性診断やペネトレーションテストでは珍しくありません。
マトリクスの全マス間で情報を共有させれば対応できますが、そうなるとコンテキストが爆発してコストがとんでもないことになります。プロフェッショナルが診断するときも、ちょっとした問題を2〜3個組み合わせて結局アカウントが取れてしまう、というケースは割とあります。マス間の横断的な経路はこの診断の枠組みではこぼれてしまうのが現実です。
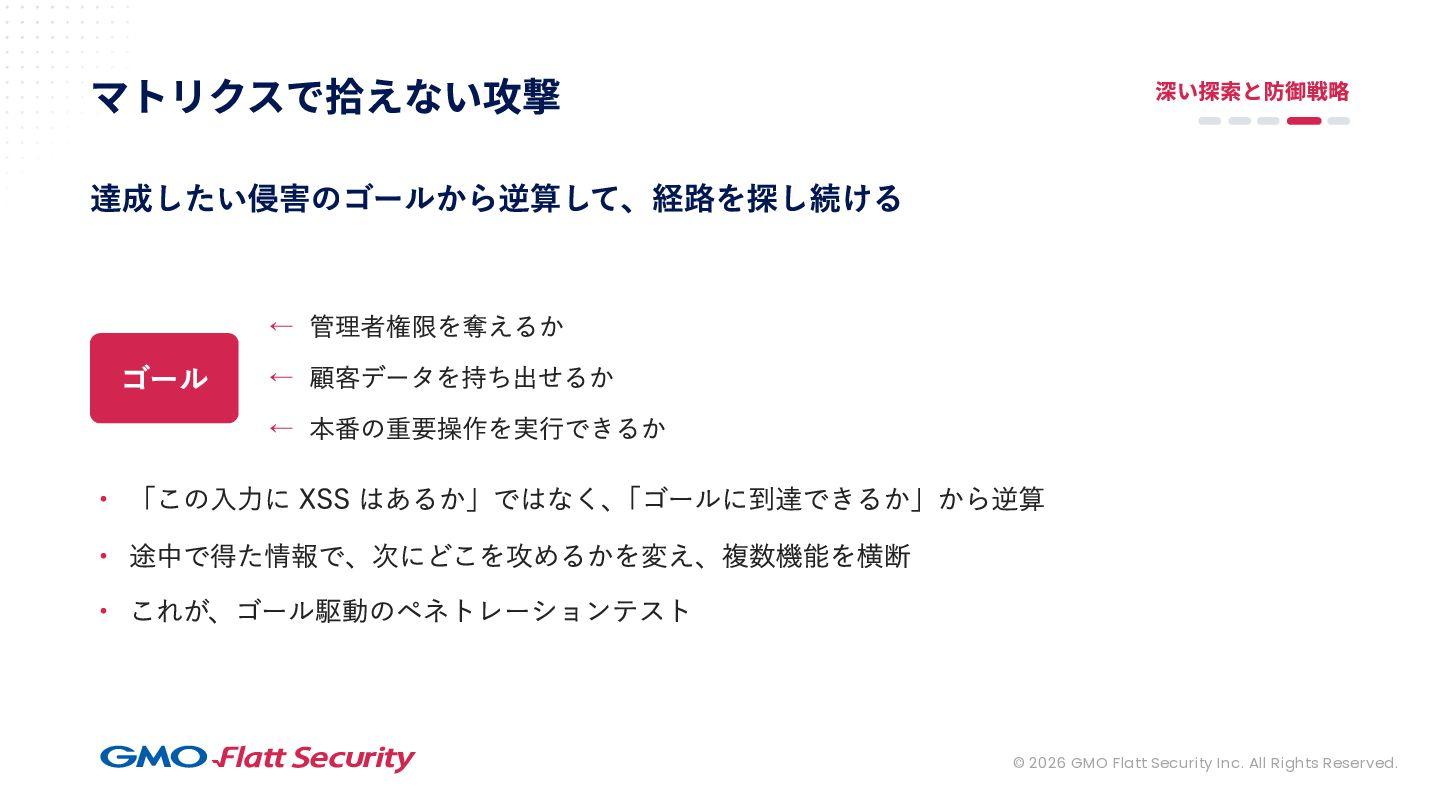
こういうときに有効なのが、ゴールから逆算するアプローチです。「管理者権限を奪えるか」「顧客データを持ち出せるか」「本番の重要操作を実行できるか」というゴールを設定し、そこに到達するための経路を複数機能を横断しながら探索する。「この入力にXSSはあるか」という観点ではなく、ゴールに到達できるかどうかから逆算して、途中で得た情報で次にどこを攻めるかを変えていきます。これがゴール駆動のペネトレーションテストです。GMO Flatt Securityでも最近このアプローチの研究開発を進めています。
ただし深い探索には追加コストがかかります。全マスにこのコストをかけることは現実的ではありません。セキュリティのリスクが100万円のところに1億円かけて診断するのは誰もやらない話です。追加コストをかける判断基準は「攻撃者がそこを狙う価値があるか」です。顧客データ・決済・管理者権限など高価値な資産や経路にはゴール駆動の深い探索を。それ以外は広く継続的なAI診断でカバレッジを更新し続ける、という使い分けが現実的です。
目指すのは「完璧な安全」ではありません。数千円かければWordPressのRCEが見つかるような時代に、全部守ることはもう不可能です。防御側として目指すのは、攻撃者がそれ以上深掘りしたら採算が割れるという状態を先に作ることです。小さいところから攻撃面を潰していき、攻撃者の採算割れを引き起こすような守り方が現代のセキュリティには大事です。防御側は、攻撃者の探索能力を先に自分へ向け続ける。それが確認の速度を生成の速度へ近づけることにつながります。
「By AI, with Experts」へ:診断の再設計が今に求められる
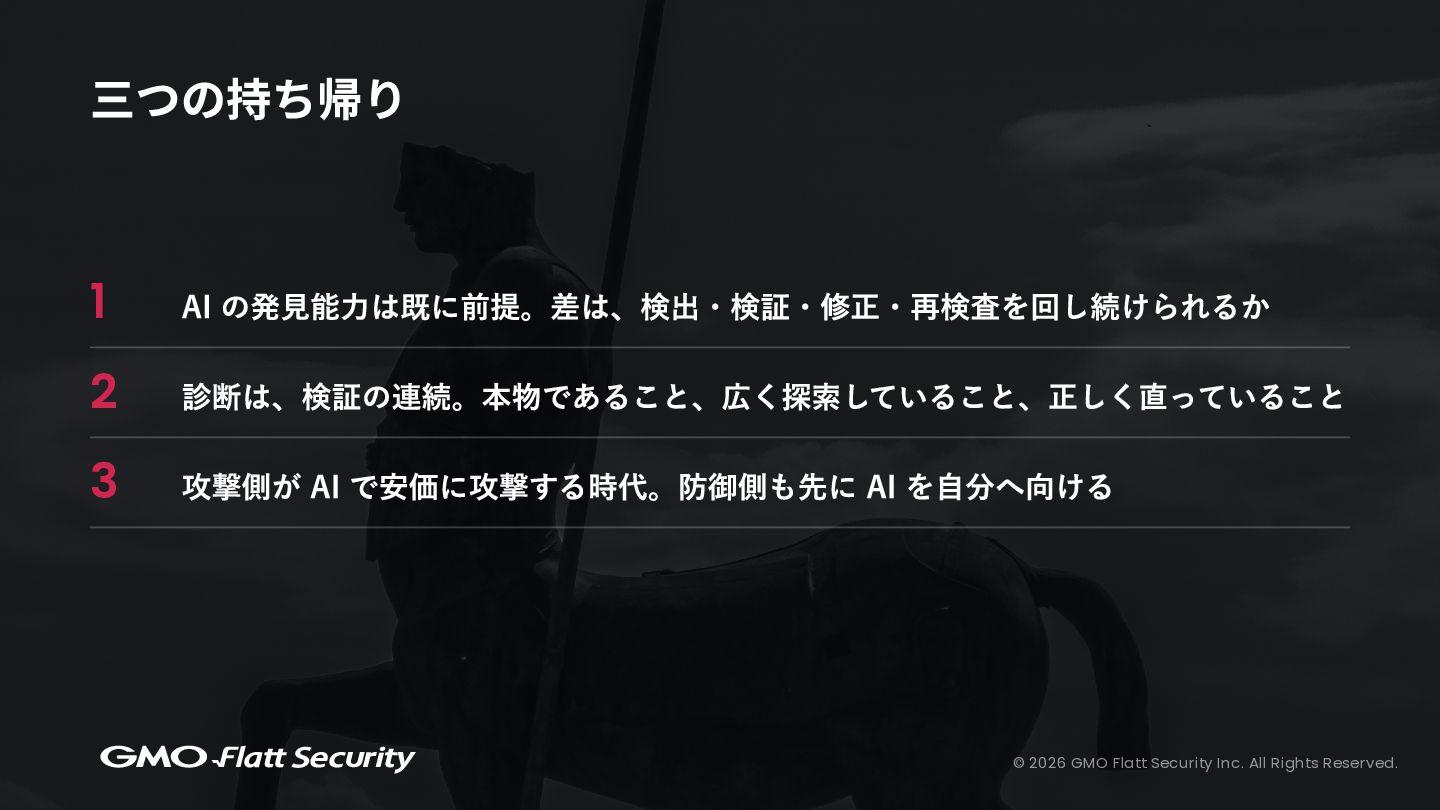
本日の3つの持ち帰りをまとめます。1つ目、AIの発見能力はすでに前提です。争点は、その力を自律的な修正まで行う仕組みにできるかどうかです。Claude Codeに脆弱性を探してくれと言うだけでは発見しかできていない部分があります。検出から修正まで自律的に回す仕組みが問われています。2つ目、診断は検証の連続です。本物であること、広く探索できていること、正しく直っていること、これらの検証を継続的に回す必要があります。3つ目、攻撃者がAIで安価に攻撃する時代に、防御側も先にAIを自分へ向けることが求められます。
開発の速度を元に戻すという意思決定は今できるものではありません。市場の競争力がかなり失われます。人間によるレビューに全部差し戻すことも現実的でなくなっています。AIで広く継続的に確かめ、根拠が揃ったFindingだけを開発者へ返す。可能であれば検証から修正まで全部AIで完結させる。そういった仕組みを自社内で組み上げることが、確認の速度を生成の速度へ近づける道です。
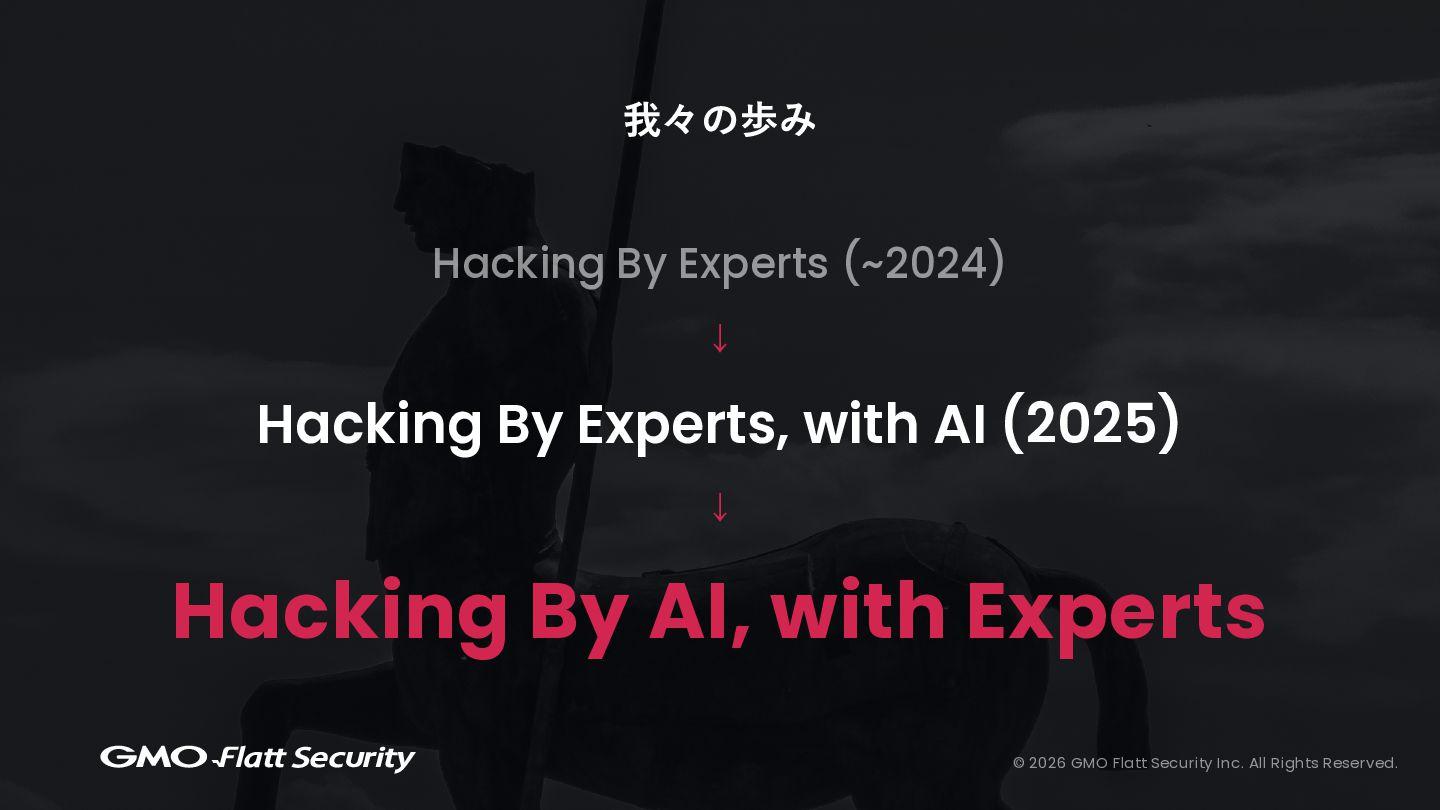
GMO Flatt Securityの歩みを振り返ると、もともとは「Hacking by Experts」として専門家が主体的に脆弱性診断やペネトレーションテストを行ってきました。次に「By Experts, with AI」の段階へ移行し、AIを道具として使いながら専門家が診断する形になりました。そして今はそろそろ「By AI, with Experts」へ向かっていくのが現代のセキュリティだと考えています。AIが主体的に動き、そこに専門家がサポートとして加わる形です。
Takumiではソースコードでの検出から動的検査による検証、自動修正の提案まで、人間がいかに関わらないかを徹底したシステムを構築しています。専門家は、AIでは対応しきれない高価値な資産への深い探索に力を集中させる。その知見を次のAI検証へと戻す循環を作ることが、エンジニアの背中を預かるGMO Flatt Securityとして目指していきたいことです。
アーカイブ動画・発表資料
イベント本編は、アーカイブ動画を公開しています。また、当日の発表資料も掲載しています。あわせてご覧ください。
▼動画はこちら
※動画の視聴にはFindyへのログインが必要です。