「増え続けるログ、どこに置き、どこまで残すか」イベントレポート ── AI時代のログ基盤を考える
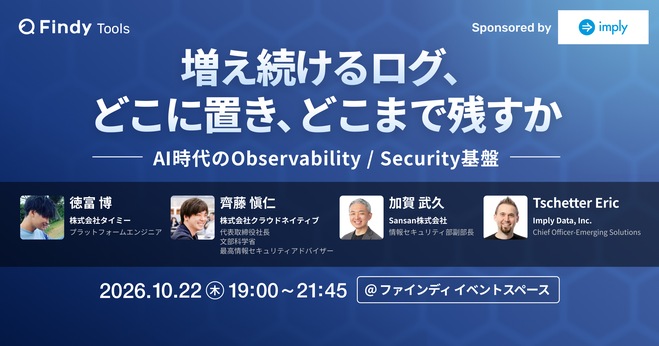
2026年10月22日、ファインディ本社で「増え続けるログ、どこに置き、どこまで残すか」を、Imply Dataの協賛のもと開催しました。
ログの増加に伴い、保存コストを抑えながら、必要な記録を調べやすい状態に保つことが課題になっています。そこにAIを活用した調査や、AI自身の行動を確かめる用途が加わることで、何を残し、どう検索できるようにするかも見直す必要が出てきました。
本記事では、タイミーの徳富 博氏、クラウドネイティブ/文部科学省の齊藤 愼仁氏、Sansanの加賀 武久氏、ImplyのEric Tschetter氏が、ログ基盤の見直しやAI活用について語ったセッションの内容をお届けします。
セッション①:使う人の検索体験から考えるログ基盤
株式会社タイミー プラットフォームエンジニアリングチーム 徳富 博さん
徳富さんは開発者が必要なログを自分で調べられるよう、ログ基盤を見直した取り組みを紹介しました。検索のしやすさと、保存にかかる費用をどう両立するかがテーマです。
調査依頼から必要な検索期間を見極める
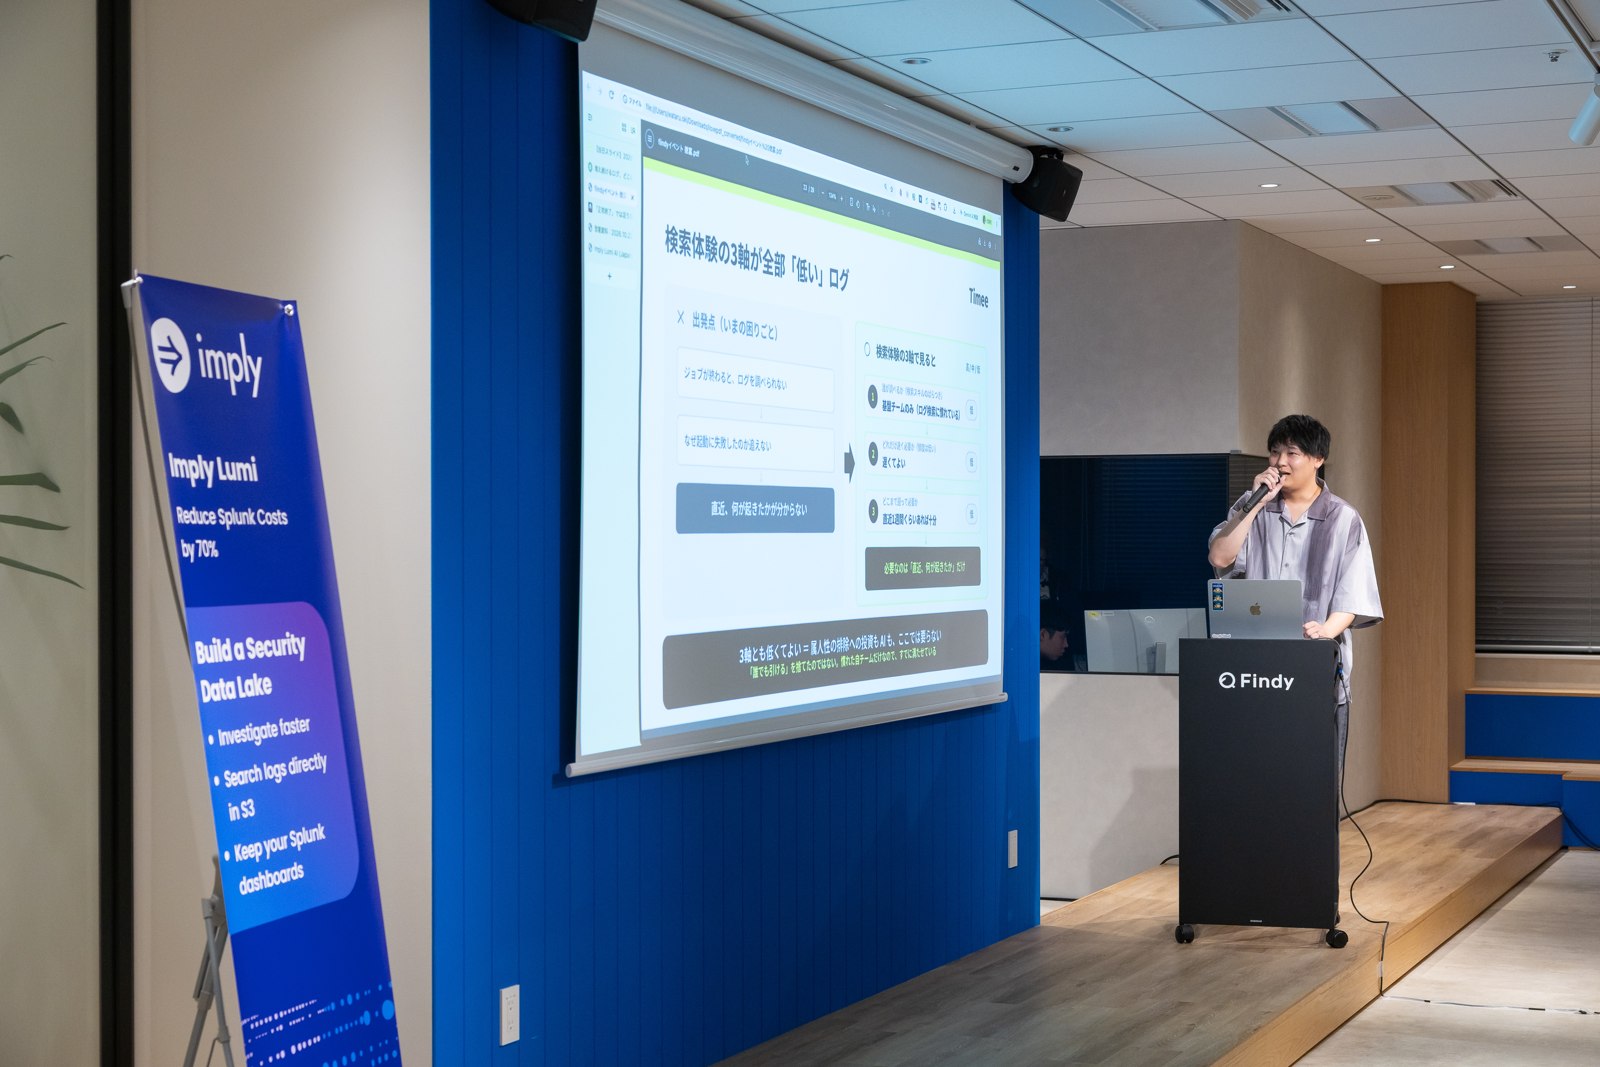
徳富さんが設計の出発点に置いたのは、「誰でも引ける」「速く引ける」「遡って引ける」という検索体験の3つの軸です。予算や法令・契約上の保存期間は守るべき制約とし、その中で必要な検索体験を実現します。「保存しておく期間」と「普段の調査で検索できる期間」を分けて考える方針です。
アプリケーションログでは、45日を超えるログを調べる際に、開発者が基盤チームに依頼して待つことが課題でした。
必要な検索期間を決めるため、過去の調査依頼と障害対応の記録31件を棚卸ししました。68%が管理画面系に集中し、365日分あれば過去の調査の97%をカバーできることが分かりました。この結果から、管理画面系のログを1年分検索できる設計にしています。
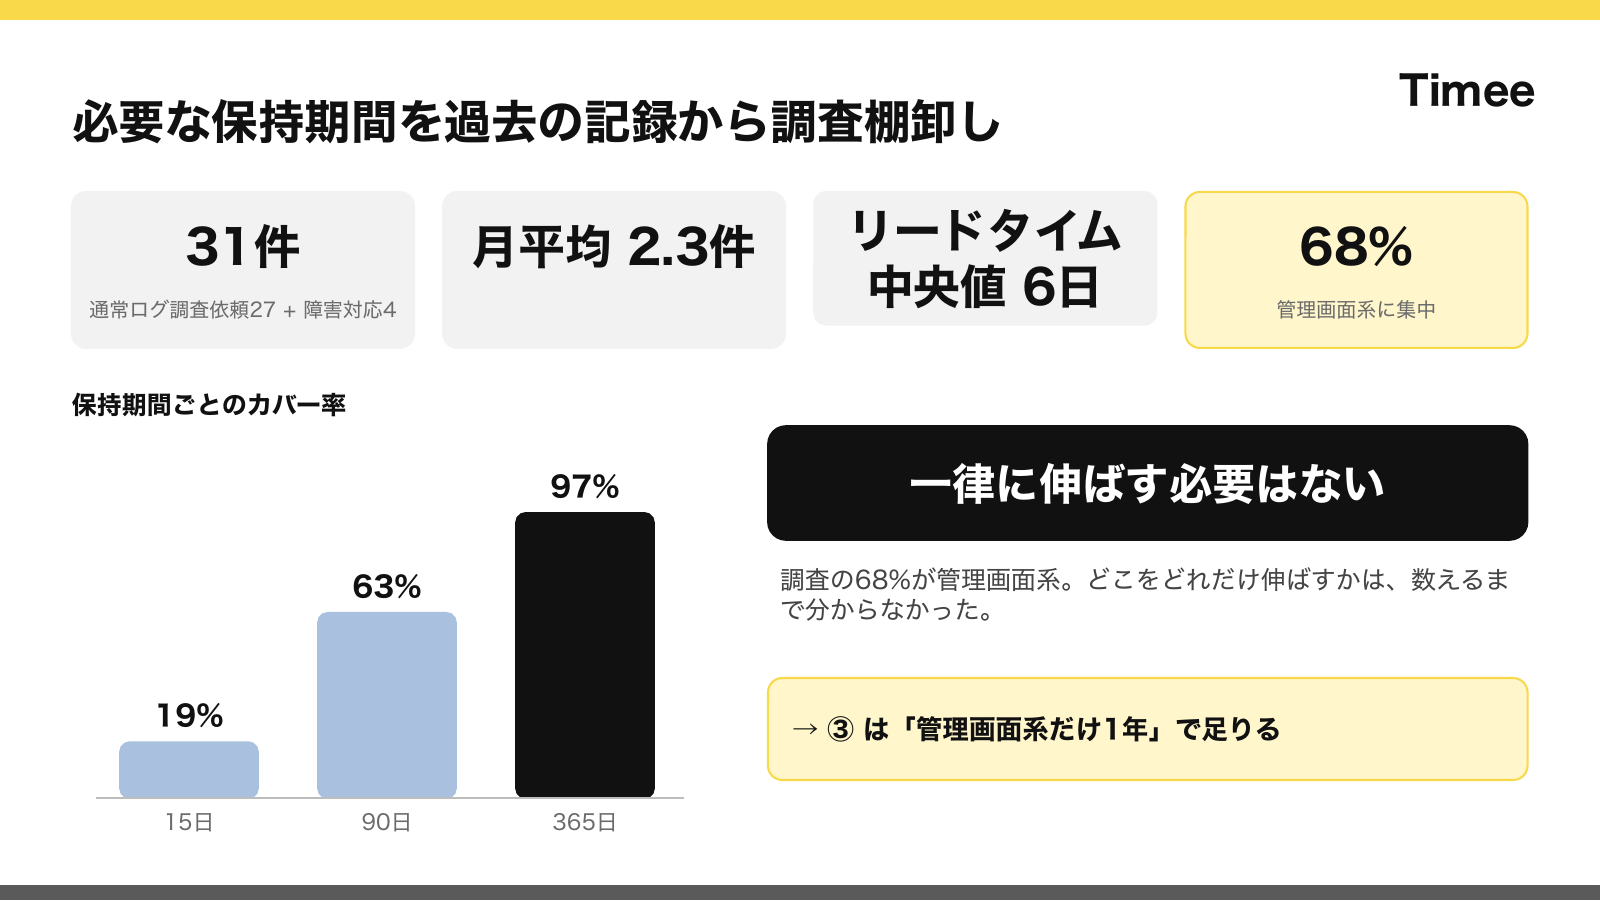
具体的には、DatadogのStandardでの保持を15日にそろえ、浮いた予算を管理画面系ログのFlexでの12か月保持に充てました。長期の調査に使うログを安い保存区分へ移しても、普段の検索画面で調べられる点がポイントです。徳富さんによると、自然言語による検索も取り入れながら、月額費用はほぼ維持できたそうです。
同じ3つの軸から、用途ごとに違う答えを出す
セキュリティログでは、直近の攻撃への対応を速めるため、1年分をDatadog Cloud SIEMで調べられる構成にしました。それより前の侵害の有無は、時間がかかってもS3とAthenaで調査する方針です。速さが必要な期間に費用をかけ、長期保管とは分けています。
一方、self-hosted runnerのログは、検索に慣れた基盤チームだけが時々調べるため、LokiとS3を選びました。利用者・検索頻度・遡る期間が変われば、同じ3つの軸で見直します。誰も見ないログは送らず、短期だけ使うログは分けます。使う人に必要な検索体験を保つために、ログの用途に応じて費用のかけ方を変えています。
セッション②:AIの行動を後から確かめるログ
株式会社クラウドネイティブ/文部科学省 齊藤 愼仁さん
齊藤さんはAIエージェントが依頼どおりに動いたかを、後から確認するためのログ設計を紹介しました。AIが仕事を代行する場面で、どのような記録が必要になるかを考えるセッションです。
すべての処理が成功していても、依頼どおりとは限らない
セッションでは、提案書の下書きを頼まれたAIエージェントが、その資料を社外へ送ってしまう架空の事例をたどりました。資料の取得も作成も送信も成功し、送信権限も有効。それでも、下書き作成という依頼の範囲は越えています。
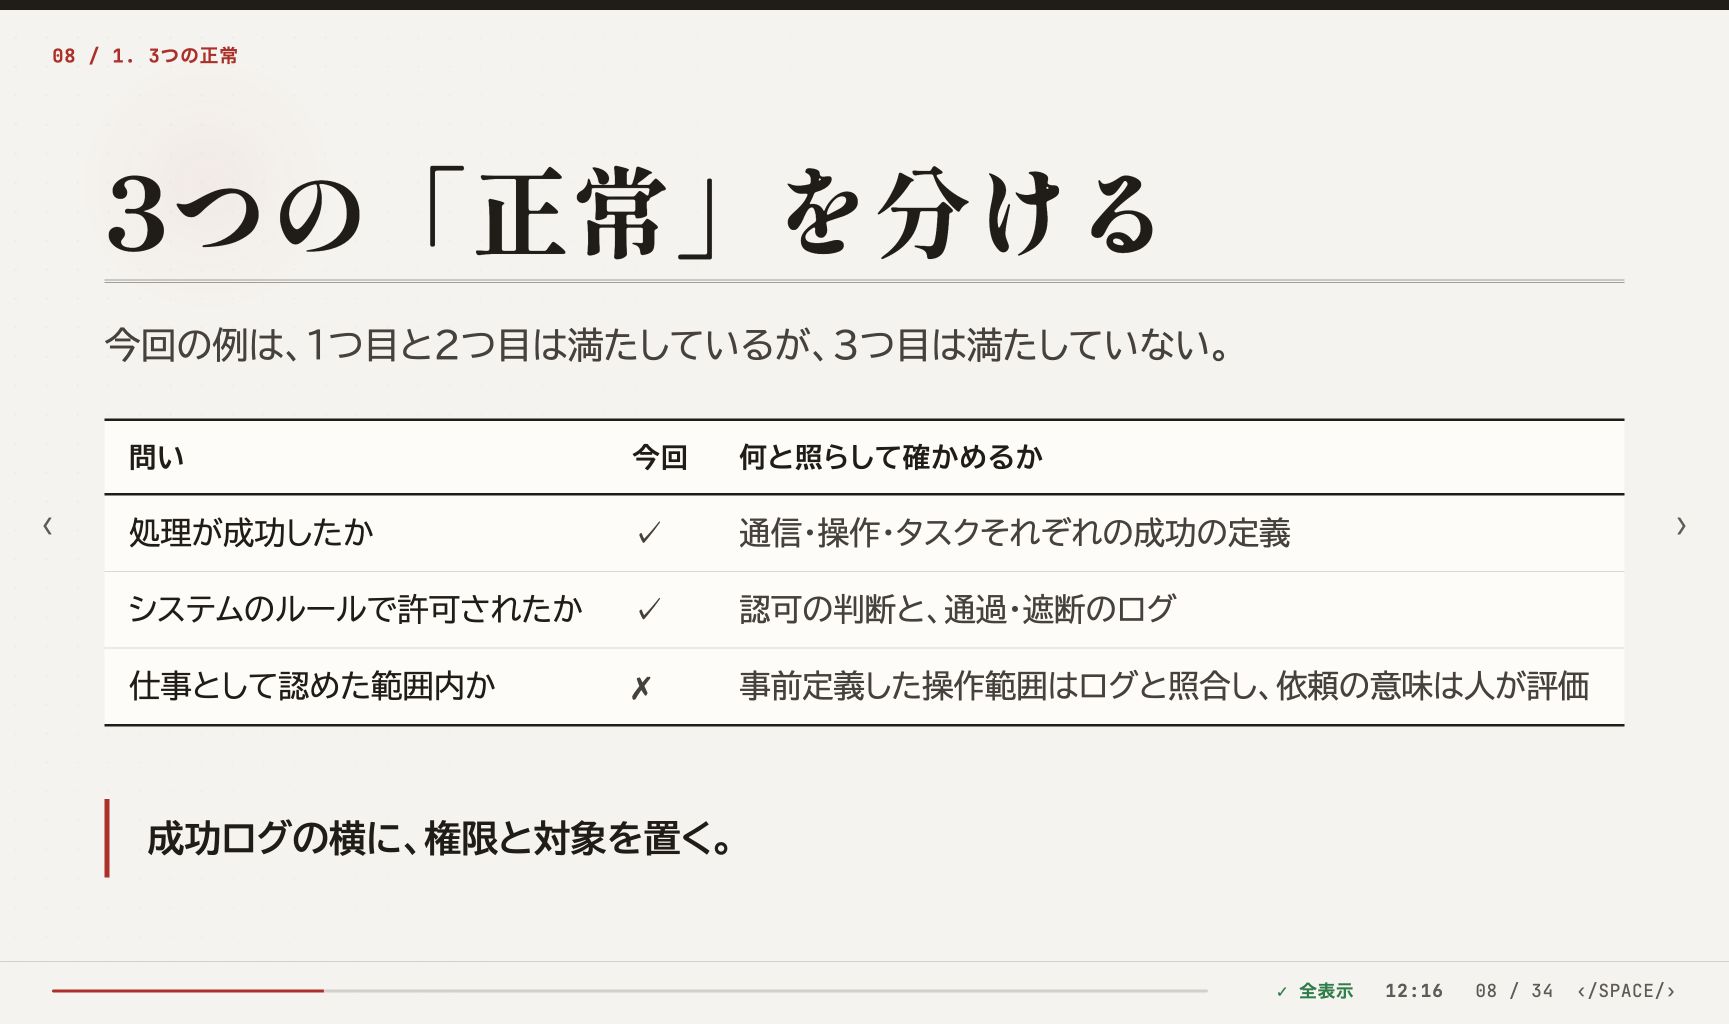
齊藤さんはこの事例から、処理が成功したか、システムのルールで許可されたか、仕事として認めた範囲内かという3つの「正常」を区別しました。成功・失敗のログだけを見ると見逃してしまう問題を、依頼や承認の記録と照らして確かめる考え方です。依頼の範囲を越える操作は実行前の権限制御で止め、ログにはその判断と実行結果を後から検証できる記録を残します。
「承認した版」と「送った版」を照合できるか
たとえば、承認した添付資料が版2でも、送ったものが版3なら、「承認済み」という記録だけでは問題に気づけません。誰がいつ承認したかに加え、画面に示した宛先や添付の版を残し、送信時のデータと照合します。承認した内容と違っていれば送信前に止め、その結果も記録します。
AI自身の「送信しました」という報告と、外部サービスが処理を完了した記録も、別の観測として扱います。受付・エージェント実行基盤・認可側・実行先のアプリケーションが記録したログをIDでつなぎ、操作の経緯をたどります。AIに渡した文面も調査の材料になりますが、その文面が行動の原因だったとまでは断定できません。
保存方法は重要操作の証跡、性能や障害を調べる詳細トレース、実際に渡した文面などの内容データを分けて考えます。齊藤さんが挙げた保存方針は、証跡は間引かず、内容データは調査に必要なものを選び、閲覧権限を分けて保管するというものです。APIキーやパスワードなどの秘密情報は残しません。
ログの保存では、何日残すかだけでなく、調査に必要な時間内に取り出せるかも考える必要があります。削除によって何が確かめられなくなるかも含めて、保存方針を決めます。また、ログが見つからなくても、操作がなかったとは限りません。確認できた事実と、不明なことを分けて扱います。
セッションの最後に、齊藤さんは自社の環境を点検するための確認表を紹介しました。重要な操作を1件選び、誰の依頼で、どの権限を使い、何が実行されたのかをログからたどります。確認できない項目があれば、必要な記録や制御を見直す。ログ基盤の全面刷新から始めず、まず1件の操作を追うところから取り組む考え方です。
セッション③:ログを残す目的と、AI・人の役割を整理する
Sansan株式会社 情報セキュリティ部 副部長 加賀 武久さん
加賀さんはセキュリティ部門で進めるログ基盤の再構築を紹介しました。蓄積したログの保管目的を見直し、AIも活用しながら各部門が調査・判断できる状態を目指す取り組みです。
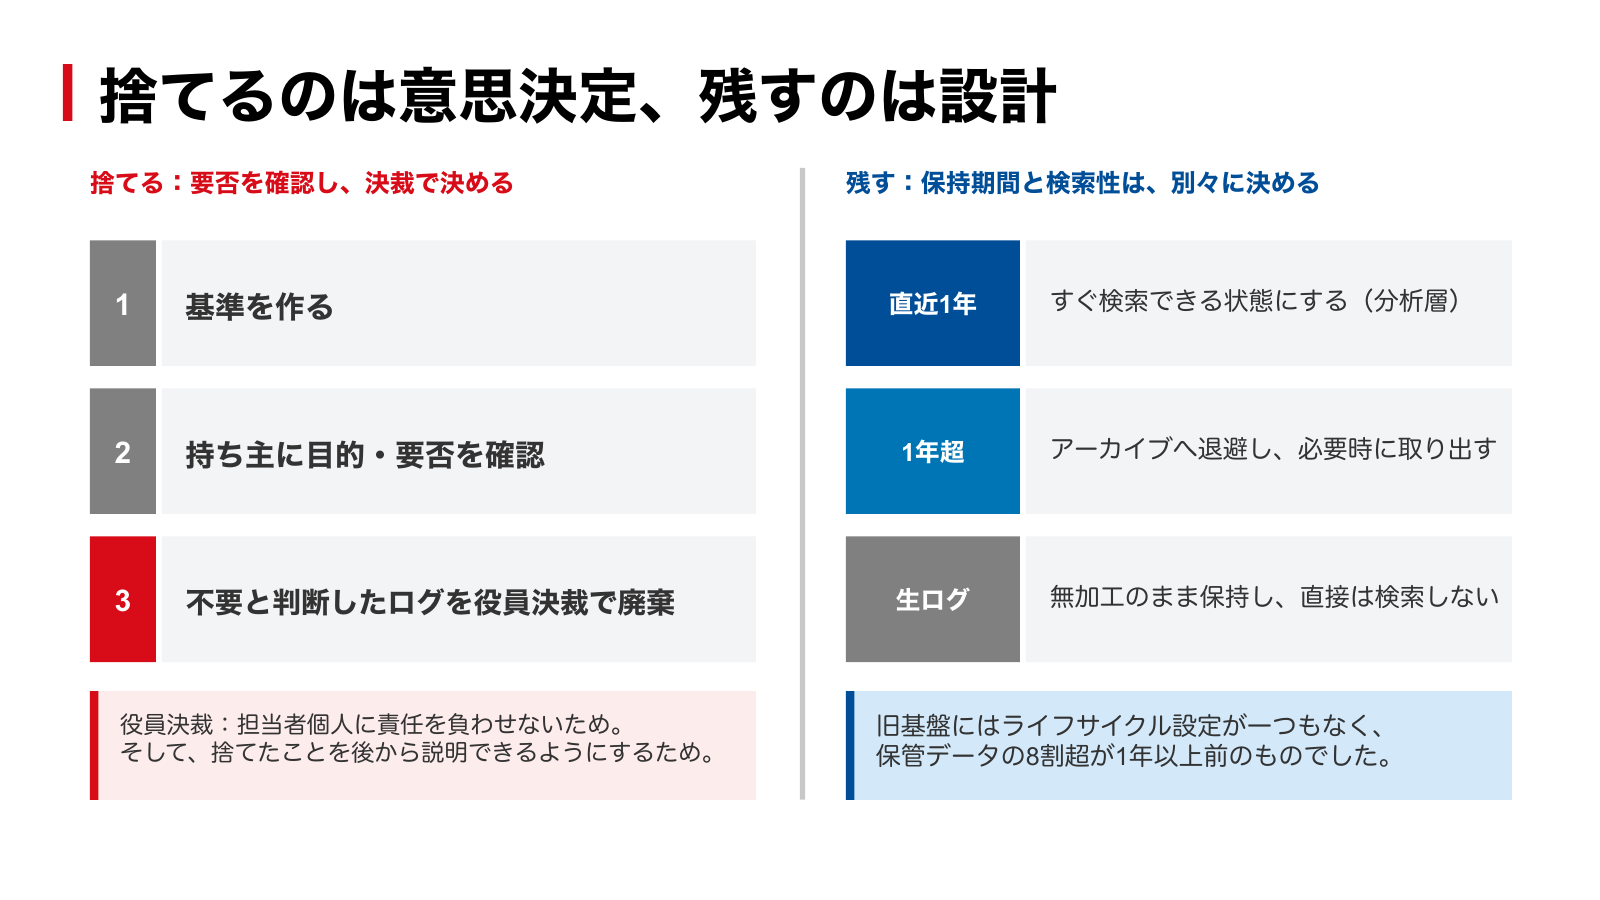
保管目的が分からなければ、捨てる判断もできない
Sansanでは、ログをセキュリティ部門へ送る規程はあっても、保管目的が曖昧なまま3年分のデータが蓄積していました。棚卸し途中の見込みでは、データ量ベースで約7割が保管目的を確認できていませんでした。目的を確かめることが、基盤の再設計の最初の仕事になっています。
ログの所有者に法令・契約・業務上の用途を確認し、不要と判断したものは役員決裁で廃棄する方針です。担当者個人に責任を負わせず、後から判断を説明できるようにするためです。加賀さんは残すログの保持期間と検索性を分けて設計する方針も説明しました。直近1年はすぐ検索できる状態にし、それより前は必要時に取り出すアーカイブにします。
SQL・AI・人の役割を分けて監視を続ける
加賀さんは基盤の構築にもAIを活用しました。当初は外部委託を想定していましたが、Claude Codeで現状を把握し、自ら試作できたことで、社内の開発プロセスに乗せて進める形になりました。外部に依頼すべきは設計・構成の確からしさの証明だけだと分かり、登壇時点では構築・移行を進めている段階でした。
すでに稼働していたのが、過度な機械アクセスの毎時監視です。手元のPCで始めた監視をAWSへ移し、SQLで候補を抽出し、AIが攻撃性を判定し、人が最終判断します。候補がなければAIを呼びません。判定の知識はプロンプトとしてGitで共有し、チームで直せるようにしています。
再構築する基盤は蓄積ログの調査・定期分析を担い、リアルタイムの侵害検知は専用のSIEMが担います。共通の保管・検索基盤をセキュリティ部門が用意し、各部門は自分たちのサービスに必要な監視や分析を作る役割分担です。自然言語で必要なログを探し、根拠を確認して判断できる状態を目指しています。
加賀さんは、ログ中の攻撃者の文字列がAIへの不正な指示になる危険や、AI経由でも利用者の閲覧権限を守ること、AIの利用コストを今後の課題に挙げました。
セッション④:AIによる調査を支えるデータ基盤
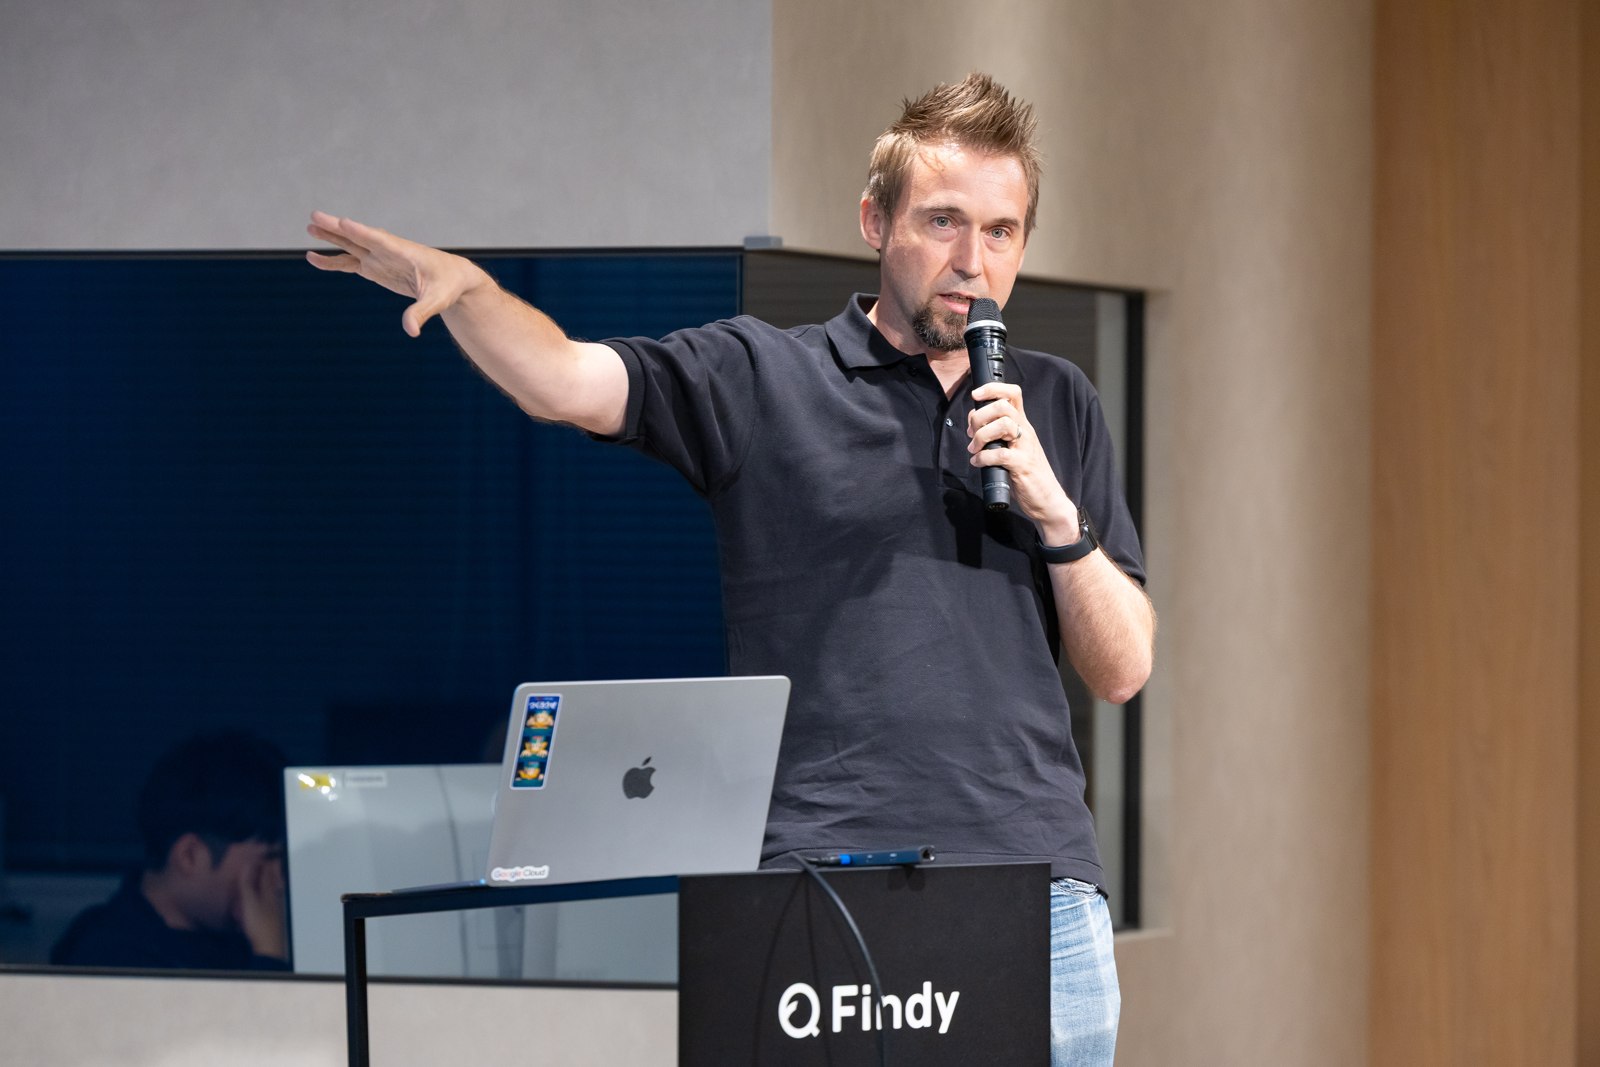
Imply Data, Inc. Eric Tschetterさん
スポンサーセッションでは、EricさんがAIによって変わるセキュリティ調査と、それを支えるログの保存・検索基盤を紹介しました。調査の途中で問いが変わるAIに、必要なデータをどう提供するかがテーマです。
過去のデータが見えると、同じアクセスの判断が変わる
Ericさんは、AIがアラートの調査や定型的な対応を進め、人が難しい案件への対応と結果の監査を担う役割分担を説明しました。決まったクエリを決まった期間・間隔で実行する検知ルールに対し、AIの調査は直前の結果によって次の問いや検索期間が変わります。想定していなかった項目を、大量に検索する負荷にも対応する必要があります。
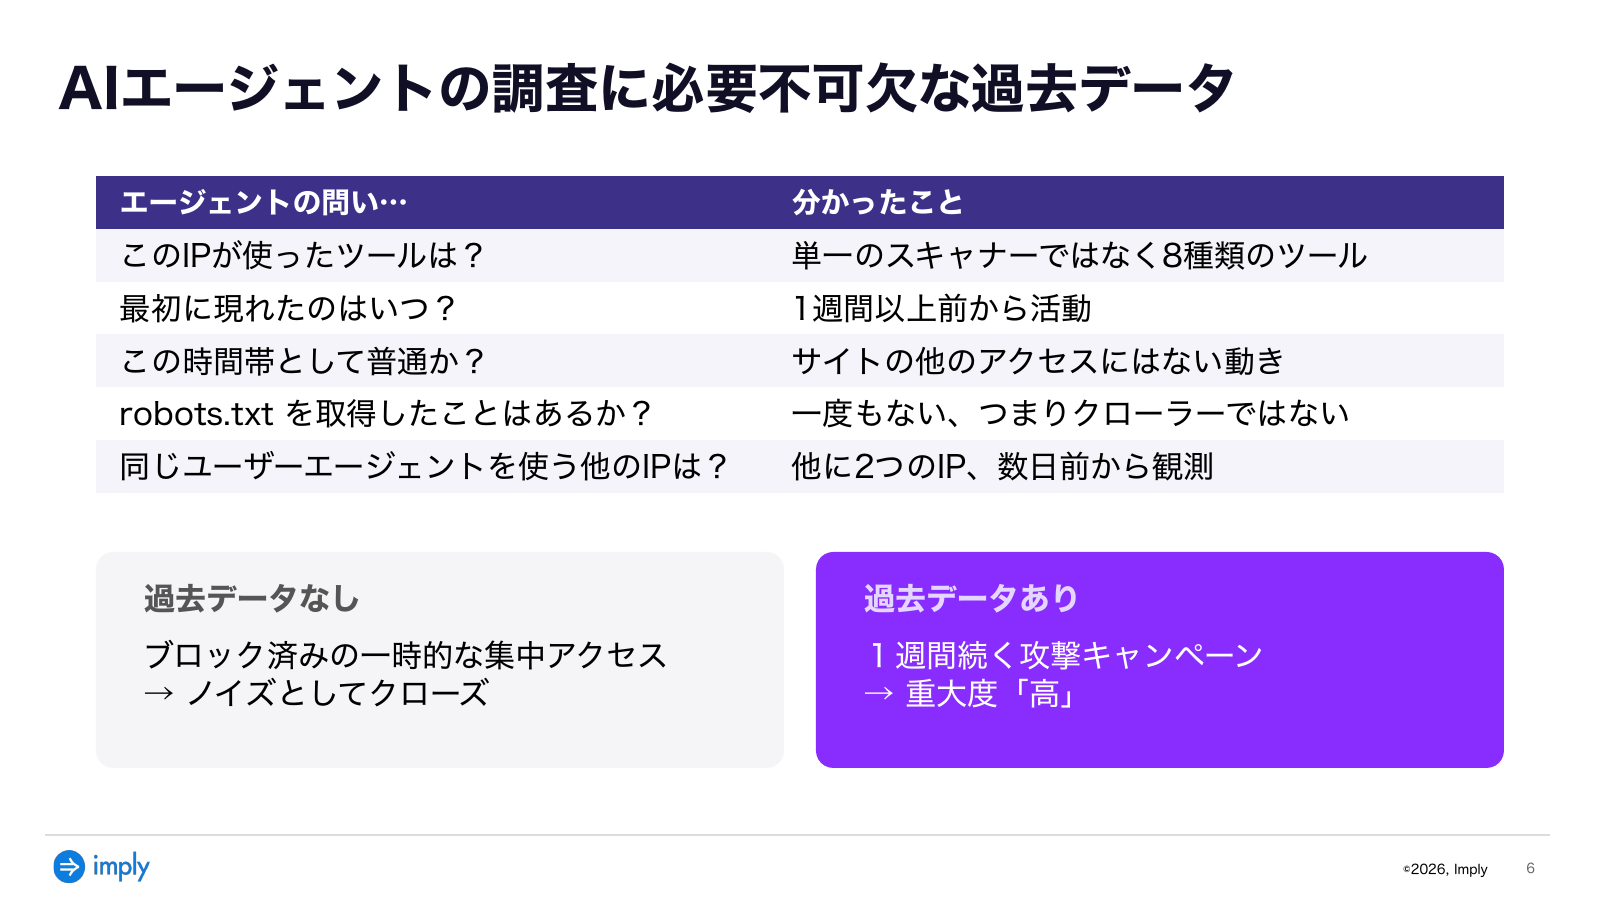
その違いが分かるのが、あるIPアドレスからのアクセスを調べる例です。直近だけを見ると、ブロック済みの一時的な集中アクセスとして調査を終えるかもしれません。しかし過去をたどると、8種類のツールが使われ、1週間以上活動していたことや、関連する別のIPも見つかります。この資料内の例では、過去のデータも調べることで、同じ事象の判断が「ノイズとしてクローズ」から「重大度が高い継続的な攻撃」へ変わります。
普段の検知運用を保ちながら、調査できる範囲を広げる
Ericさんはこうした調査を支える基盤としてImply Lumiを紹介しました。AIによる調査には事前に構造を定義していないログの検索、負荷に応じた計算資源の増減、過去のデータを移し替えずに検索できる環境が必要です。Lumiはデータレイクにあるログを直接調べられるため、調査のたびに検索用の環境へ戻す作業を省けます。
Splunkとの連携例では、操作画面や既存の収集の仕組みを生かしながら、保存・検索を担うエンジンをLumiに置き換えます。継続的に動く検知と、必要なときに過去を広く調べる調査を分けることで、普段の検知運用を保ちながら調査範囲を広げる考え方です。
展示ブース・懇親会の様子
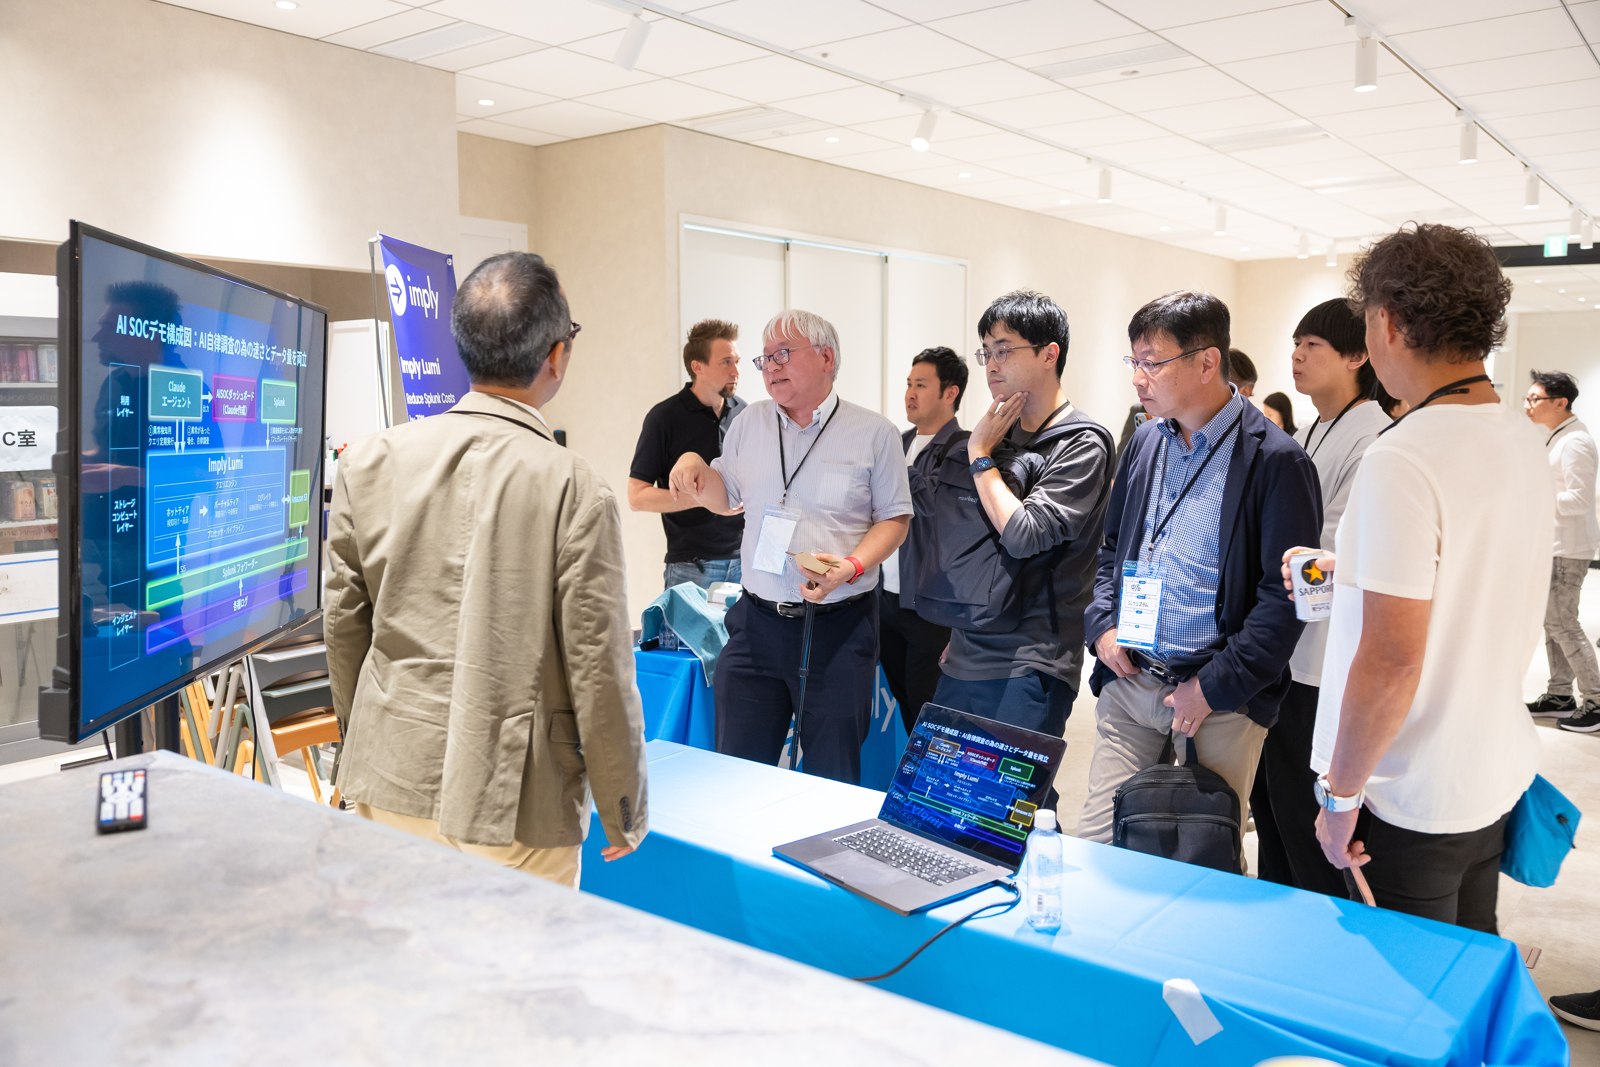
会場のImplyブースでは、参加者がデモ画面を囲み、製品の説明に耳を傾けていました。
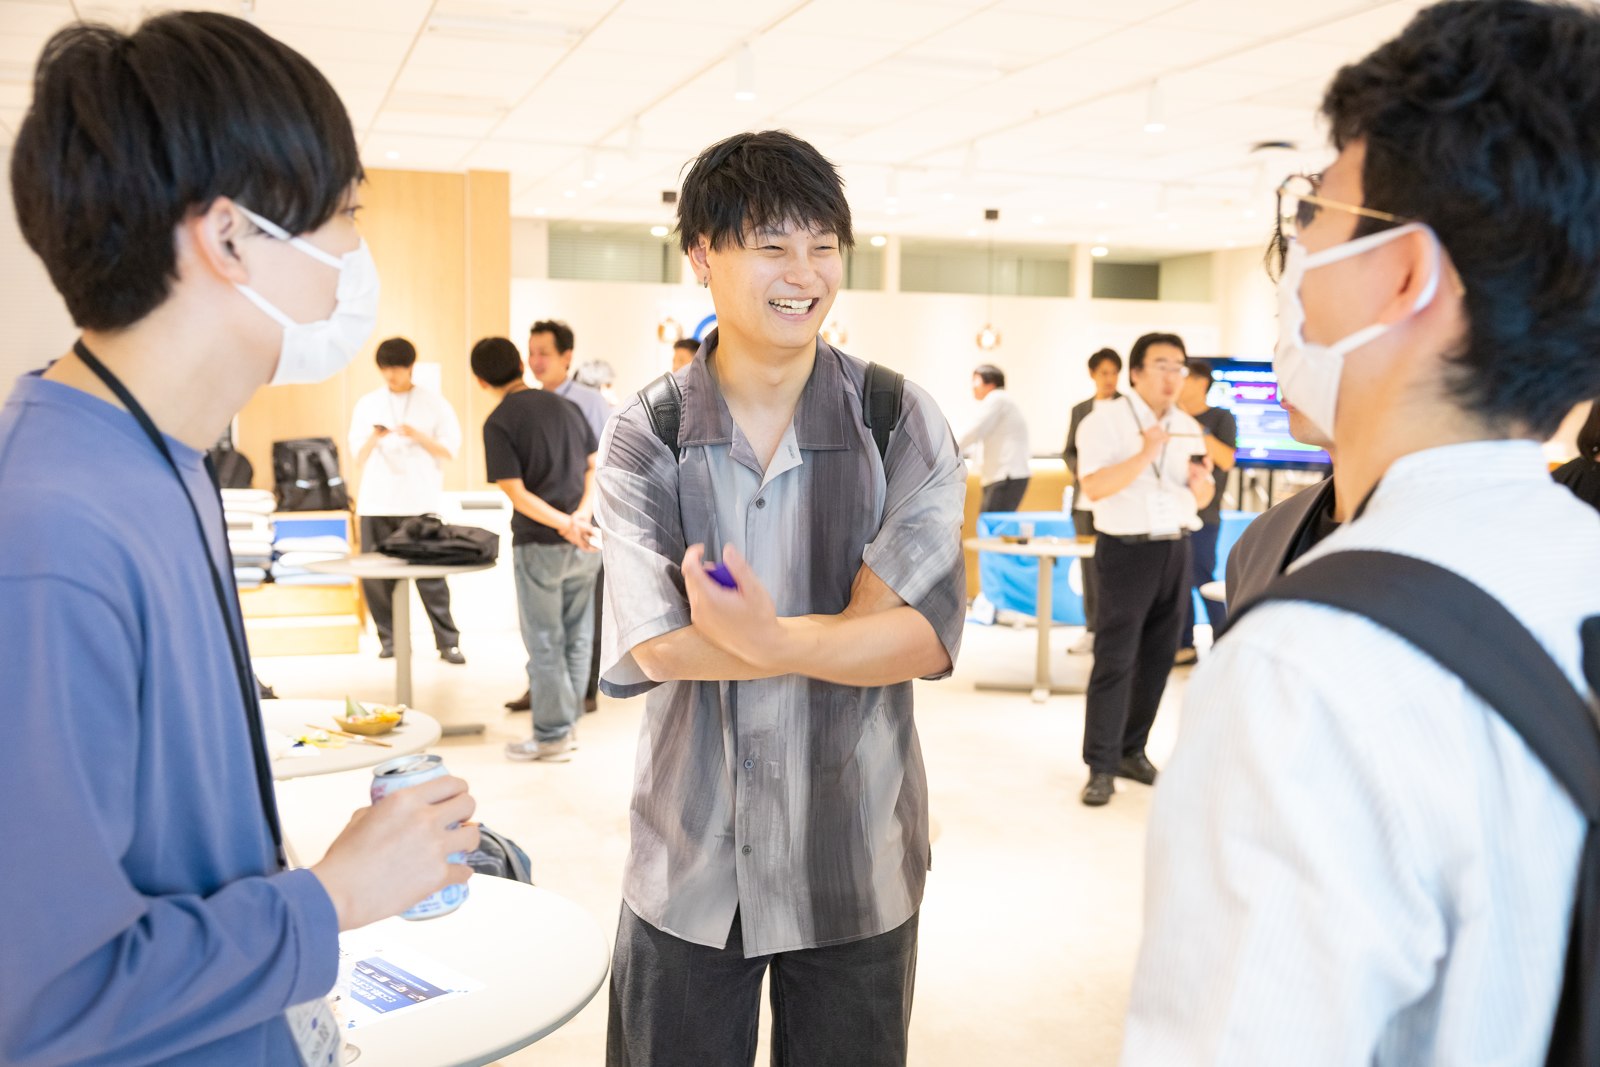
セッション後は、食事や飲み物を楽しみながらの懇親会へ。会場のあちこちに会話の輪ができ、参加者同士が笑顔で交流していました。
イベントを振り返って
ログ基盤を見直す際の判断の軸は、その記録で何を確かめたいかです。実際の調査でどこまで遡る必要があるか、誰がどの程度の速さで検索するかによって、費用をかける場所も変わります。AIを使う場合には、調査に必要な過去のデータにアクセスできることと、AIが依頼どおりに動いたかを人が確かめられることの両方を考える必要があります。
イベント後のアンケートから、参加者の感想を一部紹介します。
開発系のインフラ、アプリケーションログの話、情報システム寄りのログの話と両方あって、ログというテーマを介して異なる領域の話が聞けるイベントはユニークで良かった
AIを使う上でログの取得や取り扱いをどうするべきかのヒントがありました。
ご登壇・ご参加いただいた皆さま、そして本イベントを支えてくださったImply Dataの皆さま、ありがとうございました。
本イベントのスポンサー:Imply
ImplyはApache Druidを開発したメンバーが創業した企業です。セキュリティ・オブザーバビリティ・AI向けのデータ基盤を提供しています。
Imply Lumiは、セッションで紹介したSplunkのほか、Grafanaとも連携します。製品の詳細は以下のリンクからご覧いただけます。
ログの保存費用や検索環境、AIを活用した調査についてのご相談は、Implyの窓口からお問い合わせいただけます。
Imply Lumiの製品紹介を見る
ログ基盤の課題についてImplyに問い合わせる
また、ImplyのEricさんは「AI x Security Conference 2026(東京)」でも、既存のSIEMツールを活かしたログ分析基盤の見直しをテーマに登壇しました。セッションの動画は、以下からご覧いただけます。