【Data Engineering Summit 2026】DWHの限界突破! AIエージェント向け爆速リアルタイムデータ基盤ClickHouse
2026年10月9日、ファインディ株式会社が主催するイベント「Data Engineering Summit 2026」が、東京建物 ぴあ シアター&カンファレンスにて開催されました。
本記事では、ClickHouse株式会社 Solutions Architectの大薗純平さんによるセッション「DWHの限界突破!AIエージェント向け爆速リアルタイムデータ基盤ClickHouse」の内容をお伝えします。
■プロフィール
大薗 純平(ClickHouse株式会社 ソリューションアーキテクト)
外資系ITベンダーにて、長らくData & AI領域のソリューションアーキテクトとして従事。列指向データベース、分散処理エンジン、データとAIの統合基盤などを活用したお客様のシステム構築を支援。現在はClickHouseで、AI時代に求められる次世代リアルタイムデータ基盤の普及を推進している。
自己紹介
ClickHouseの大薗です。もともと複数の外資系ITベンダーで、データやAIの領域のソリューションアーキテクトをしてきました。列指向のデータベースやデータウェアハウス、分散処理エンジン、そして最近出てきているデータとAIの統合基盤といったところで、お客様をご支援してきた経験があります。
その経験も踏まえてClickHouseを知ったとき、非常に魅力的なプロダクトだと感じました。2025年11月に日本法人ができたのですが、翌2026年にClickHouseにジョインしています。
なぜ今、リアルタイムデータ基盤が必要なのか
最近「リアルタイム」というキーワードをよく聞くようになったと思いませんか。ただ、経験の長い方からすると、別に今に始まった言葉じゃないよねと思われるかもしれません。その通りで、キーワードとしては何も新しくありません。ではなぜ、この言葉がまた再燃しているのでしょうか。
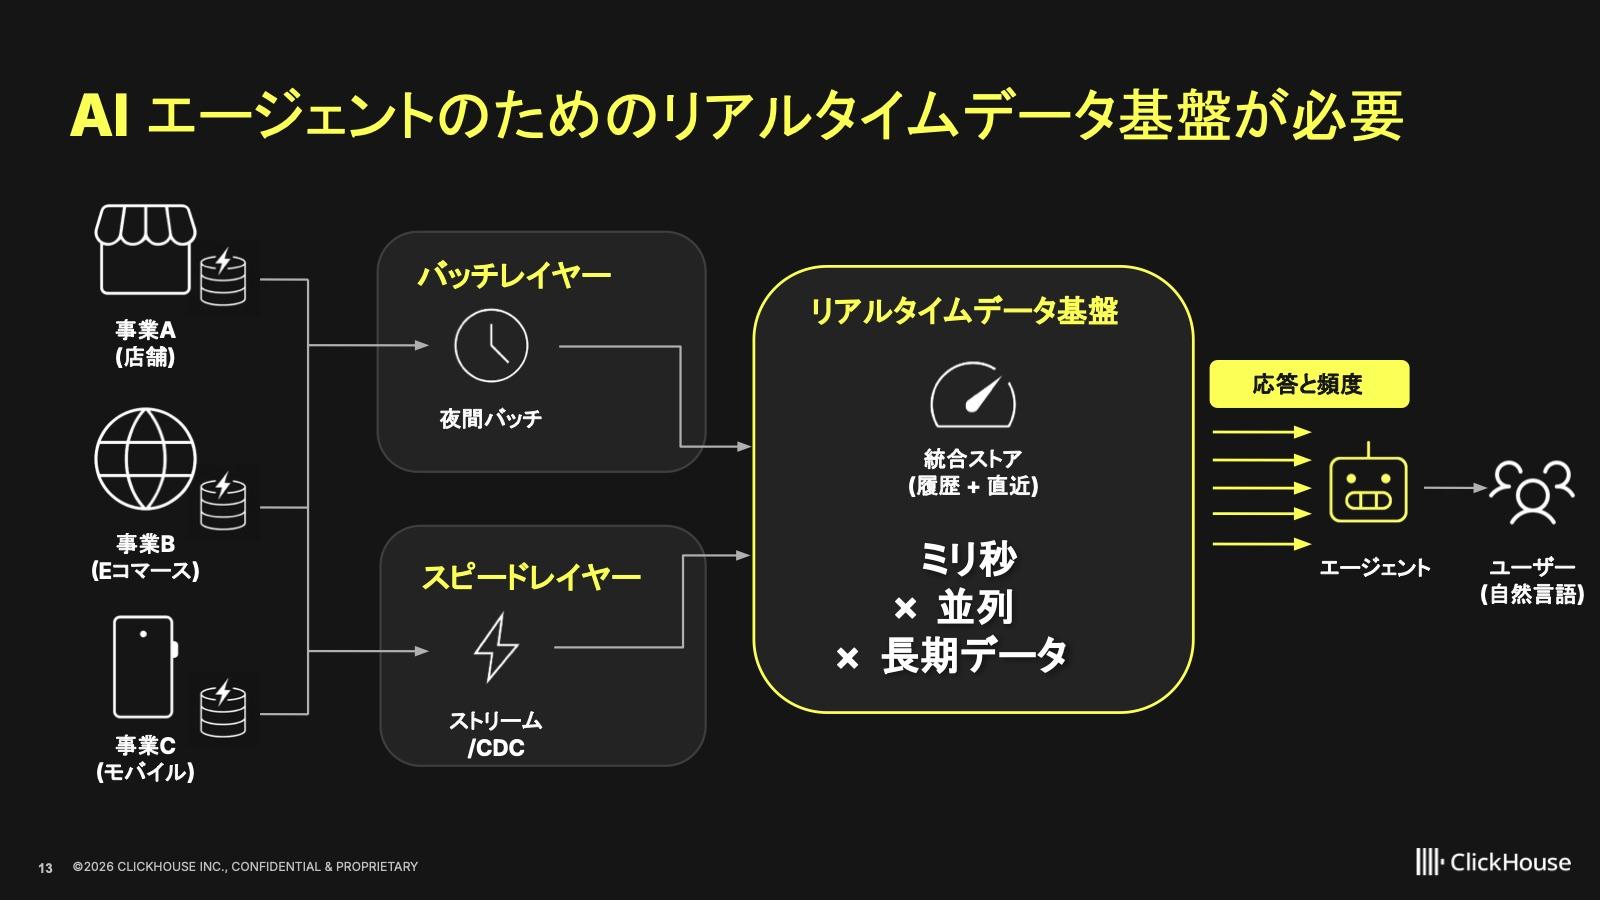
多くの企業は、業務データベースやログにある売上や行動データを分析して、ビジネスに活かしたいと考えてきました。ただ、業務システムには影響を出せませんし、そもそも分析向けのシステムでもありません。そこで作られてきたのが、夜間バッチでデータウェアハウスやデータレイクに履歴を貯め、BIや帳票で見る仕組みです。これは「過去に何が起きたか」を知るための仕組みで、鮮度は日次、応答は数十秒から分単位でも許されていました。
その一方で、不正検知やパーソナライズのように「今何が起きているか」を瞬時に知りたいニーズも出てきます。そこで、ストリームで直近のデータを流すスピードレイヤーを横に置くようになりました。ただ、こちらはストリーム基盤の運用で考えることが圧倒的に増えます。
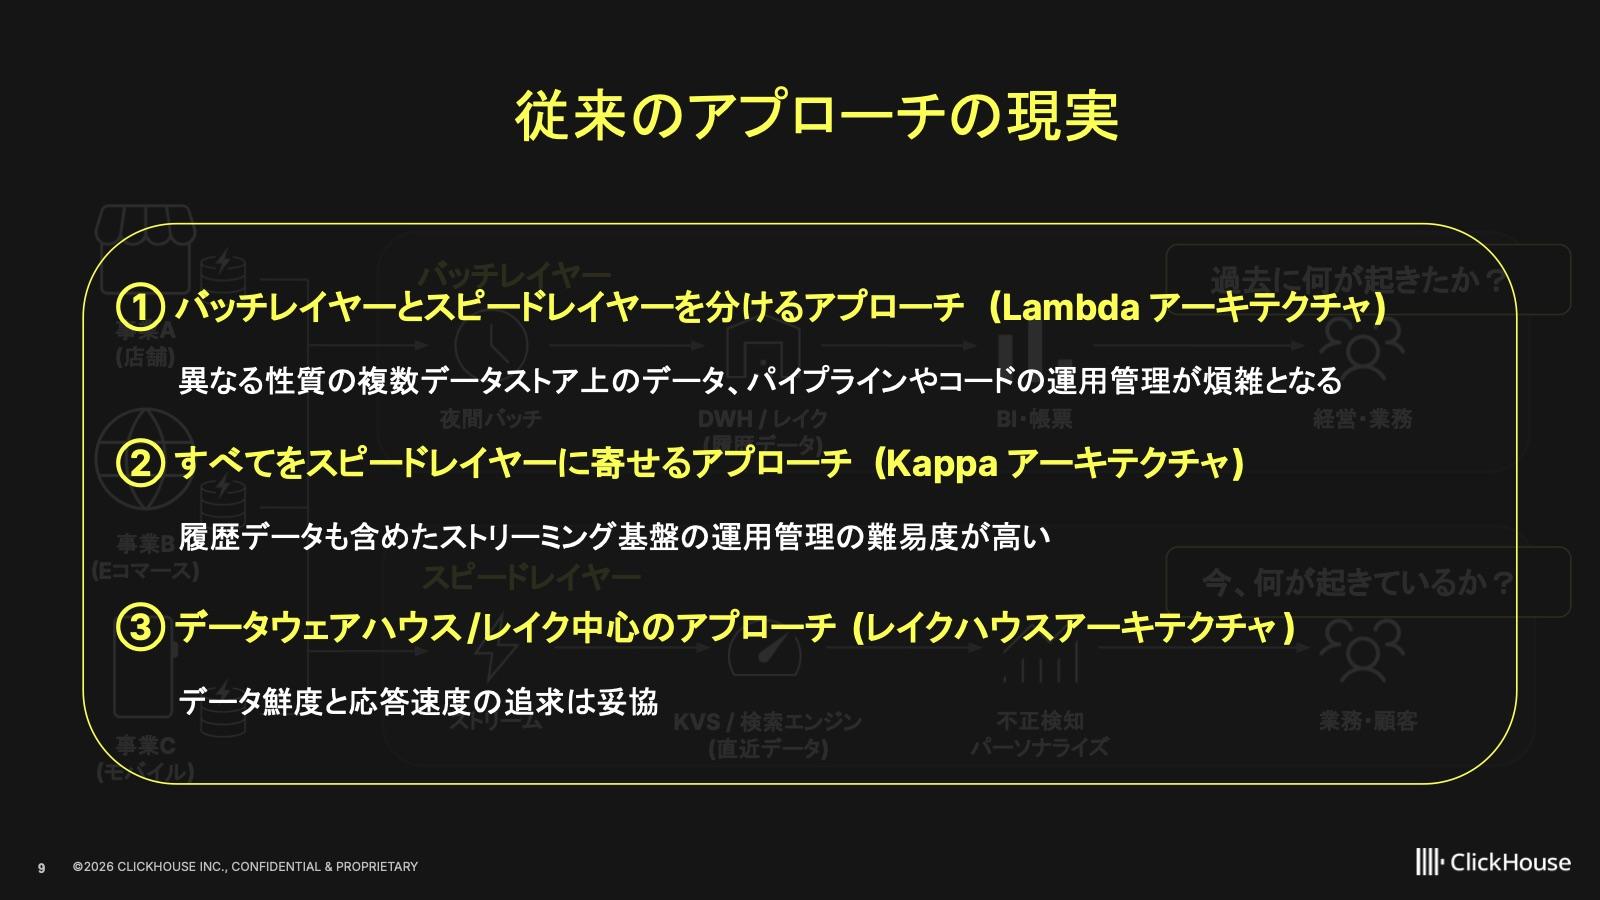
現実の構成は、大きく3つに分かれると思っています。バッチとスピードを分けるLambdaアーキテクチャは、複数のデータストアやパイプラインの運用が煩雑になります。すべてをスピードレイヤーに寄せるKappaアーキテクチャは、履歴までストリーミング基盤で持つので、運用の難易度が段違いに上がります。そしてDWHやレイクで完結させるレイクハウスアーキテクチャは、基本がバッチ志向なので、鮮度や応答速度には一定の妥協が残ります。
つまりこれまでは、データの特性と運用性を天秤にかけ、ケースバイケースで個別最適なアーキテクチャを考えるのが当たり前でした。その前提を変えようとしているのが、AIエージェントです。
AIエージェントは、データへの要求をどう変えるのか
人が中心だったワークロードは、今、AIエージェントが主体のワークロードへ移ってきています。エージェントに目的を与えると、エージェントが自分で考えて、いろいろなデータストアからデータをかき集め、アウトプットを出す。これが「データドリブンからワークフロードリブンへ」という変化です。
これまでは、クエリの数やアクセスパターン、応答時間をある程度想定して決めておくことができました。ところがエージェントが主体になると、クエリの数は大量に増え、アクセスパターンも多様化し、ミリ秒での応答が求められるようになります。
よく言われる話ですが、裏側では何が起きているのか。エージェントのReActループで考えると分かりやすいと思います。ユーザーが自然言語でリクエストを投げると、エージェントはLLMで推論して計画を立て、ツールを呼び出します。そのツールがデータベースだったりするので、問い合わせて、結果を読んで記憶し、また推論する。このループを回すので、1往復のデータの応答に往復の回数を掛けたものが、そのままユーザーの待つ時間になるわけです。
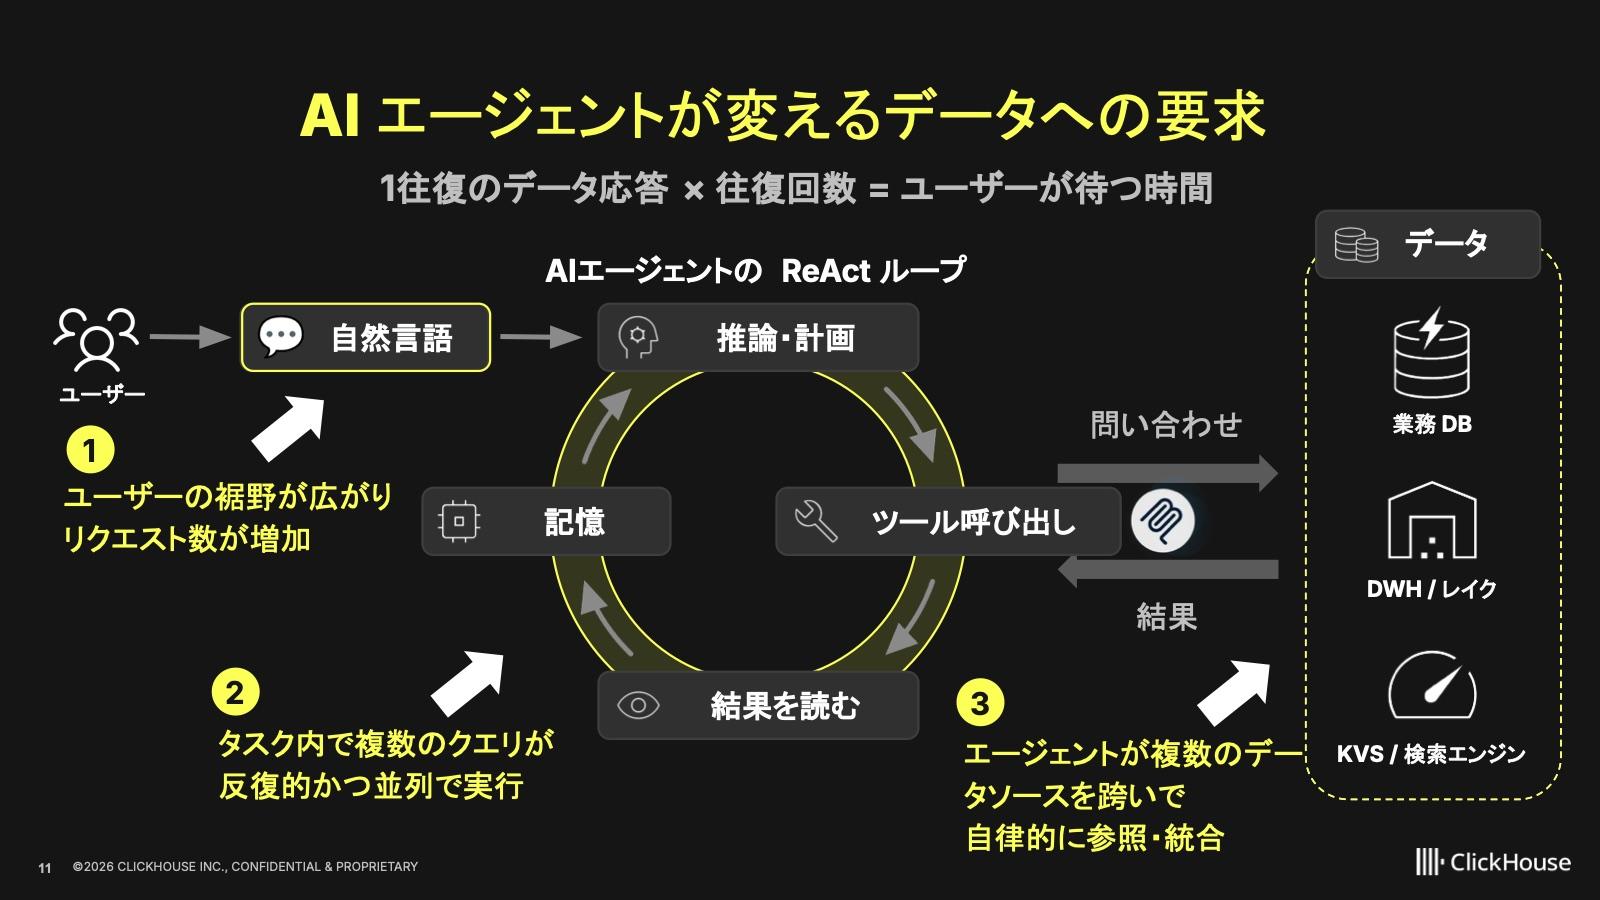
しかも、自然言語で問い合わせられるので、使う人の裾野が今までより圧倒的に広がります。タスクの中ではサブエージェントが動き、並列にクエリをどんどん投げます。さらに、複数のデータソースをまたいで自律的に参照します。どれも、クエリが増える要因です。
データ分析の世界ではこれまで、複雑なSQLを事前に組み立てて一括で投げるのが普通でした。これからは、細切れに聞いては返す、を繰り返す割合が増えていきます。そうなると、クエリの低レイテンシがこれまで以上に重要になり、データ基盤のコストパフォーマンスもよりシビアに見なければなりません。従来のデータウェアハウスの限界を突破する必要がある、というのはそういう意味です。
履歴も直近も、1つの基盤で受け止める
では、どういう基盤が必要なのか。私たちは、夜間バッチとストリームの2つの流れを受け止めて、履歴も直近も全部1つに載せる「統合ストア」が必要だと考えています。エージェントからは応答と頻度の要求が爆発的に上がるので、ミリ秒で返すこと、並列で処理すること、長期データを低コストで持てることが重要になります。その役割を担うのがClickHouseです。
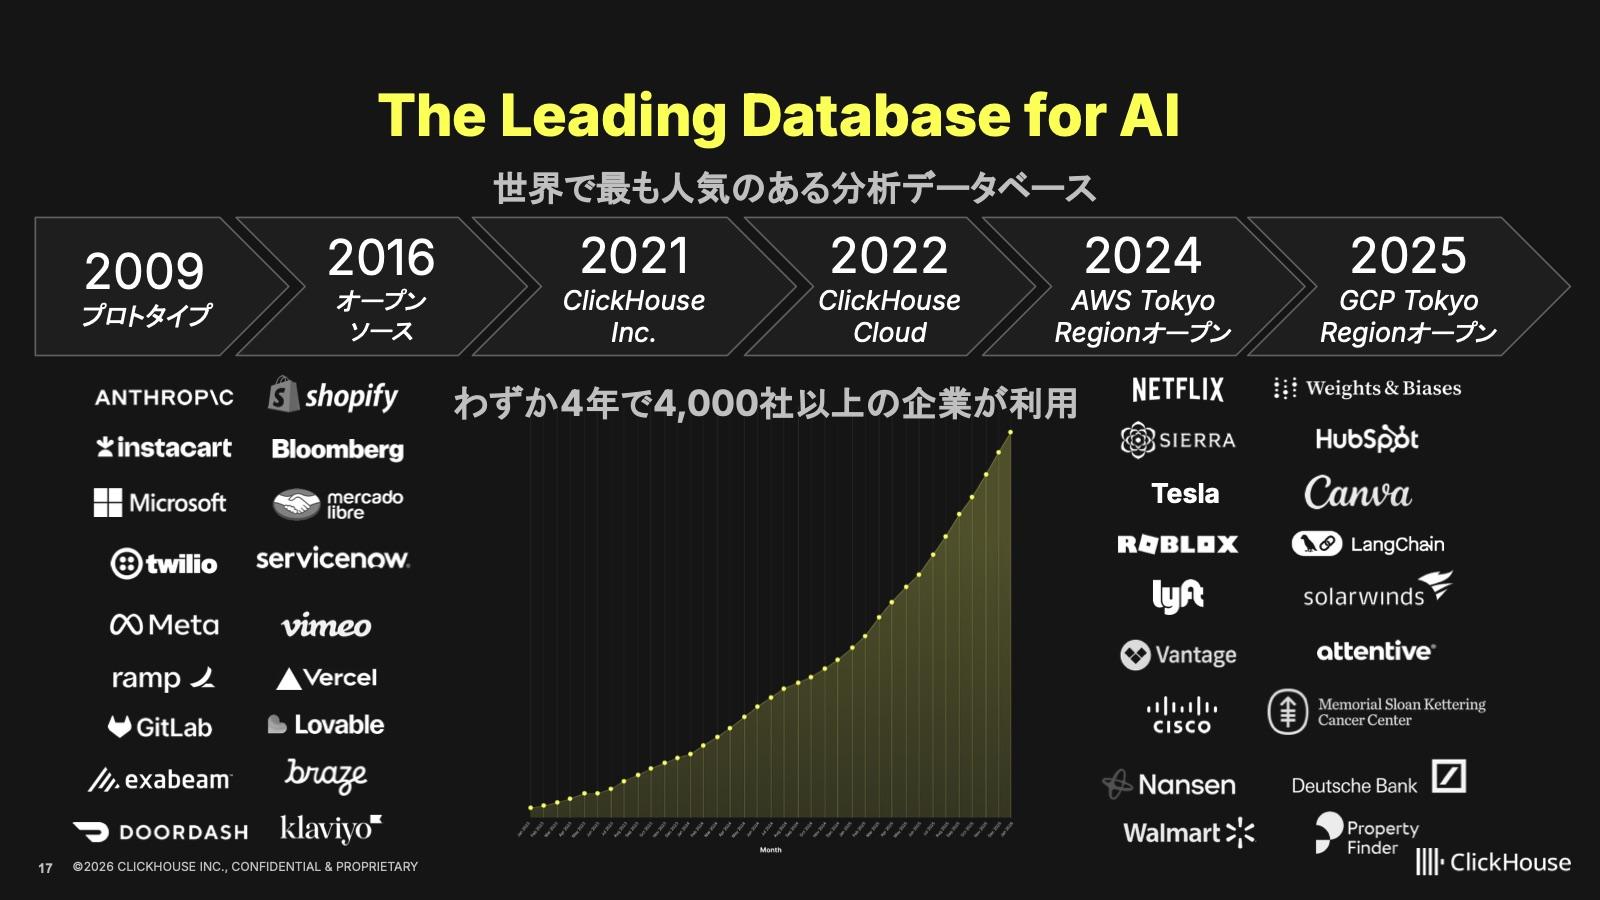
ClickHouseは、オープンソースのカラム型OLAPデータベースです。初めて聞いたという方もいるかもしれませんが、実は最近出てきたものではありません。2009年に、Webサイトのクリックストリームをリアルタイムに集計して分析するために作られ、2016年にOSS化しています。今ではGitHubのスターが5万を超えていて、ClickHouse Cloudが出てから4年で4,000社以上の企業に導入いただいています。
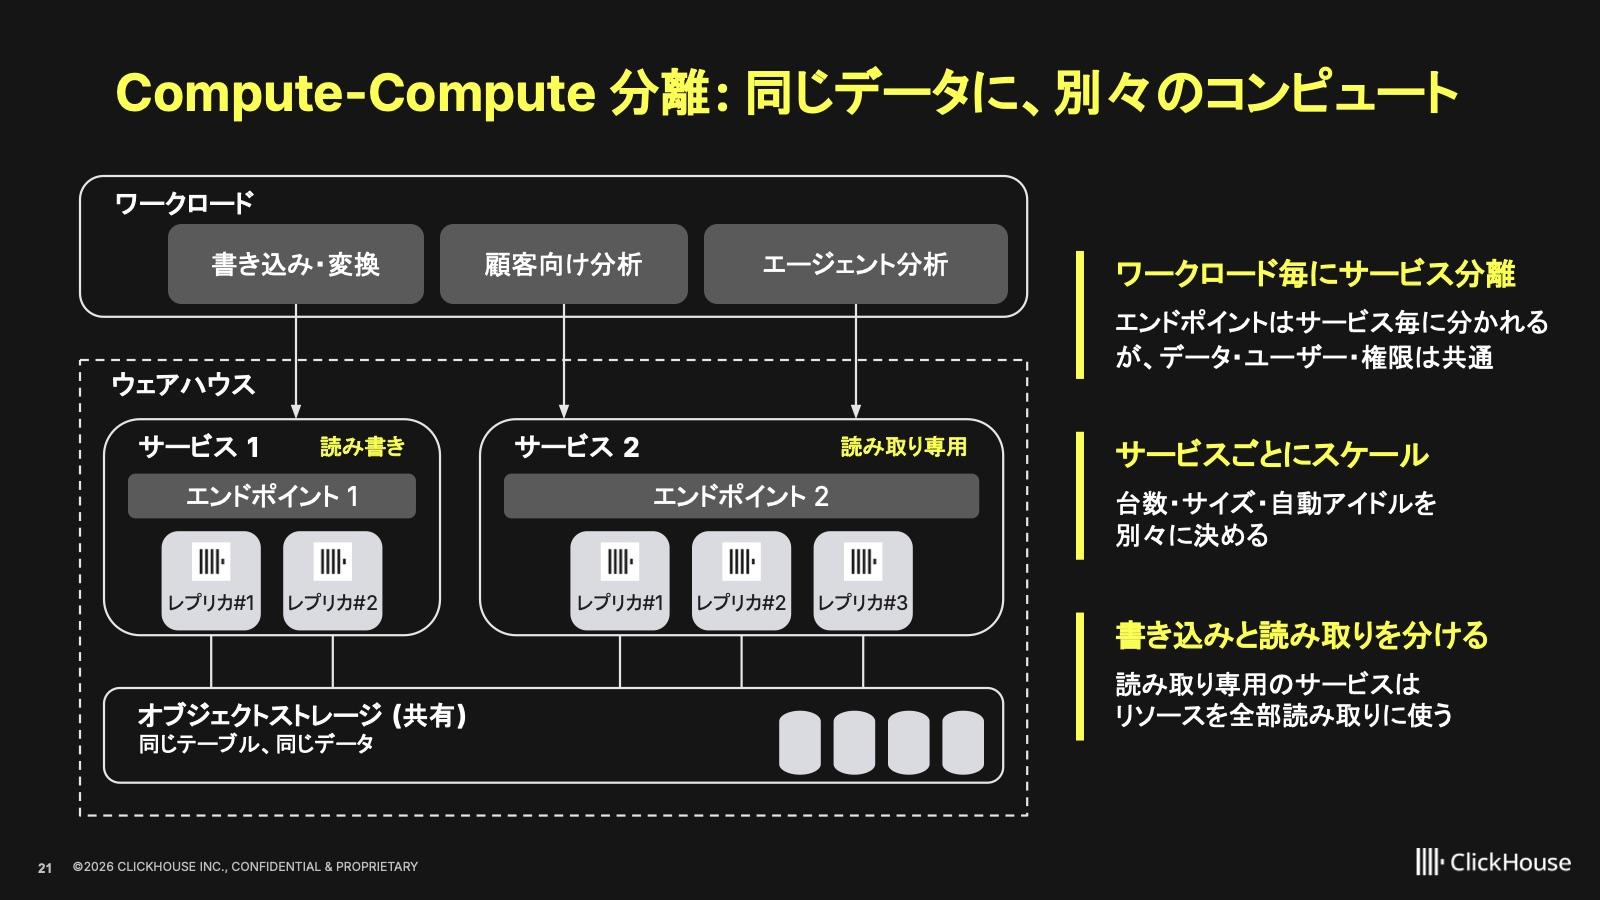
提供形態は、フルマネージドのClickHouse Cloud、データプレーンだけをお客様のアカウントに置くBYOC、そしてOSSの3つですが、ほとんどのお客様はClickHouse Cloudを選んでいます。ClickHouse Cloudは、コンピュートとストレージ、メタデータの層が分離されているので、非常にスケールしやすい仕組みになっています。同じデータに対してワークロードごとに別々のコンピュートを割り当てることもできるので、たとえば書き込みと、エージェントからの分析を分けて動かすといった使い方ができます。
ClickHouseはなぜ速いのか
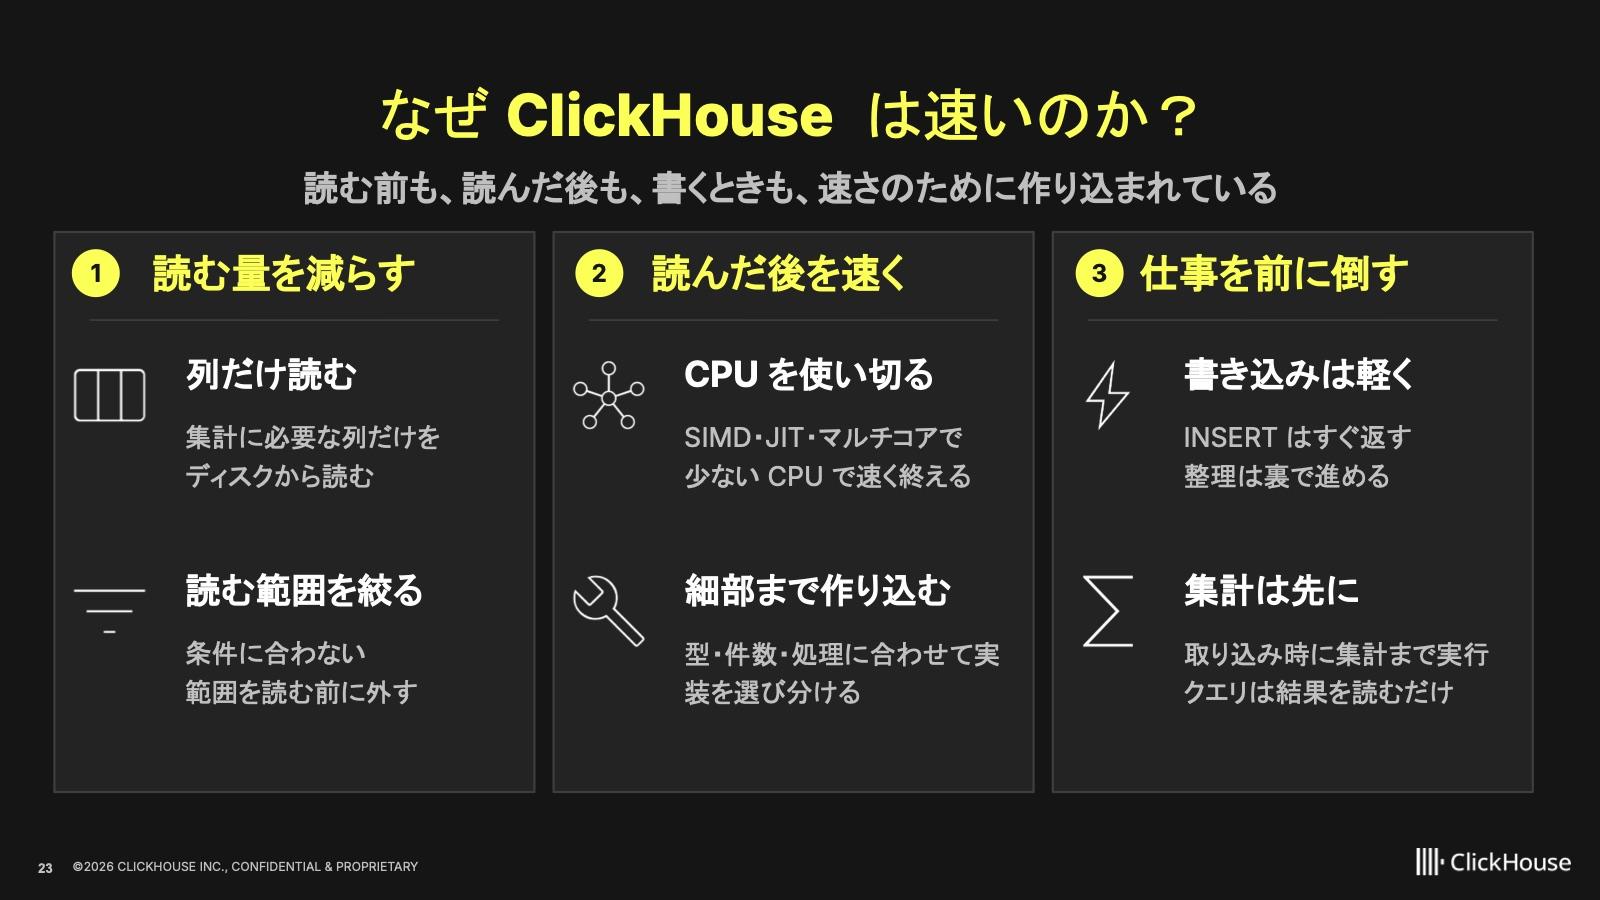
では、なぜClickHouseは速いのか。私たちは「読む量を減らす」「読んだ後を速く」「仕事を前に倒す」の3つで整理しています。読む前も、読んだ後も、書くときも、とにかくリアルタイムにデータを出し入れできる速さのために作り込まれています。
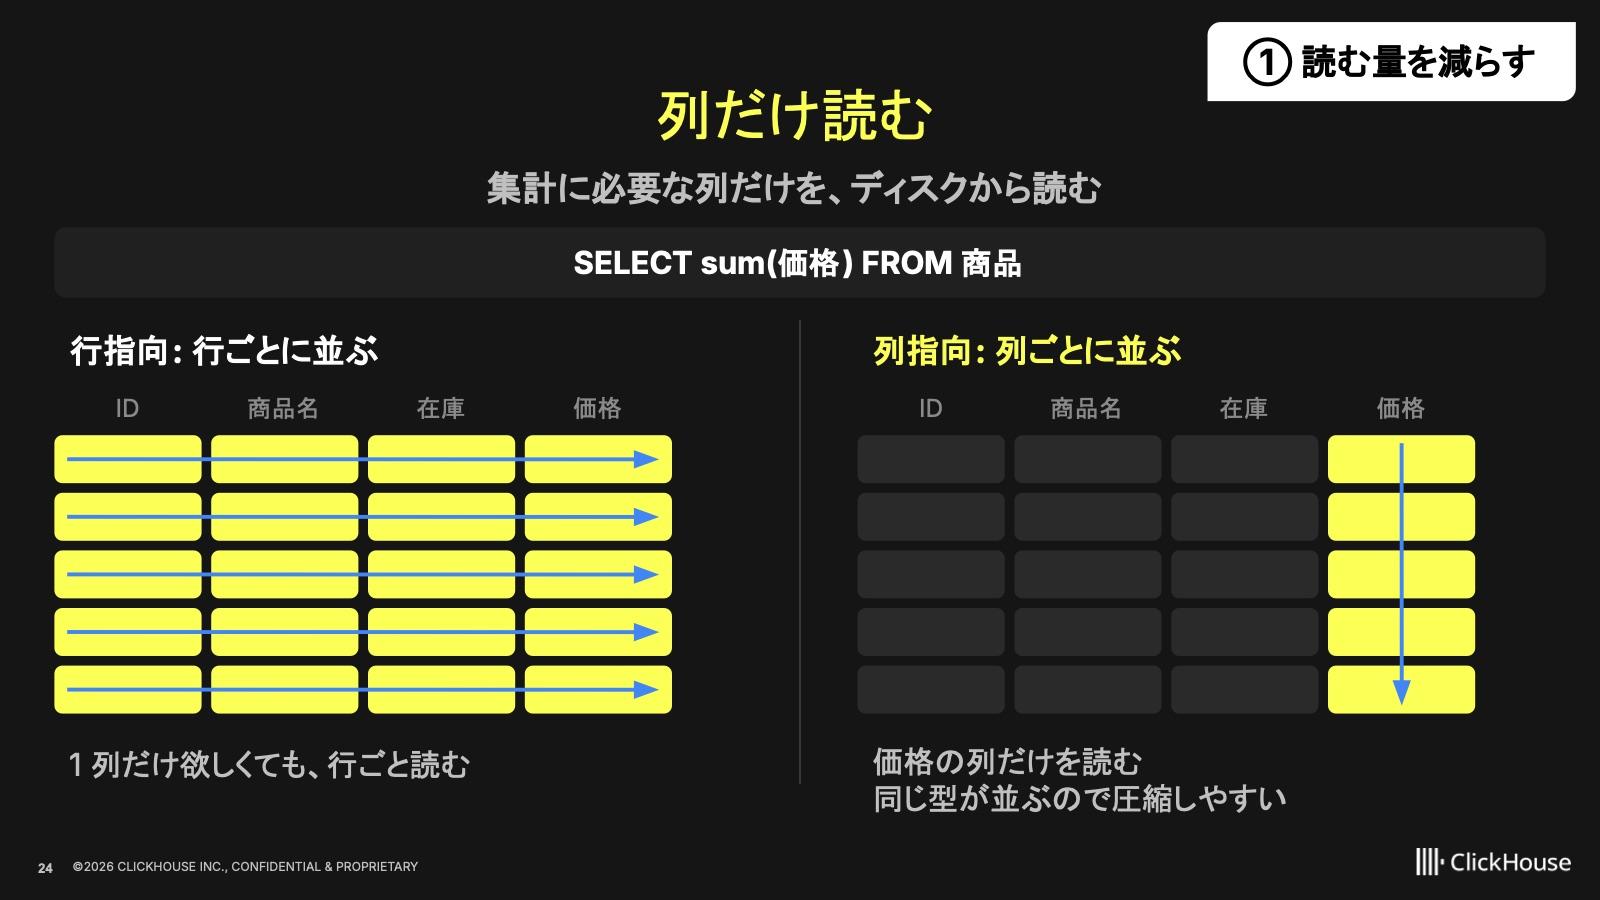
1つ目の「読む量を減らす」は、データエンジニアリングに携わっている皆さんには当たり前の話かもしれません。列指向なので、集計に必要な列だけを読みます。同じ型のデータが並ぶので、圧縮も効きやすくなります。
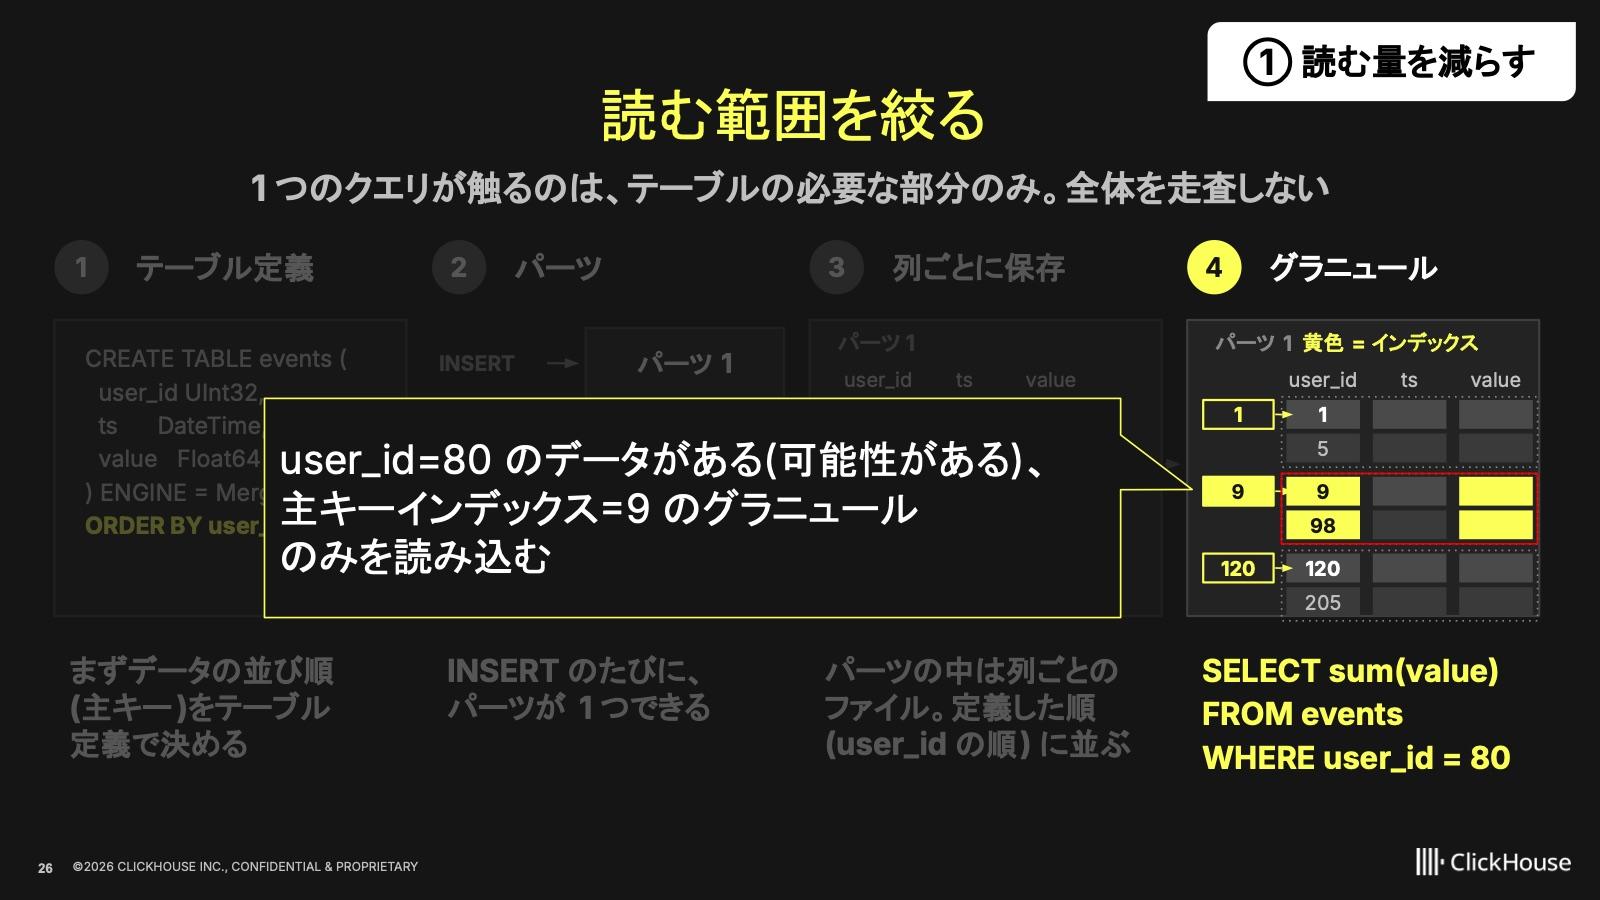
少しユニークなのが、読む範囲そのものを絞る仕組みです。テーブルを作るときにORDER BYでデータの並び順を決めておくと、データはその順に書かれ、一定の行数ごとの先頭の値がインデックスに入ります。たとえばユーザーIDが80のデータを探すとき、インデックスに1、9、120と入っていれば、あるとしたら「9」の範囲だけです。それ以外は絶対に入っていないので、読み飛ばします。列でI/Oを減らすだけでなく、読む範囲も極力絞っているわけです。
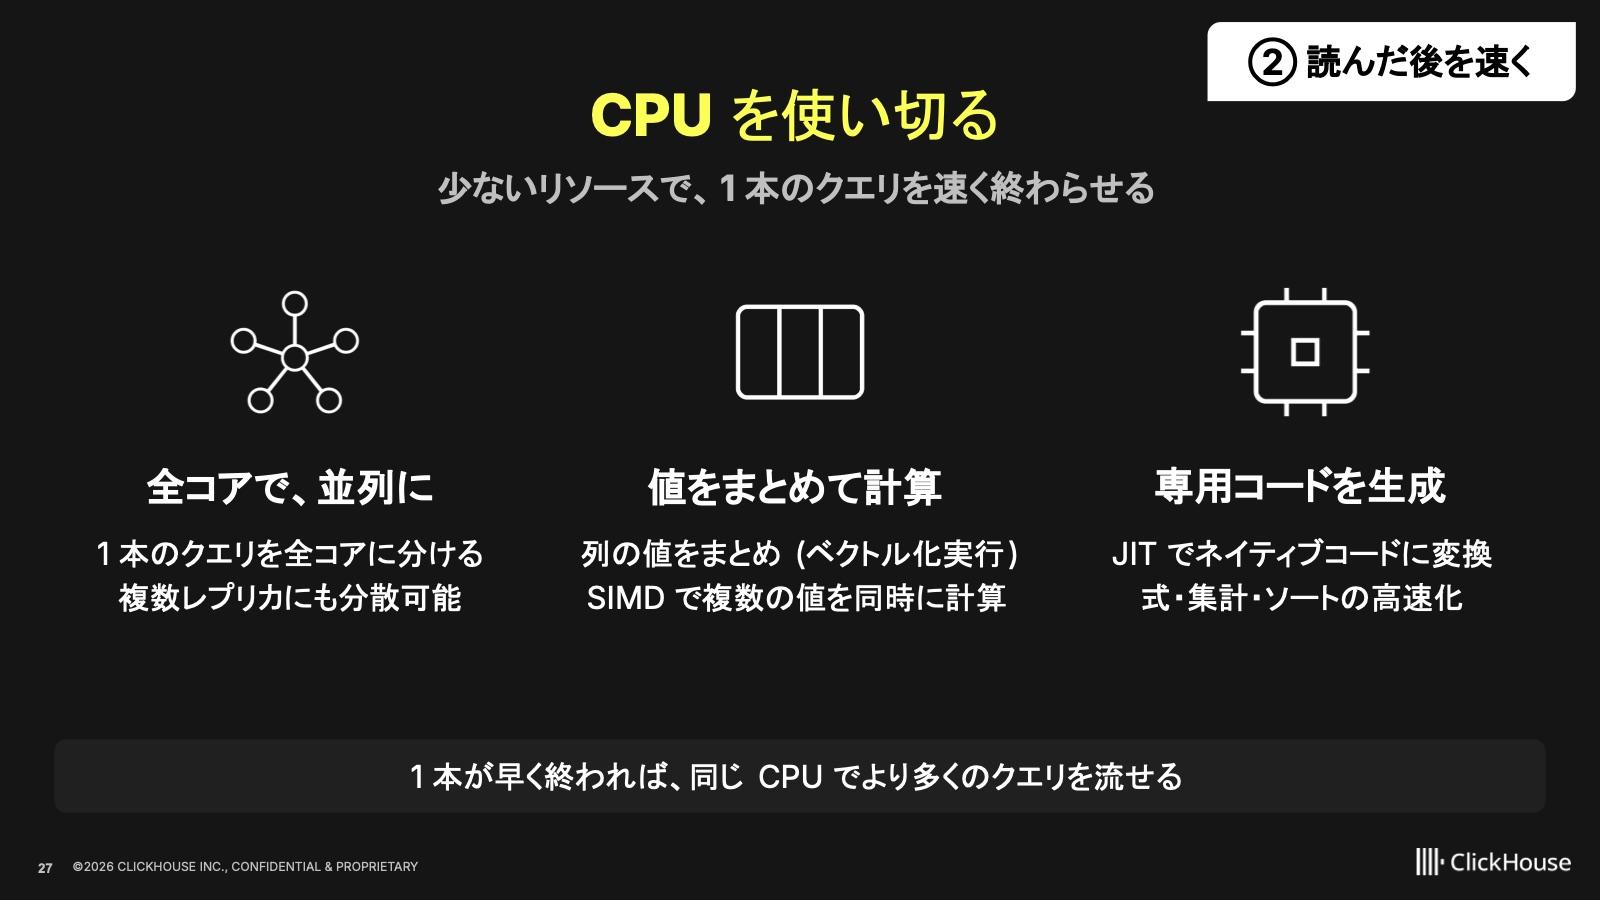
2つ目の「読んだ後を速く」では、まず1本のクエリを使えるコアで分けて並列に実行します。その上でCPUのレベルでも、SIMDで複数の値をまとめて計算したり、式をJITで専用のネイティブコードにしたりして、できるだけ少ないリソースで効率よく処理します。
こうした作り込みは細部にまで及んでいて、GROUP BYやJOINの裏で使うハッシュテーブルは30種類以上を用意し、クエリやデータに応じて使い分けています。数値型だけでも約20種類あり、値を必要な大きさで持てます。
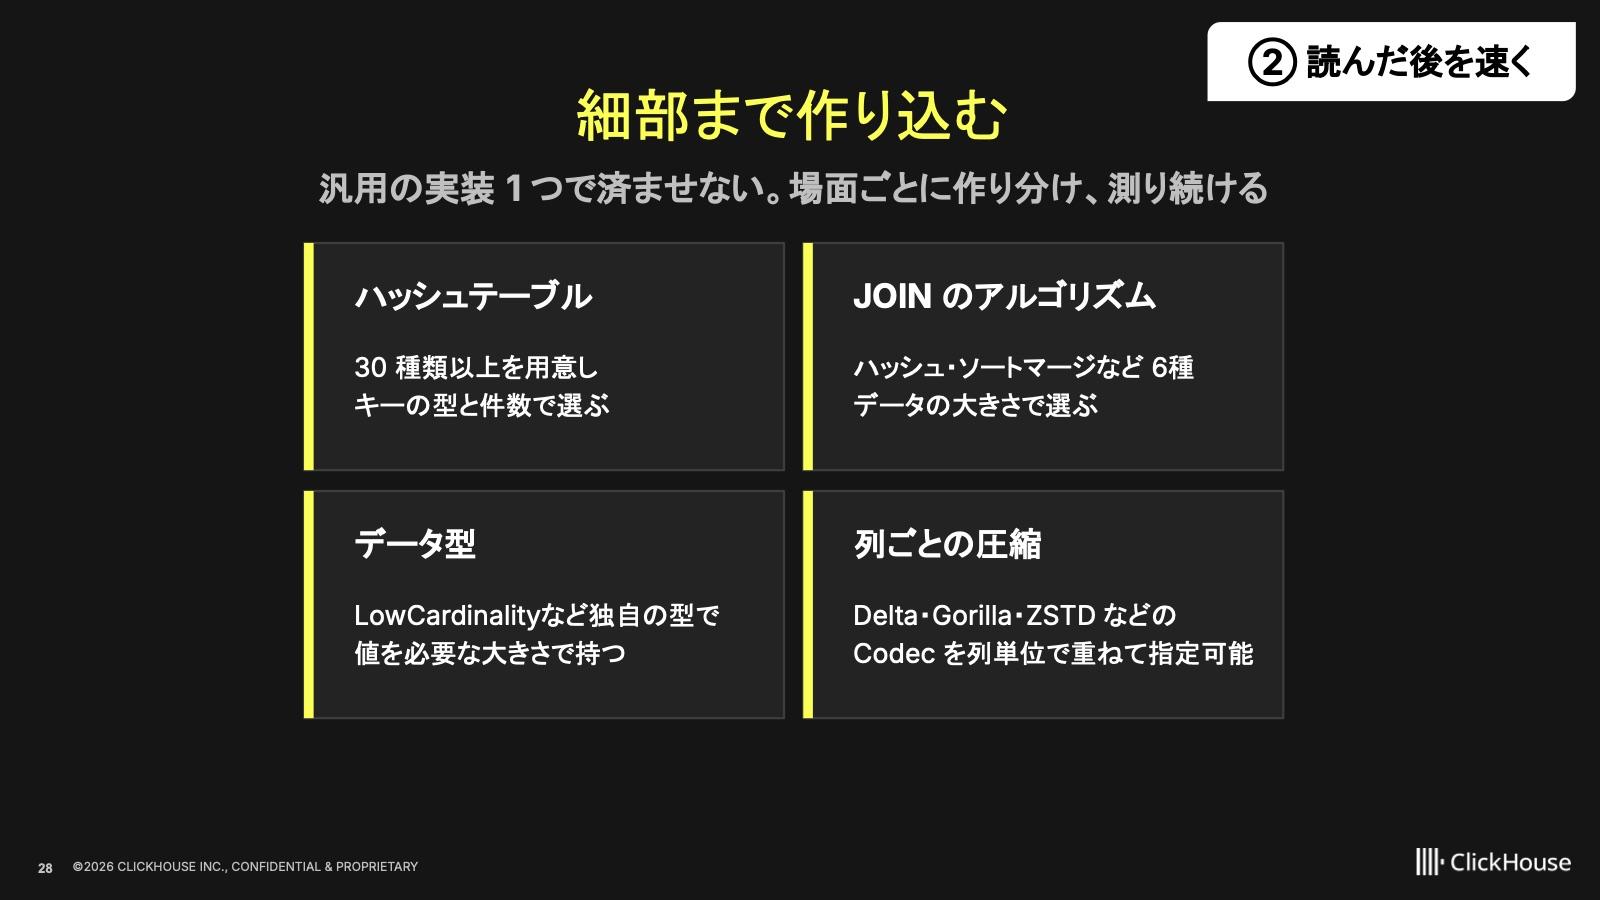
余談ですが、「ClickHouseはなんでこんなに安いんですか」と聞かれることがよくあります。答えは、まさにこうした積み重ねです。同じ性能を少ないリソースで出せれば、使うコンピュートが減って安くなる。速さへのこだわりが、そのままコスト削減にも効いてくるんです。
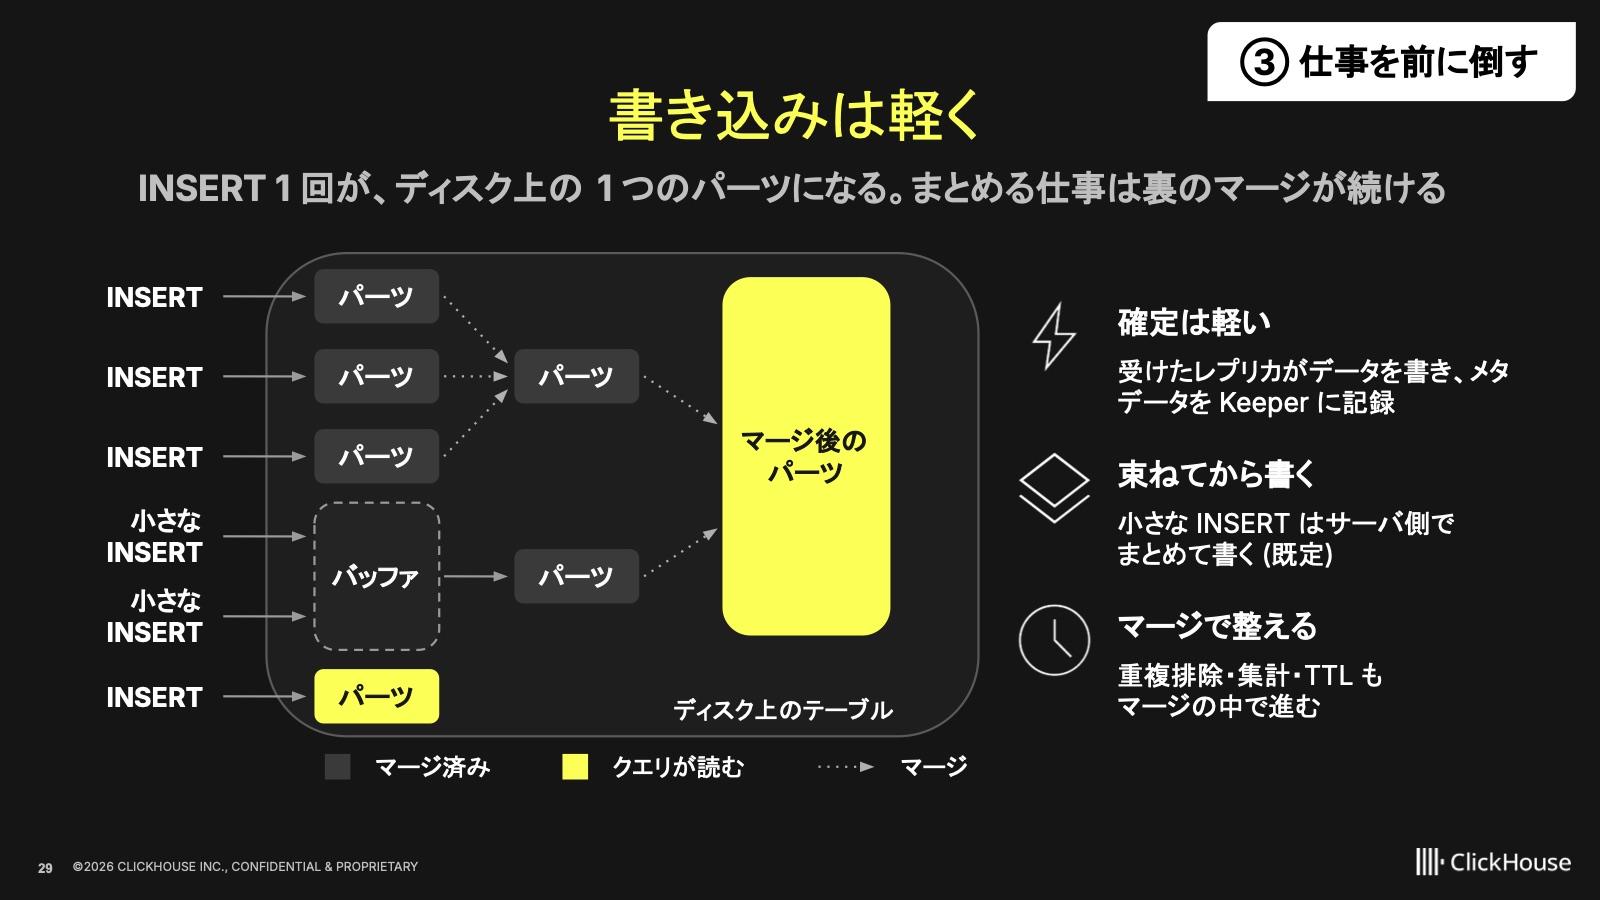
3つ目の「仕事を前に倒す」は、書き込みと集計の話です。INSERTは1回ごとにディスク上へ書き込んですぐに返し、増えたデータの塊は裏側のマージ処理でまとめます。重複の統合や古いデータの削除も、このマージの中で進めます。
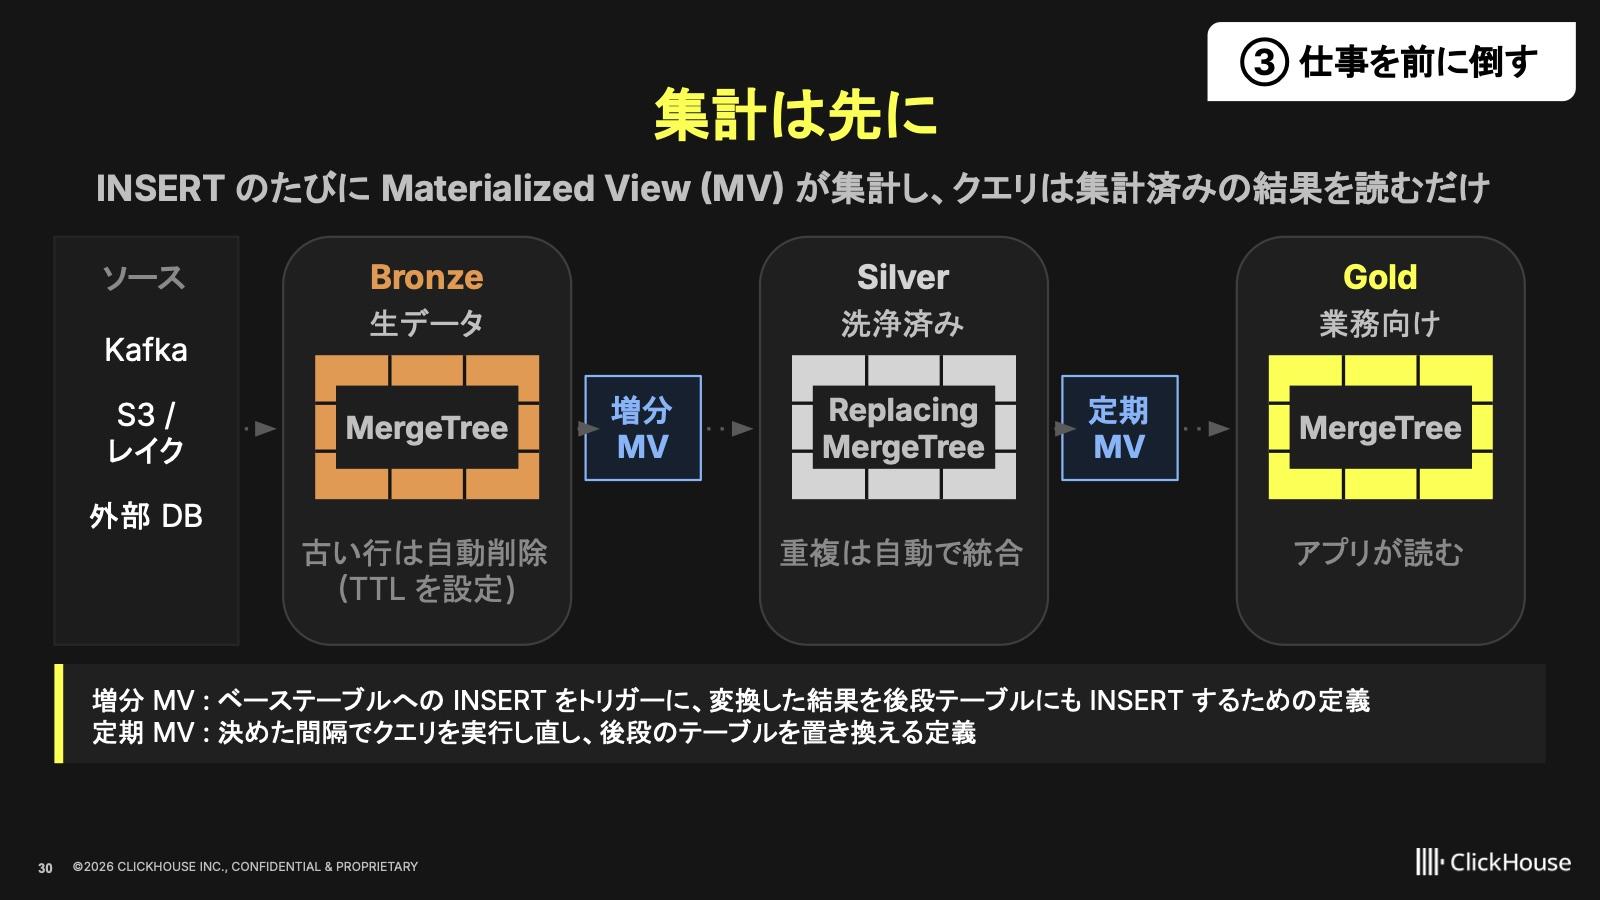
さらに特徴的なのが、マテリアライズドビューで集計を先に済ませておくことです。一般的なデータベースとは少し違って、ClickHouseのマテリアライズドビューは、テーブルとテーブルの間でデータを更新するパイプラインの定義だと思ってください。ベーステーブルにINSERTするたびに発火し、増分を次のテーブルへ書き込みます。データを入れるだけで、エージェントやユーザーが読む最終形のテーブルまでできあがるので、クエリが速くなる、というカラクリです。
置き換えるか、横に置くか
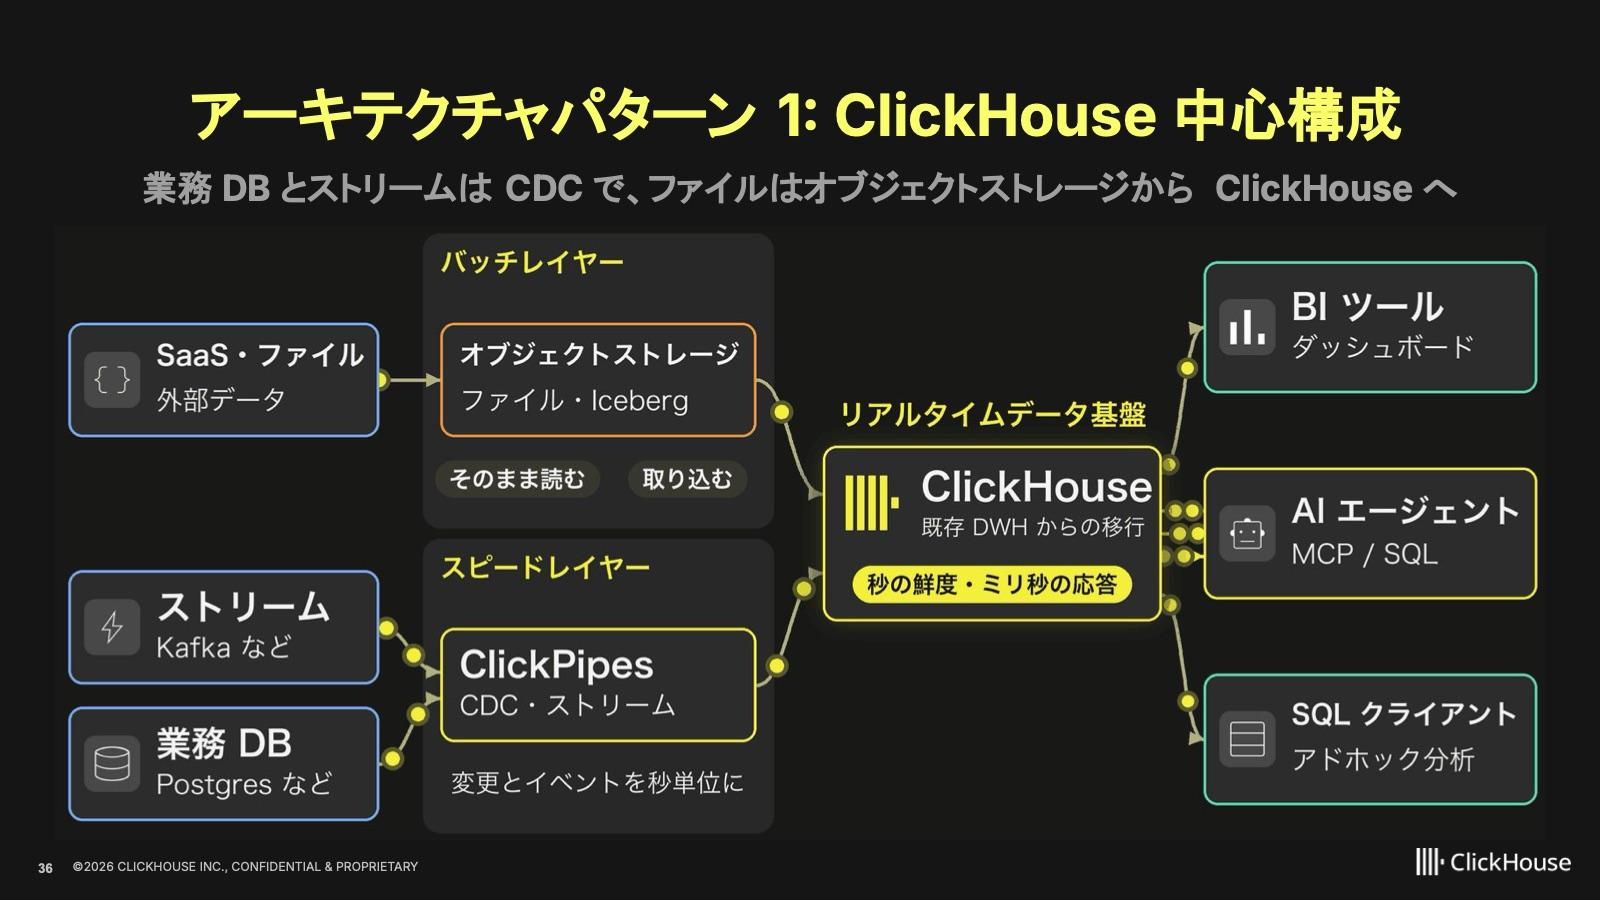
では、ClickHouseをデータ基盤にどう組み込んでいくのか。ClickHouseでは「Agentic Data Stack」という全体像を提唱していて、自然言語で分析できるチャットのClickHouse Agentsや、画面上の設定だけで継続的にデータを取り込めるClickPipesなどを揃えています。ここでは、組み方を2つのパターンでご紹介します。
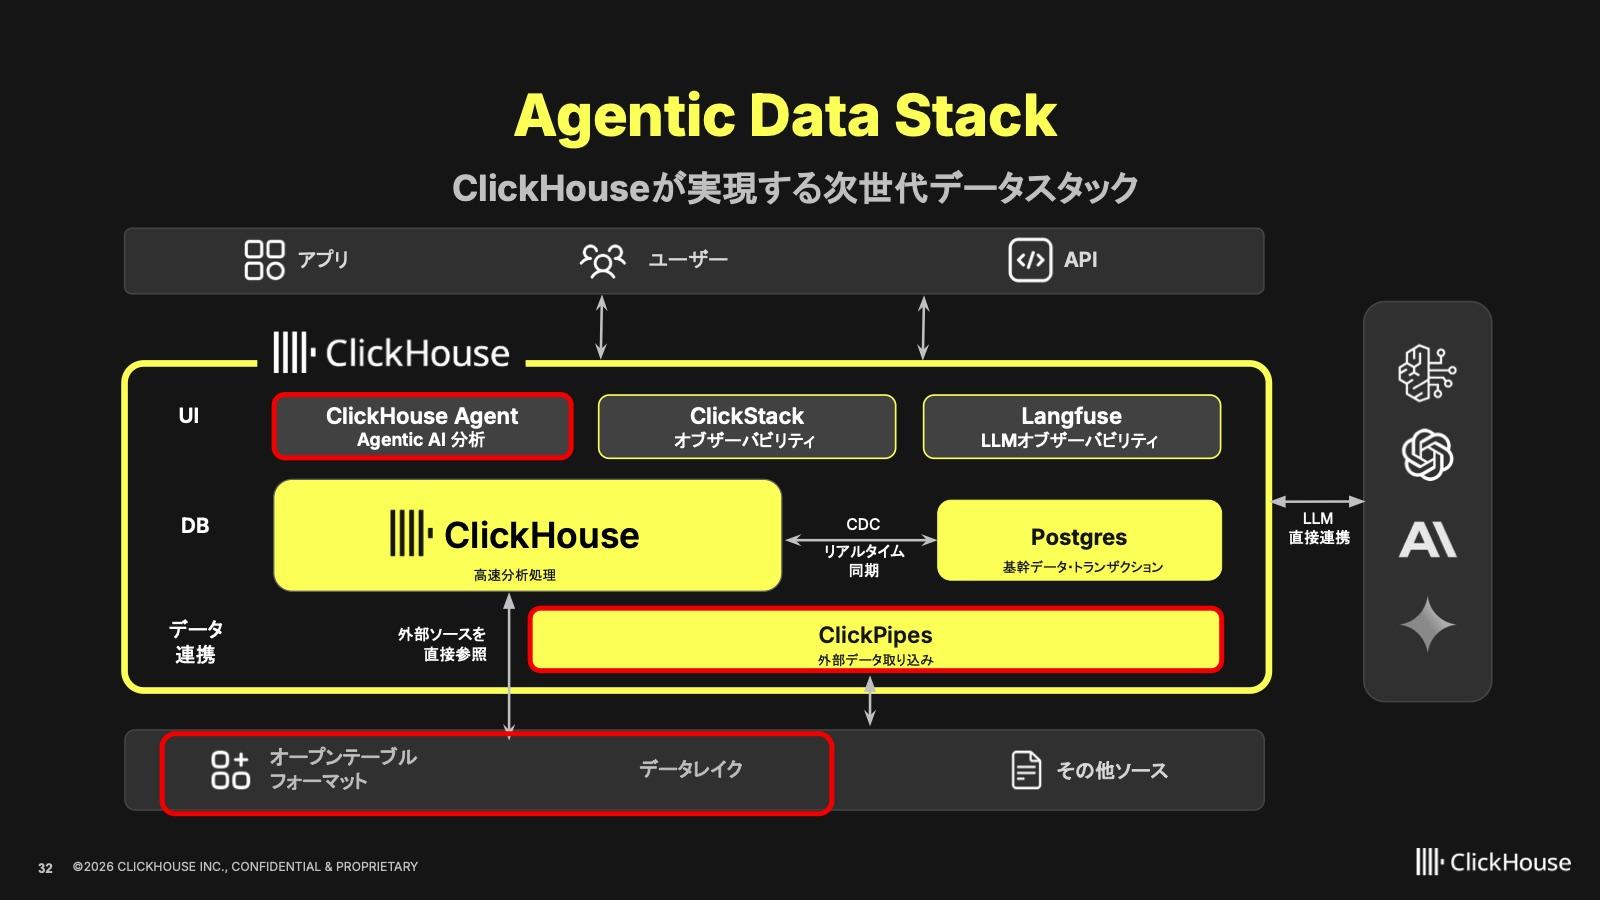
1つ目はめちゃくちゃシンプルで、DWH的なものをClickHouseに寄せるパターンです。ファイルなどはオブジェクトストレージ経由で、業務データベースやストリームはClickPipes経由で流し込み、人が使うBIにも、エージェントからさみだれに来る並列のアクセスにも応えます。
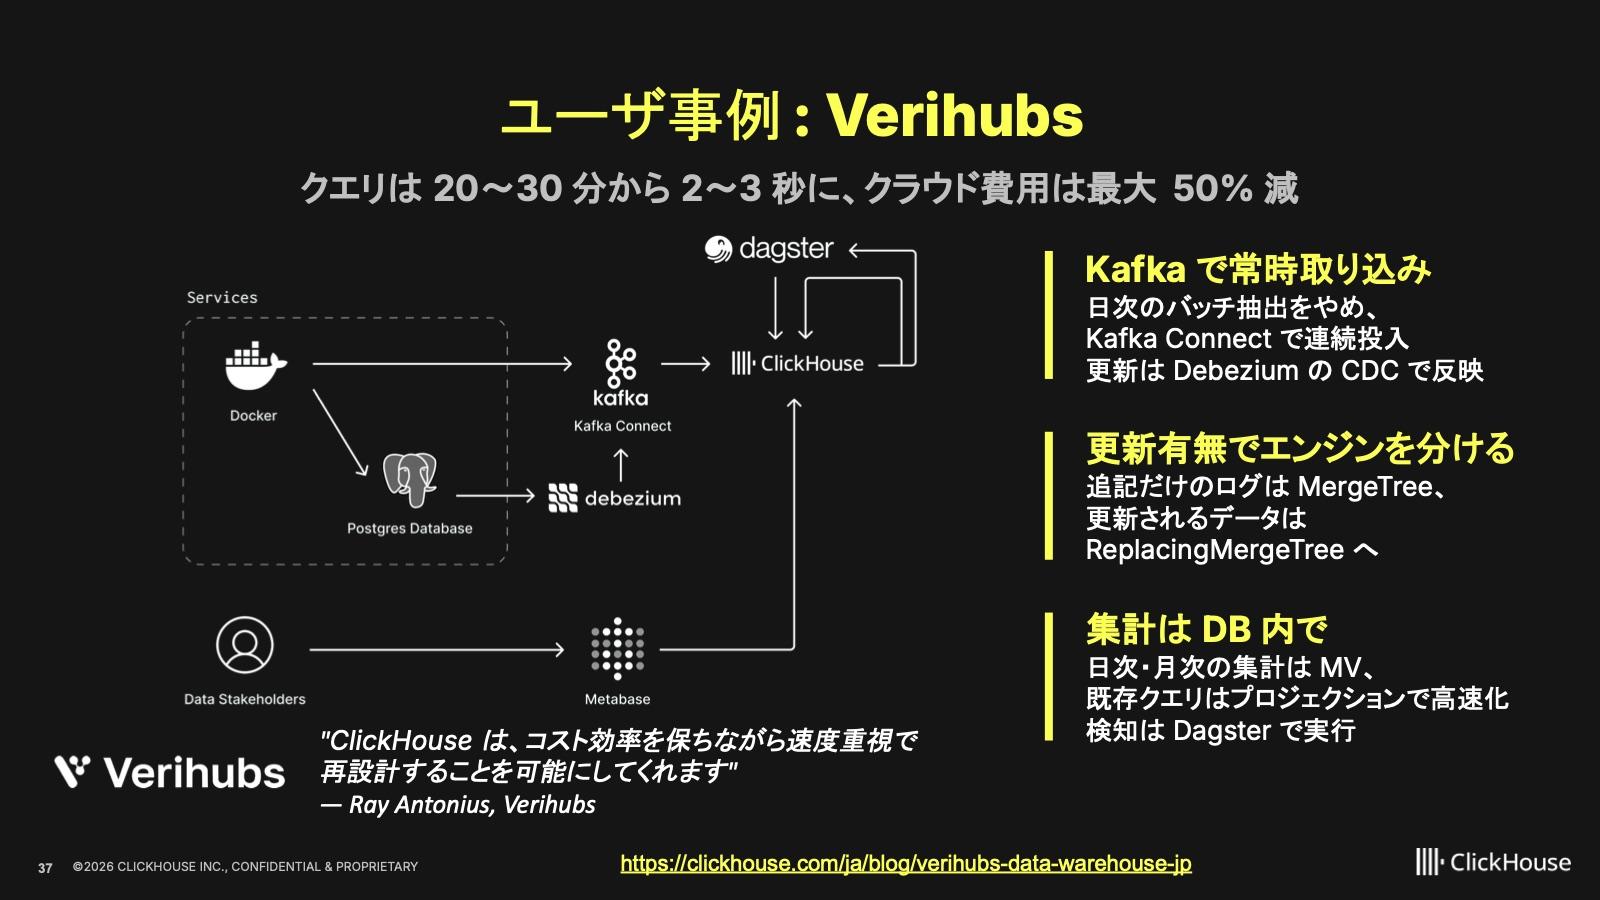
この構成の事例が、インドネシアのVerihubsさんです。銀行やフィンテック向けに、顔認証やワンタイムパスワードなどの本人確認をAPIで提供していて、利用データから顧客ごとの利用料を照合し、請求書の発行につなげています。以前は毎朝のバッチでPostgresベースのデータウェアハウスにデータを入れていましたが、そこをClickHouseに置き換え、取り込みもKafkaによるストリームに変えました。結果として、20〜30分かかっていた分析処理が2〜3秒に縮まり、費用も最大50%削減できたという事例です。
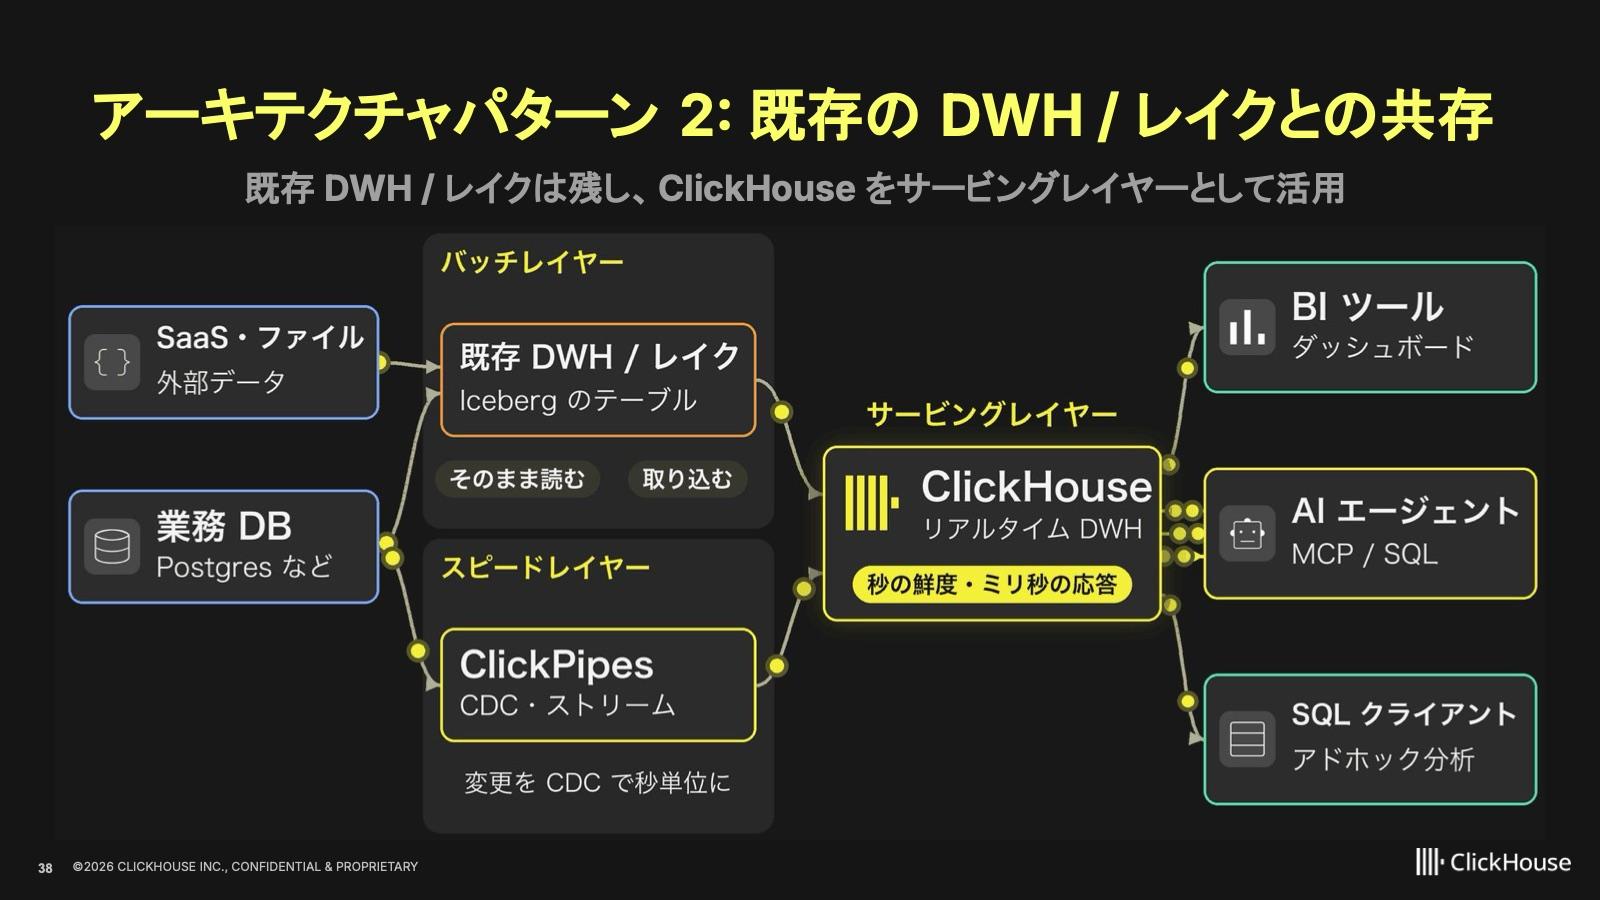
ただ、今の基盤はなかなかすぐには動かせない、というケースも多いと思います。そこで2つ目が、既存のデータウェアハウスやレイクは残して、ClickHouseをサービングレイヤーとして使うパターンです。既存のDWHにエージェントからのアクセスを受け続けさせるのは大変なので、そのワークロードをClickHouseに逃がします。コスト増を抑えながら、パフォーマンスも上げられる構成です。
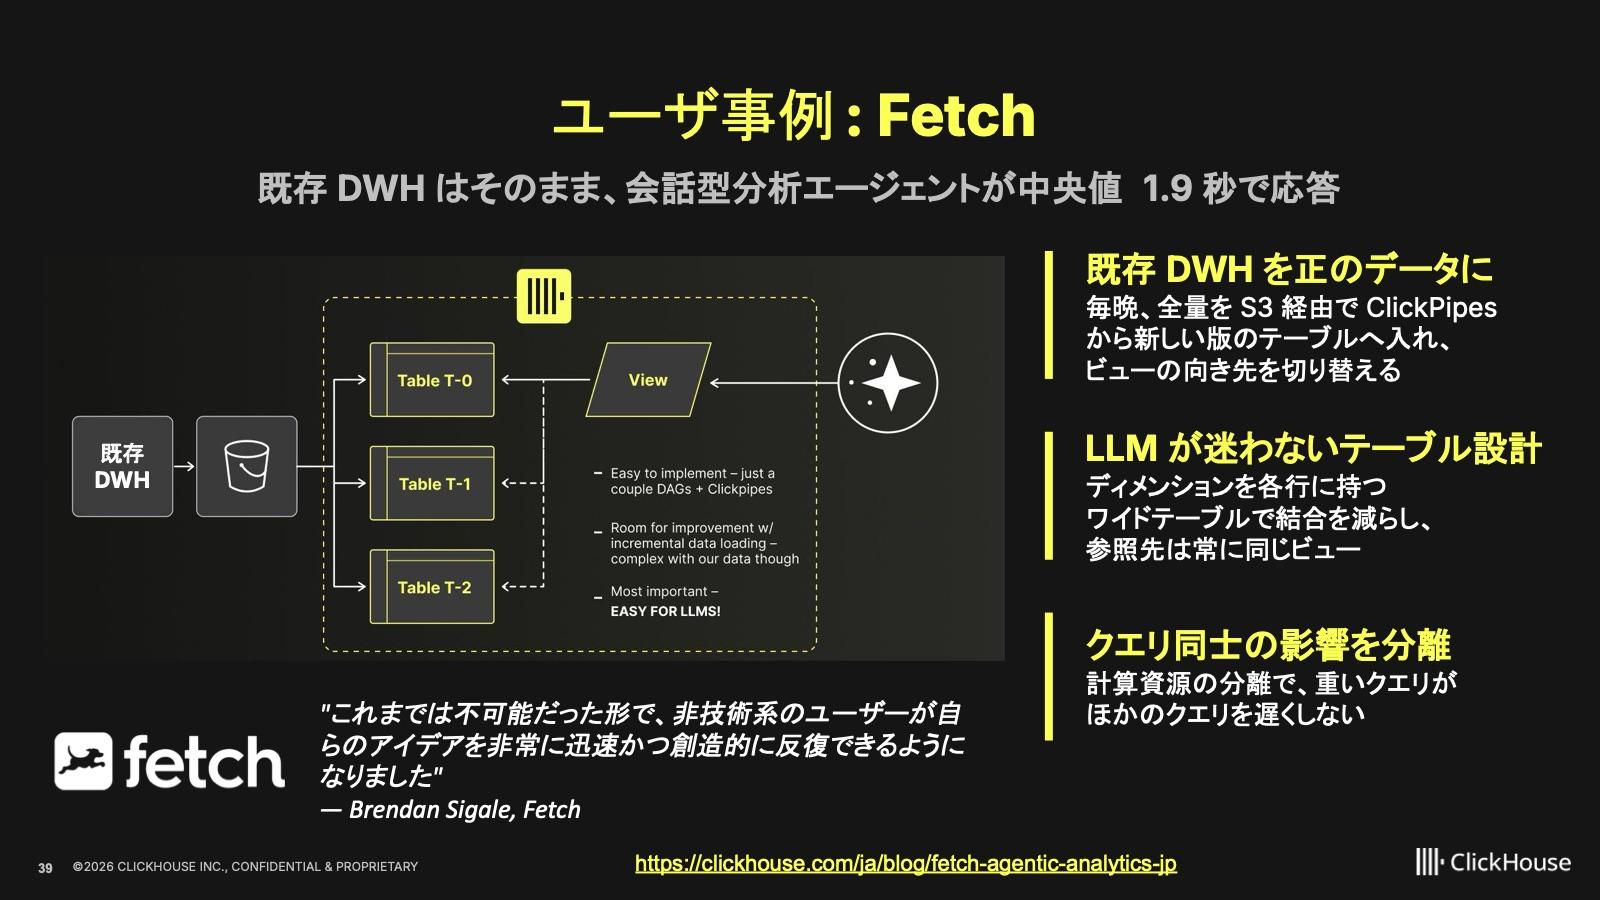
こちらの事例が、アメリカでポイント還元アプリを提供しているFetchさんです。SaaS型のデータウェアハウスだけでは要件を満たせなかったため、そこにある1日1,500億行の購買データを毎晩S3に連携し、ClickPipesでClickHouseへ流し込んでいます。そのテーブルにエージェントからアクセスさせ、エンジニアでない人が自然言語でデータを取り出しています。応答は中央値1.9秒です。
エージェント時代のデータ基盤をどう描くか
最後に、ClickHouseを取り巻くワークロードを1枚にまとめた全体像をご紹介します。今日はデータレイクやデータウェアハウスの部分を中心にお話ししましたが、私たちは、ClickHouseを中間レイヤーに置くことを考えています。システムやアプリ、セキュリティのログも、ベクトルデータのような非構造化データも、そこに集めていく。そういうアーキテクチャがはまるケースも出てくるのではないかと思っています。
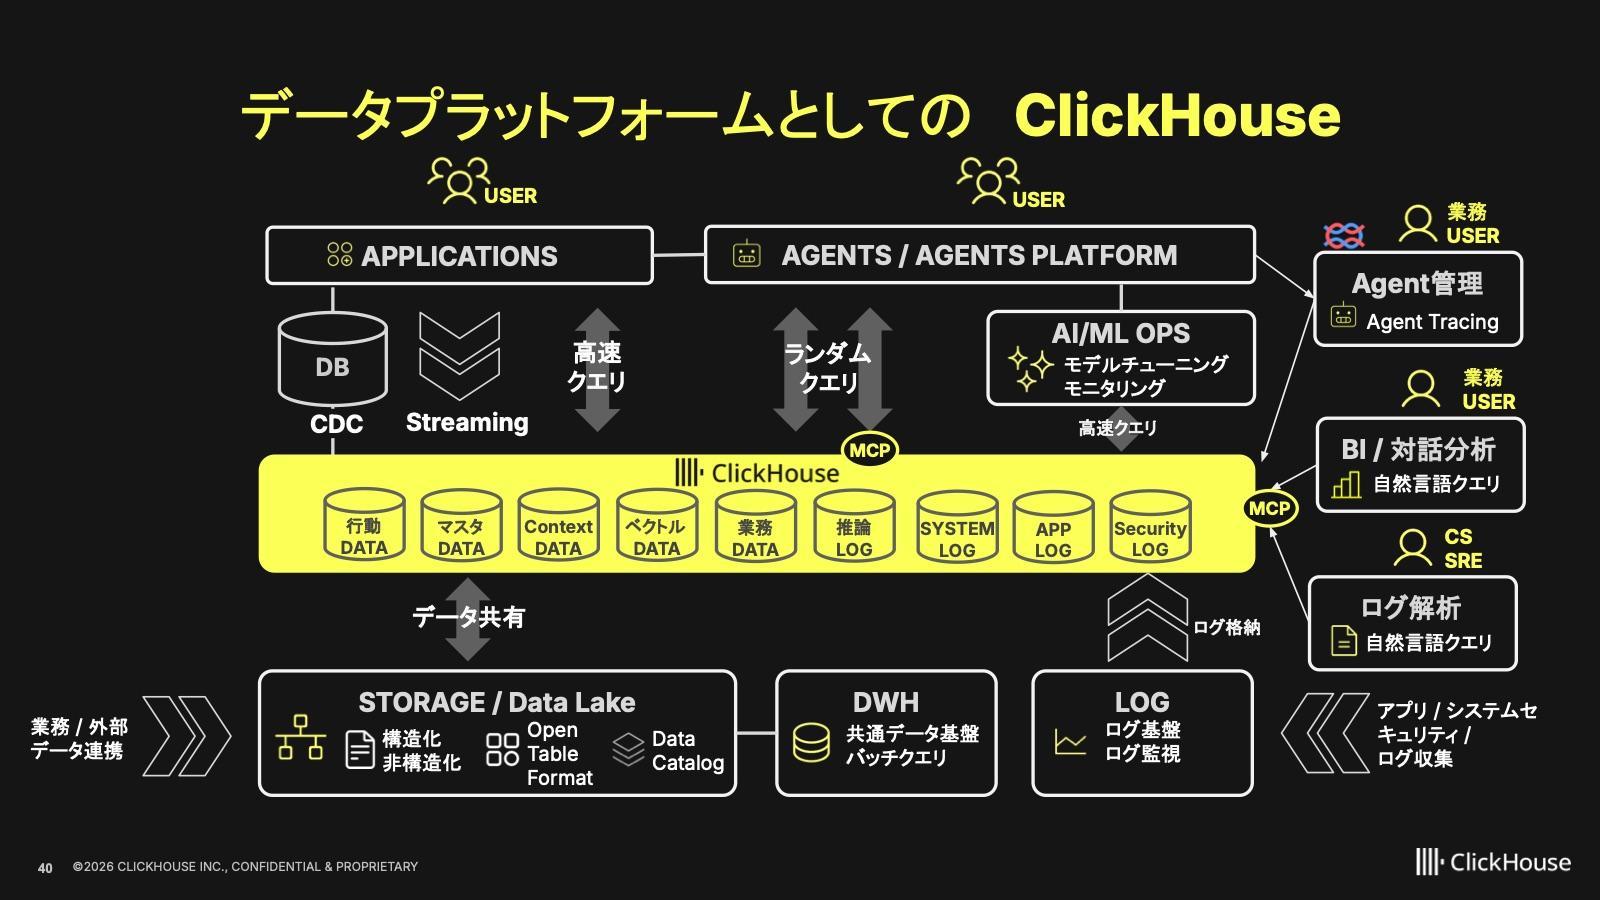
この手の話では長らく、「サイロ化を解消するために、データレイクにデータを貯めましょう」と言われてきました。実は私自身も、昔はそう言っていました。ただエージェントの時代には、アプリケーションもエージェントも、同じデータをClickHouseを介して高速に取り出せるようにしておく。そんな構成も、次の一つの選択肢としてありなんじゃないかと感じています。
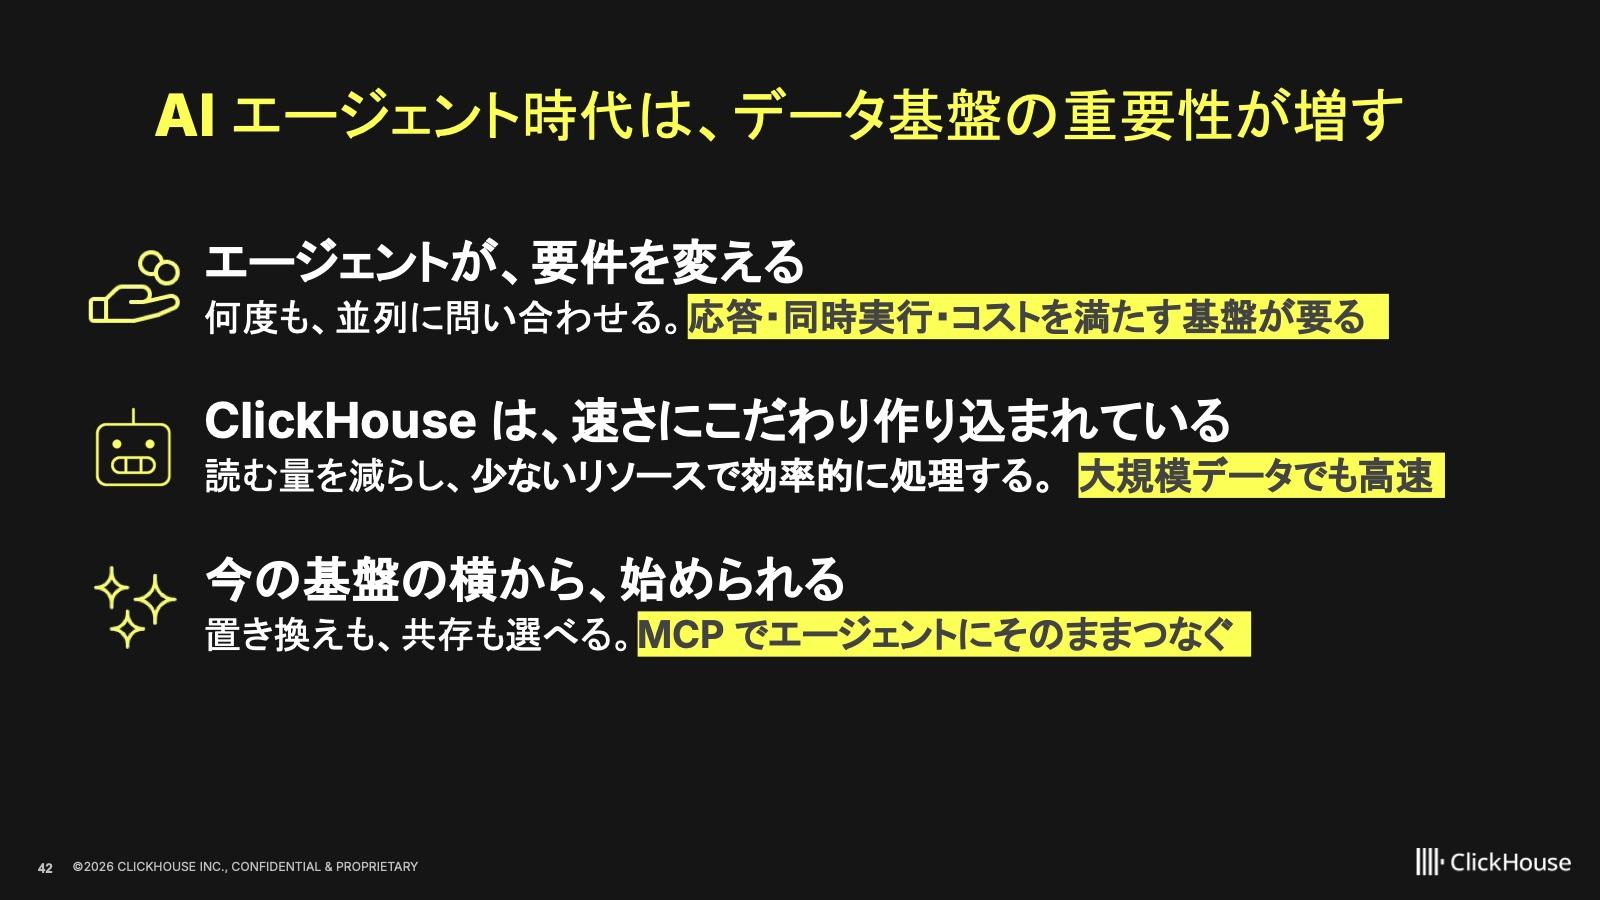
AIエージェントの時代になると、データ基盤の重要性は増します。ClickHouseは速さにこだわって作り込まれていて、大規模なデータでも速いのが特徴です。そして既存のデータ基盤をお持ちの方も、置き換えるだけでなく、横に置くという選択肢も取れます。それが今日お伝えしたいメッセージです。
ClickHouse Cloudは30日間の無料トライアルですぐに始められます。分からないことがあれば、ドキュメントのAsk AIに聞いてみてください。また、MCPやAgent SkillsでClickHouseのベストプラクティスを読み込ませれば、エージェントから本当に素早くClickHouseを立ち上げられます。ぜひやってみてください。
アーカイブ動画・発表資料
イベント本編は、アーカイブ動画を公開しています。また、当日の発表資料も掲載しています。あわせてご覧ください。
▼動画はこちら
※動画の視聴にはFindyへのログインが必要です。