【Data Engineering Summit 2026】事業活動を AI Ready にする攻めと守りのデータエンジニアリング
2026年10月9日、ファインディ株式会社が主催するイベント「Data Engineering Summit 2026」が、東京建物 ぴあ シアター&カンファレンスにて開催されました。
本記事では、株式会社CARTA HOLDINGS CARTA ZERO VP of Dataの近森 淳平さんによるセッション「事業活動を AI Ready にする攻めと守りのデータエンジニアリング」の内容をお伝えします。
■プロフィール
近森 淳平(株式会社CARTA HOLDINGS CARTA ZERO VP of Data)
株式会社CARTA HOLDINGS CARTA ZEROでVP of Dataを務め、データに関わる領域を幅広く担う。
Snowflake Data Superheroes(2024-2026)X:@pei0804
自己紹介
CARTA ZEROでVP of Dataをやっている近森です。インターネットでは「pei0804」と名乗っていることが多いので、今日はペイで覚えてください。
社内ではデータに関することを全部やっているような立場で、経営資源でよく言う「人・モノ・金」に、データも足したいよね、というポジションです。Snowflake Data Superheroesもやっているので、Snowflakeには少し詳しいです。
AIを使っても、差はつかない
皆さんも大体AIを使っていると思いますが、AIは事業活動に何をもたらしたのか。私の認識では、今のAIは「履くだけで速く走れる靴」、いわゆるスーパーシューズとあまり変わらないものです。
では、その靴を全員が買って履いたらどうなるか。全員が等しく速くなるので、顧客から見た差は別にない。じゃあ使わない方が合理的かというと、これが最悪で、みんな履くだけで速くなっているので、使わないと置いていかれてしまう。使っても差はつかないのに、使わないと置いていかれる。私たちは今、そういうゲームをやっています。
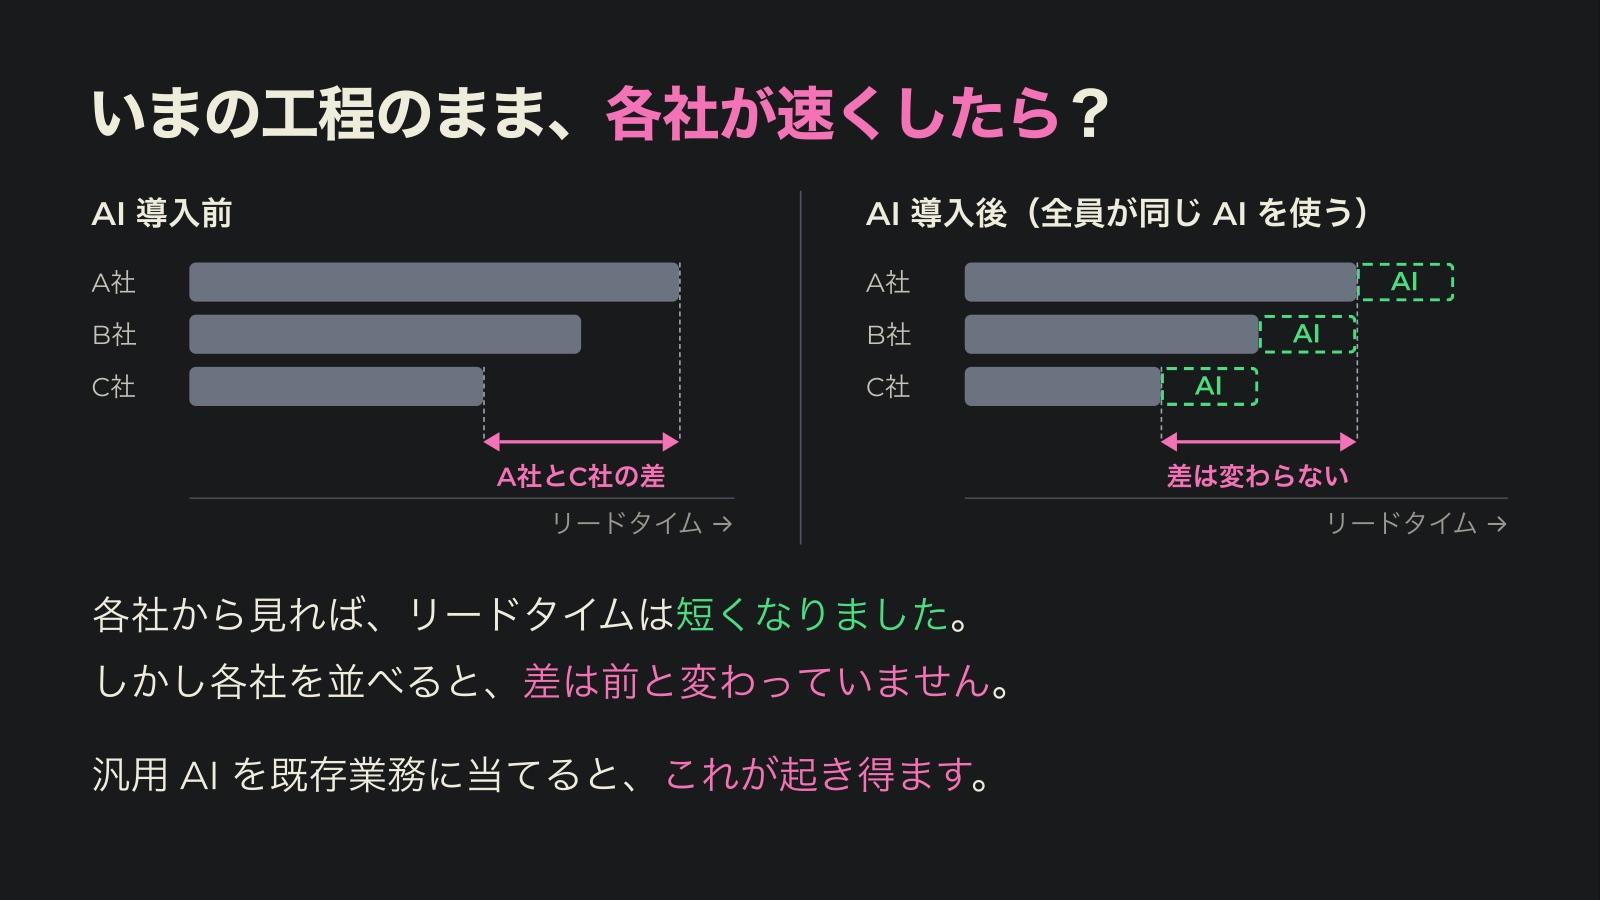
たとえば、似たような事業をやっているA社・B社・C社を、リードタイムという軸で並べてみます。各社がAIを入れて「俺たち、めっちゃ速くなったじゃん」となっても、顧客から見れば、いつも通りC社が少し速くて、A社はいつも通り遅い。差は何も変わっていません。汎用AIをそのまま既存業務に当てると、こういうことが起きやすいです。
ルイス・キャロルの『鏡の国のアリス』で、赤の女王が「同じ場所にとどまるだけで、全力で走り続けなければならない」と言う場面があります。まさに赤の女王効果と呼ばれる構図です。全員がAIを使うことを強いられているけれど、相対的な差は生まれない。走り続けて、ようやく同じ場所にいられる。そういう状態です。
工程そのものを組み直す「戦略AI」
では、どこで差がつくのか。実は100年前にも、同じことが起きています。1890年代、工場に電気モーターが入ってきたときの話です。
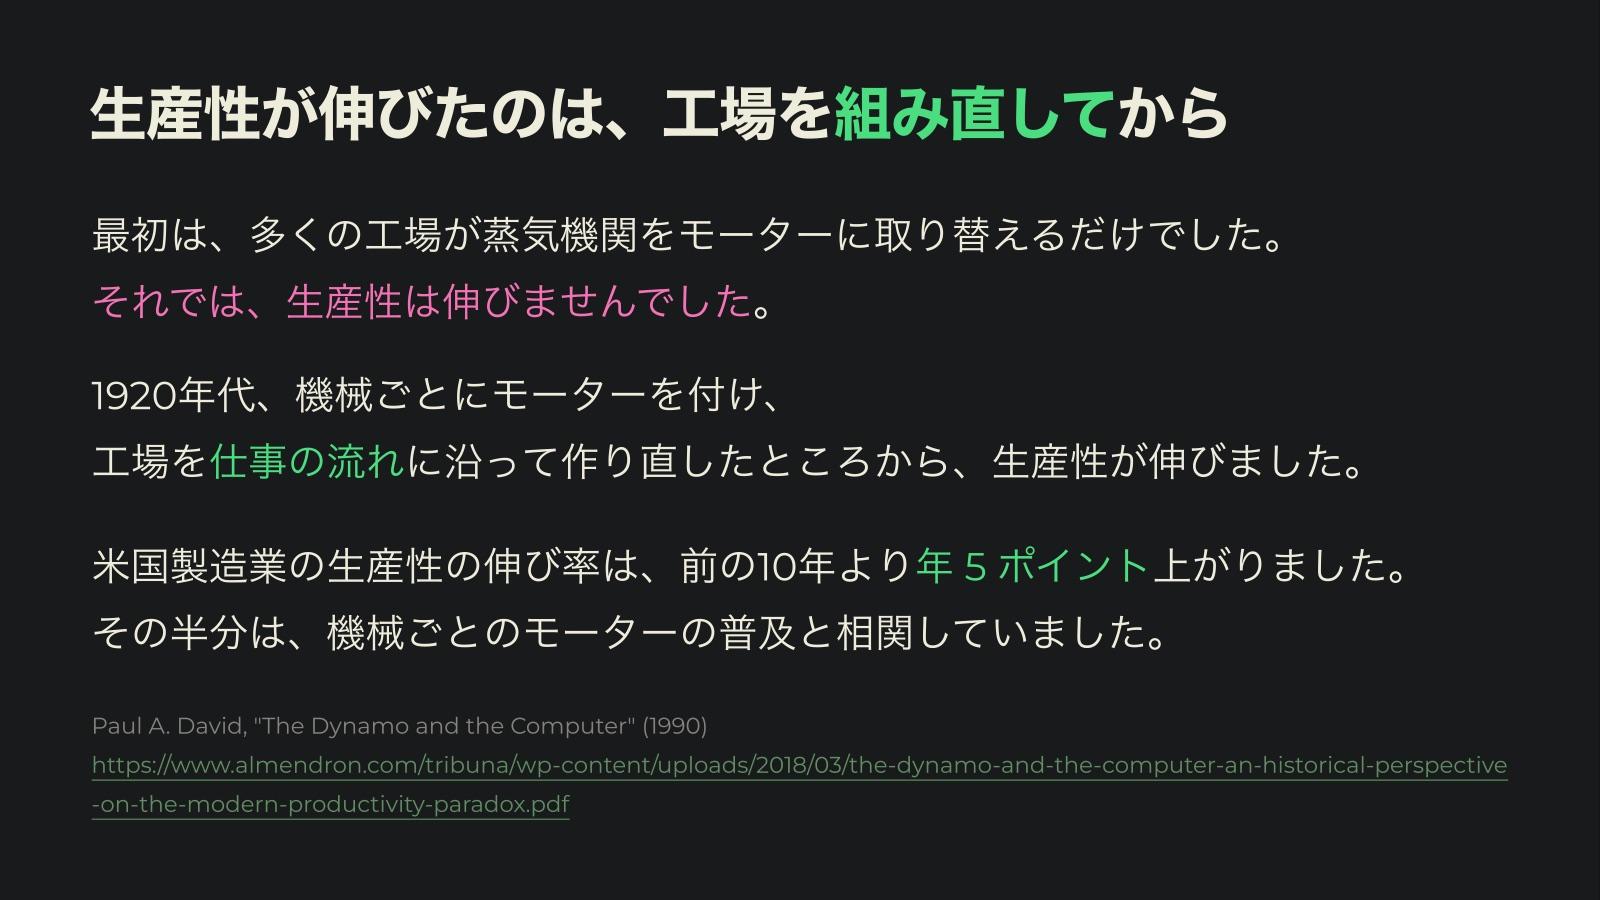
当時の工場は1台の蒸気機関で動いていて、機械はその蒸気機関を意識して並べられていました。そこに電気モーターが出てきた。普通に考えると、蒸気機関があったところに大きな電気モーターを置けばいいじゃないか、という発想になります。実際そうしたのですが、動力源を取り替えただけでは、生産性には何の寄与もありませんでした。
生産性が伸びたのは、機械ごとにモーターを付けられるようになってからです。そうすると、仕事の流れに沿って機械を置けるようになる。それによって、最終的に生産性が伸びました。
AIは、この電気モーターの登場に似ているところがあると思っています。成果物を作るのが、人からAIに変わりつつある。一方で、今の会社の工程や仕組みは、人が成果物を生み出す前提で作られています。そこを何も変えずにAIを使うのは、蒸気機関があったところに電気モーターを置いているのと同じです。
とはいえ、AI前提に変えるのはめちゃくちゃ難しい。蒸気機関から電気モーターに変えた人たちも、今まで作った仕組みや導入した機械を全部捨てて切り替えることは、おそらくできなかったはずです。今日は、その難しさに対して私たちが今やっていることをお話しします。
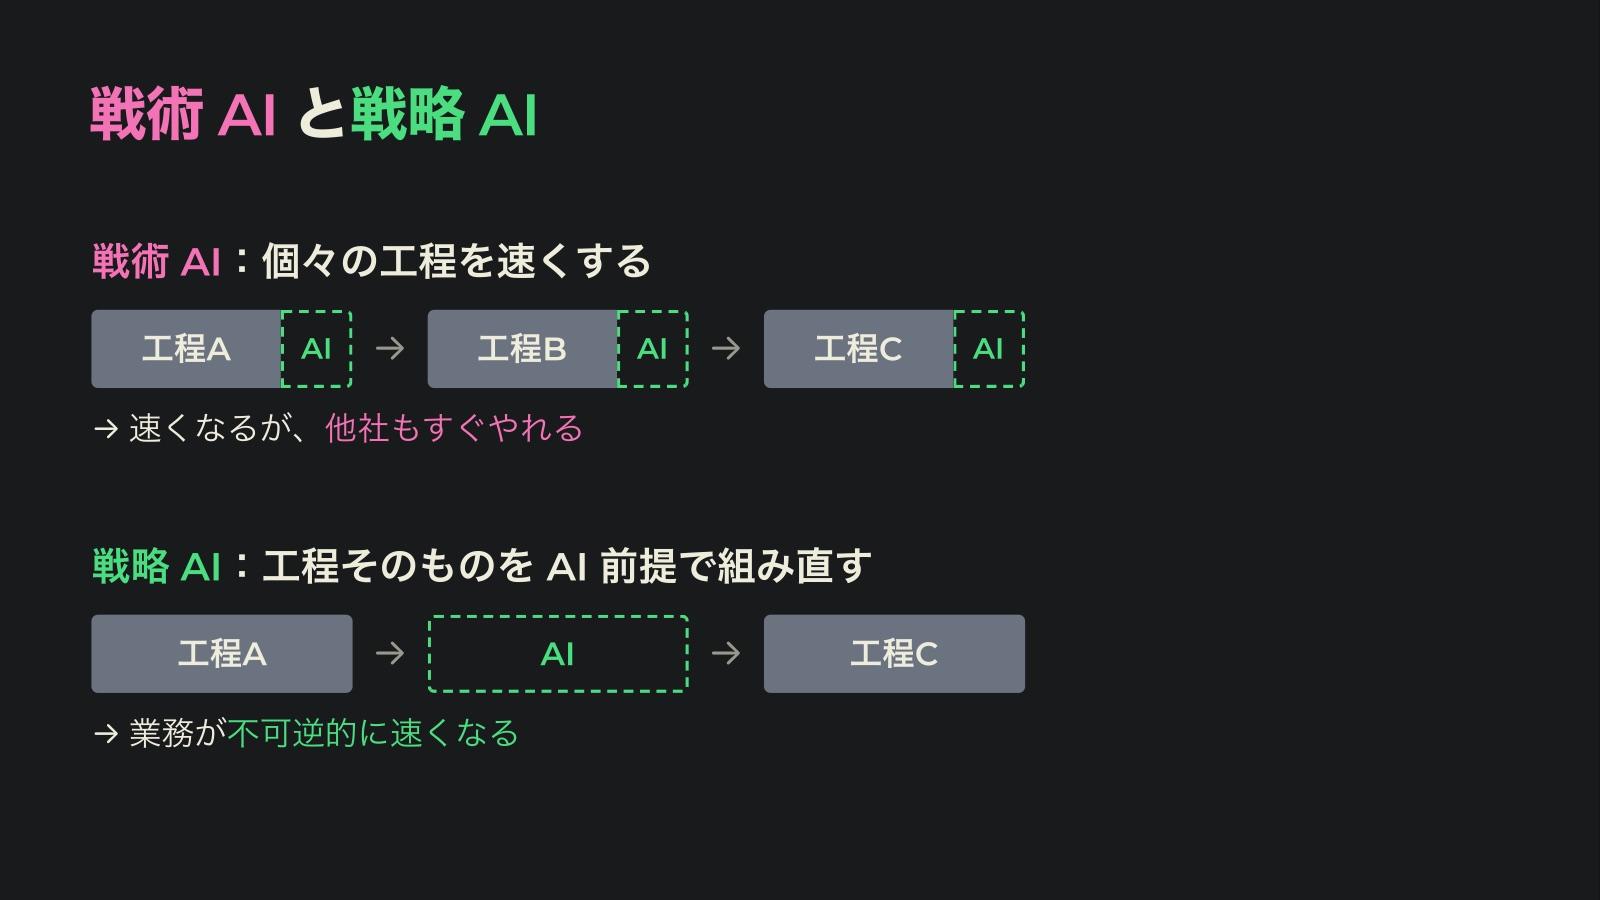
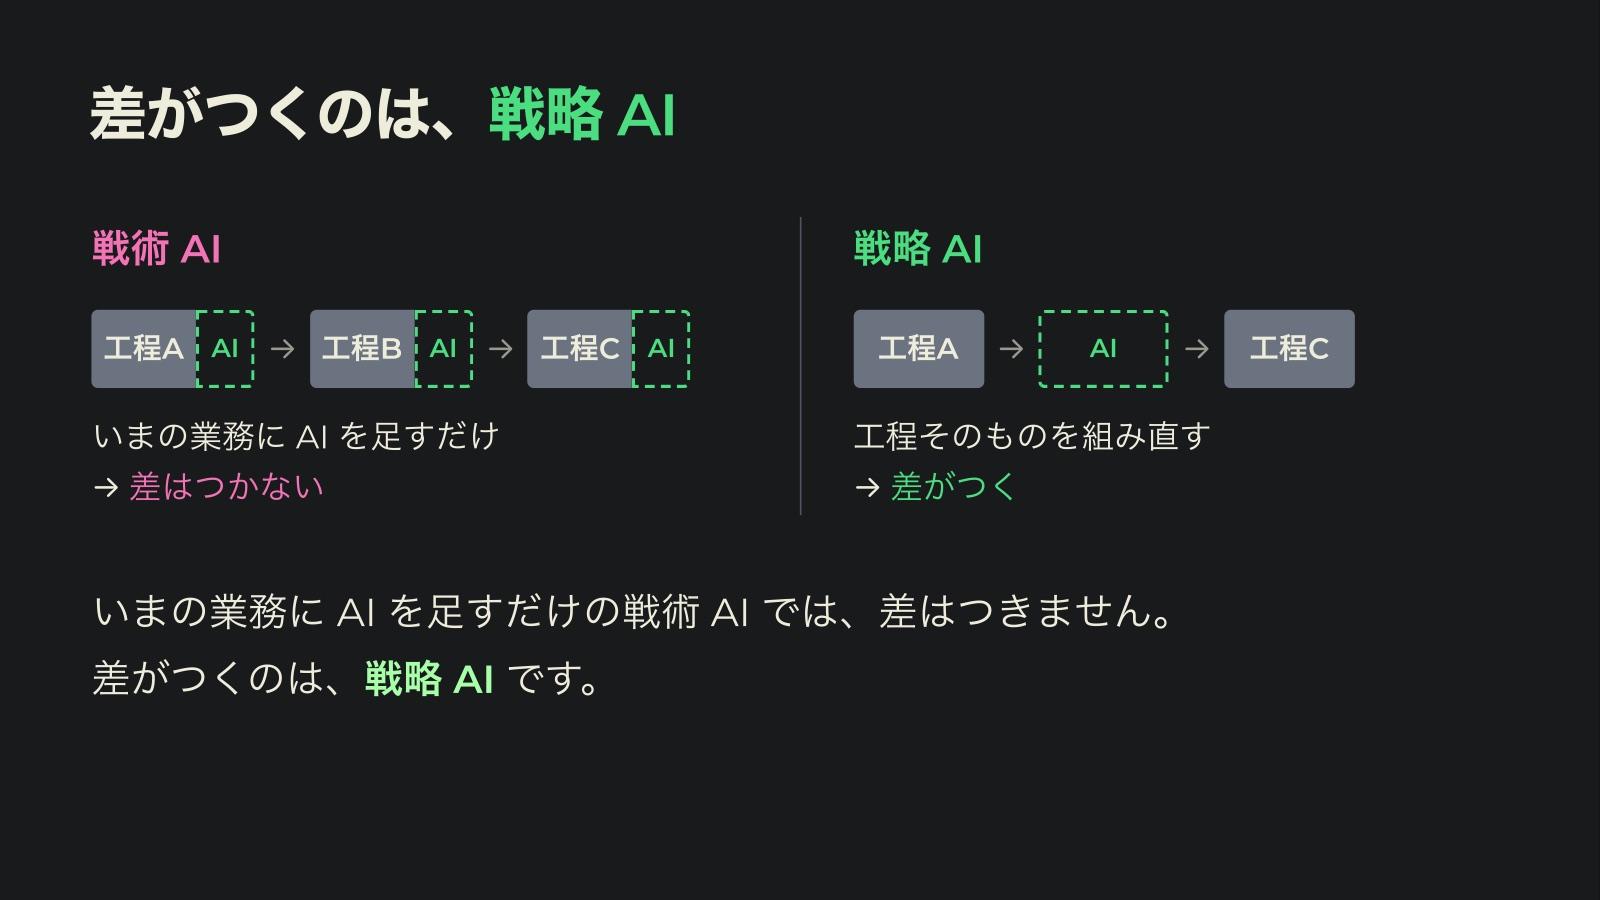
私たちが考えた答えが、「戦略AI」です。今の工程にそのままAIを当てて少し速くするのが、戦術AI。これもやらないよりは絶対に速くなりますが、このくらいの変更なら他社もすぐにできます。最も重要なのは、工程そのものをAI前提で組み直す戦略AIです。これをやると、業務が不可逆的に変わります。
6社が集まった会社を、一枚岩にする
CARTA ZEROにとっての戦略AIが、今作ろうとしている「ひとつなぎのデータプラットフォーム」です。CARTA ZEROは、すごく簡単に言うとデジタルマーケティングの会社で、1999年ごろから事業をやっています。いろんな会社を統合して、今は1,300人ちょっとの規模になりました。
次の文章は、2025年7月にこの構想を社内に打ち出したときのものです。
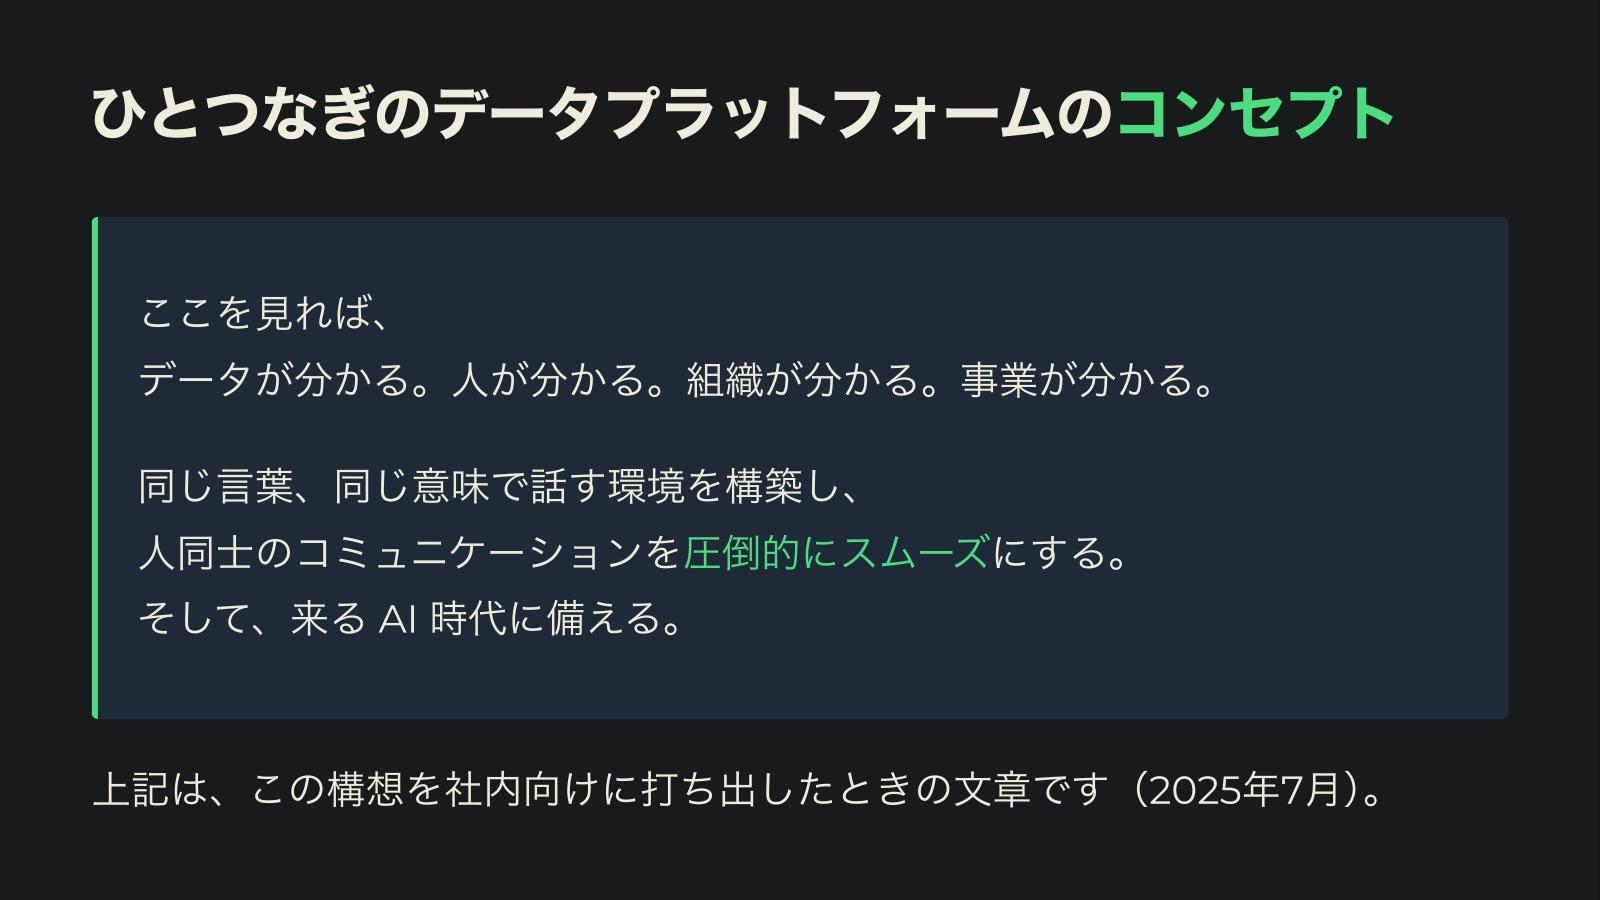
大事なのは、なぜこれを作りたいのかです。いきなりAIを使おうという話ではありません。CARTA ZEROは、歴史をたどると6社が2回の統合でできた会社です。2023年にCARTA HOLDINGSの中で4社が統合してCARTA MARKETING FIRMになり、2025年にはさらに3社が統合してCARTA ZEROになりました。その間には株主が変わるといったこともあり、本当に激変です。
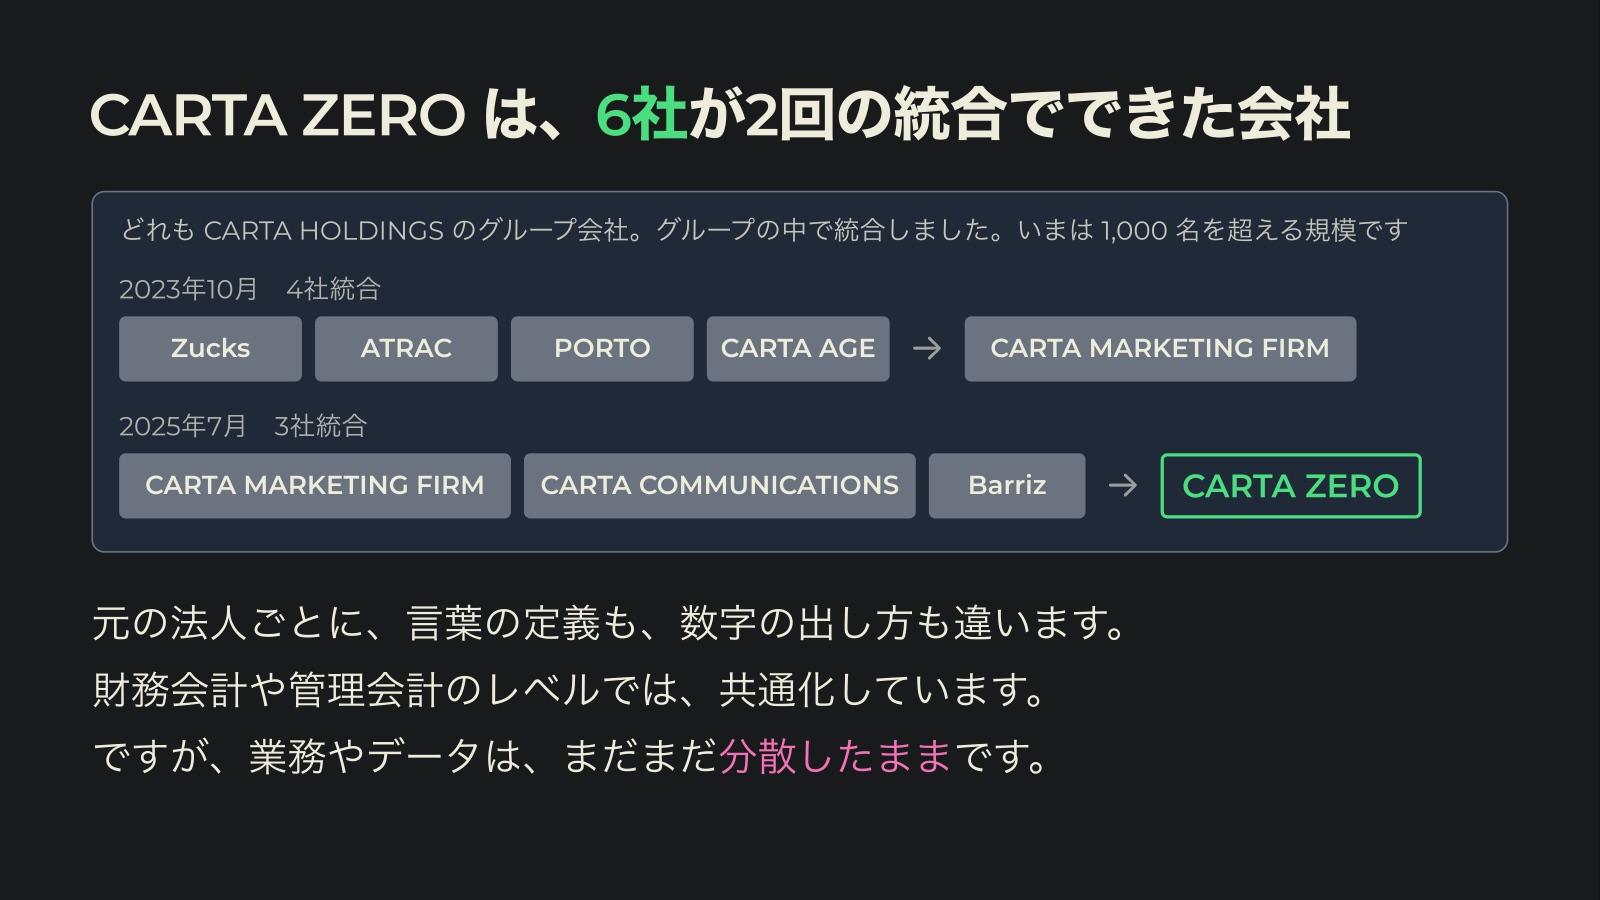
元の法人ごとに、言葉の定義も数字の出し方も違います。財務会計や管理会計はすでに共通化していますが、業務やデータはまだまだ分散したままです。事業が集まって事業としてのカバー範囲は広くなりましたが、もともとの事業会社ごとにサービスを提供している状態を横断して数字を追えないと意味がない。とはいえ足元には課題がいくらでもあって、同じ言葉で話したり同じ数字で見るだけでも、正直難しい状況です。
私はデータエンジニアだったので、データの力を使って「複数の営業組織が共通言語を使って話し、同じ数字を横断して見られる状況」を作りたいと考えました。人同士の会話で同じ言葉を揃えるのは難しいし、口伝で前提や知識を揃えるにも限界があります。それよりも、普段見ているレポートの列名が変われば、みんなその通りに言葉を使うようになりますよね。データから揃えるというスケーラビリティを使う。そして「この言葉はこの意味だよね」と組織内で前提が揃っていれば、それはそのままAI活用にも効いてきます。
最終的に目指しているのは、組織としての一体感と再現性です。組織を貫通した一体感は、そこで働く人にとって、そのまま組織に対しての信頼感につながると思っています。大きな金額の契約を検討したことがある人なら分かると思いますが、担当者が変わるたびに価値観や判断の軸がブレる会社は怖いですよね。一貫性を保てるのは、普段から部門同士が連携できているから。つまり組織力です。ここを作ることが競争優位になると考えていて、それをAIとデータで作っていきたいと思っています。
「多様性があっていいじゃないか」とよく言われますが、軸のない多様性はただのカオスです。軸のある多様性を、構造的に作り出したい。それが私が考えている「ひとつなぎのプラットフォーム」です。人をつなぐ「人繋ぎ」と、データをつなぐという意味を掛け合わせています。「この人がすごい」から「この組織はすごい」へ。属人化した”すごさ”を組織としての”すごい”に昇華する。そのためのインフラを作ろうとしています。
全部つなげるのは罠だった
「ひとつなぎ」と言うと、とりあえず全部つなげれば良さそうに聞こえます。でもそれはよくある罠です。データ統合をしたことがある人なら分かると思いますが、異なるデータソースをつなげるのは本当にめんどうです。こちらのデータはこうなっている、あちらはこうなっている、データや運用のライフサイクルも違う。前提を揃えずに無作為につなげても、期待した価値は出ません。
だから、つなぐものは事業戦略で事前に絞ることが重要です。たとえば2つのシステムがあって、普段の業務でよく出る問いかけを並べてみる。すると、Aのシステムだけで答えられる質問もあれば、AとBを掛け合わせないと答えられない質問、さらにCも要る質問もあります。
つながっていないと答えられない問いに答えるために、必要なシステムをつなぎ合わせていく。ですから最初にやるべきなのは、どんな問いや要求が普段から扱われているのか、そのどれが重要な問いなのかを洗い出すことです。その結果、要求に答えるためにシステム間をつなげることでメリットがあると分かりました。その要求に答えるために、私たちはRevOps(レベニューオペレーションズ)を採用しています。
ただ、CARTA ZEROでは、すでにあるシステムをつなぐだけでは終わりませんでした。ここが超楽しいポイントです。会社統合を繰り返した結果、同じ役割のシステムが大量にあるんです。
SFA(Sales Force Automation、営業支援システム)もERP(Enterprise Resource Planning、統合基幹業務システム)もMA(Marketing Automation、マーケティング業務の自動化)もデータ基盤も複数あるし、広告レポート基盤に至っては本当にたくさんある状態でした。
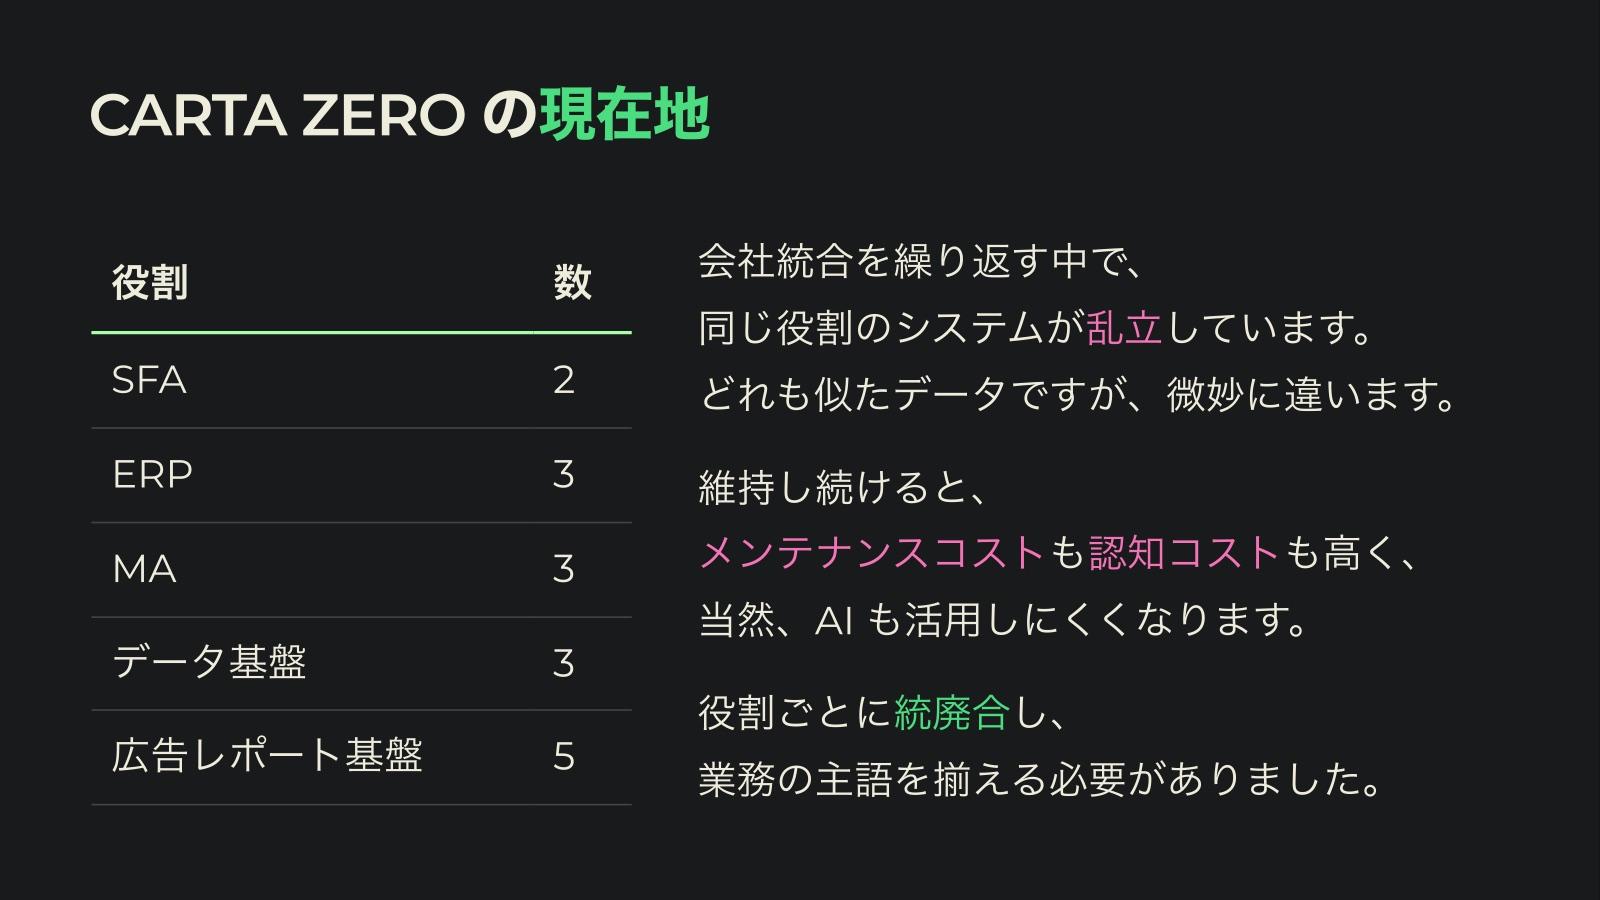
これを放置し続けると、それぞれで文脈も使い方も業務も違うので、メンテナンスコストも認知コストも上がります。当然AIのコストも上がる。「この質問の答えにつながるデータは、まずどのシステムに入っているのか」という根本的な課題から始まってしまうからです。そこで、役割ごとにシステムを統廃合して、業務の主語を揃えるところから取り組んでいます。元の会社にはそれぞれの正しさがあったと思いますが、CARTA ZEROでやるならどうするのか。CARTA ZEROという文脈に合わせて、作り直すということです。
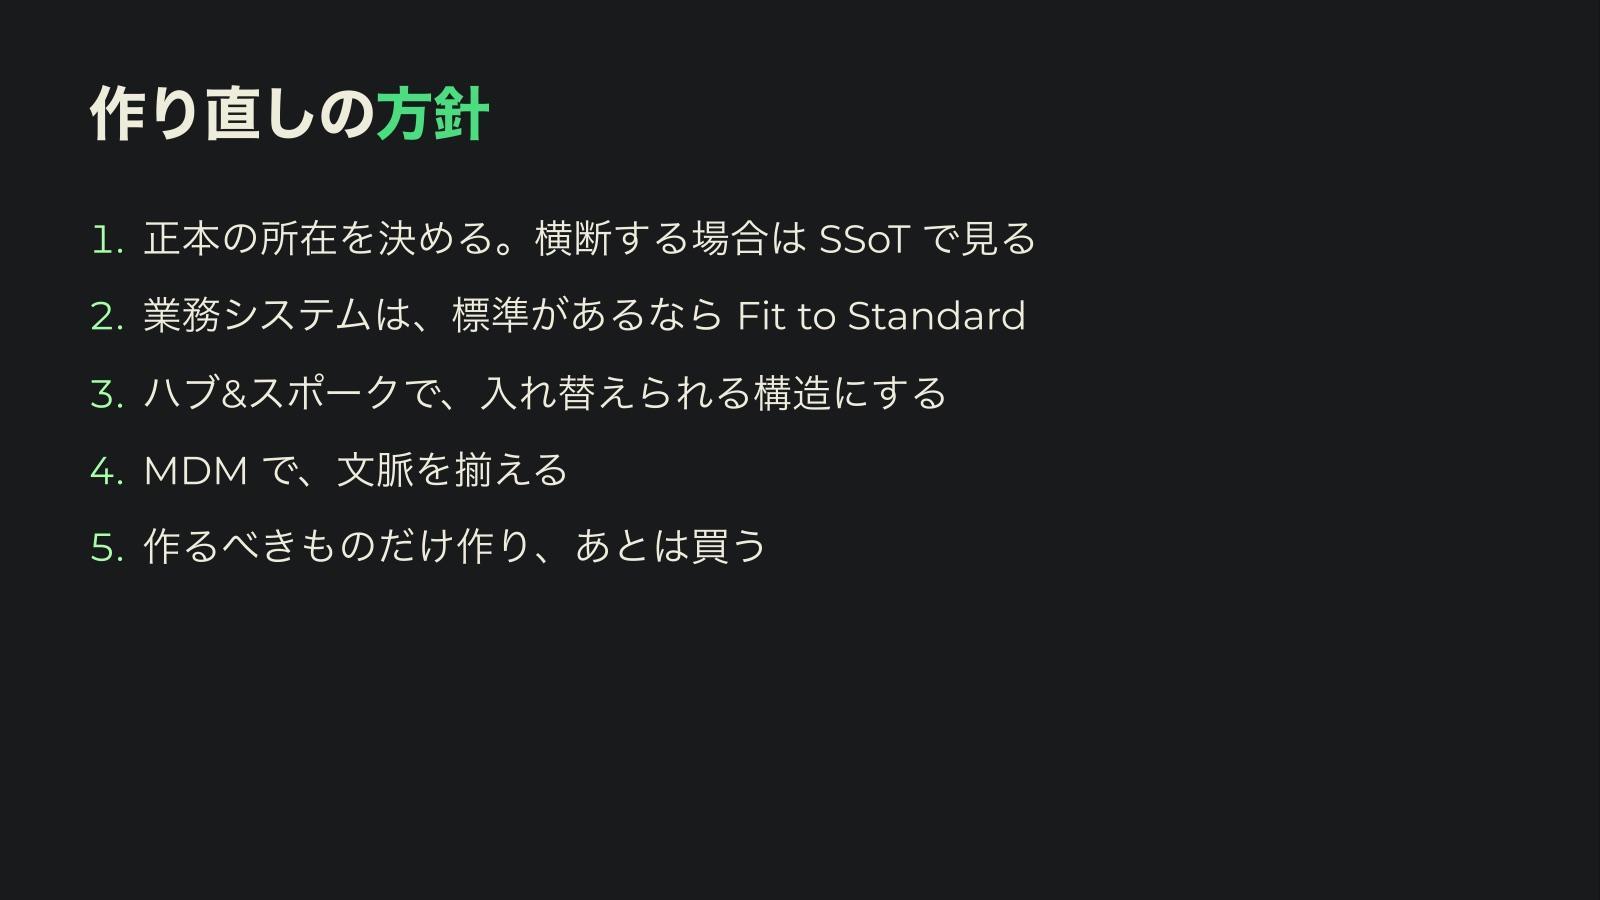
作り直すときには軸が必要なので、次の5つの方針を決めました。
データの正本を決めて、標準に乗る
1つ目の「正本(SoR:Systems of Record)の所在を決める」は、めちゃくちゃ大事です。同じようなシステムがたくさんあると、「このデータ、どこにあるんだっけ」という会話を毎回することになります。「このデータはこのシステムにある」と決めておけば、入れるときの検討も、探すときの手間も楽になります。
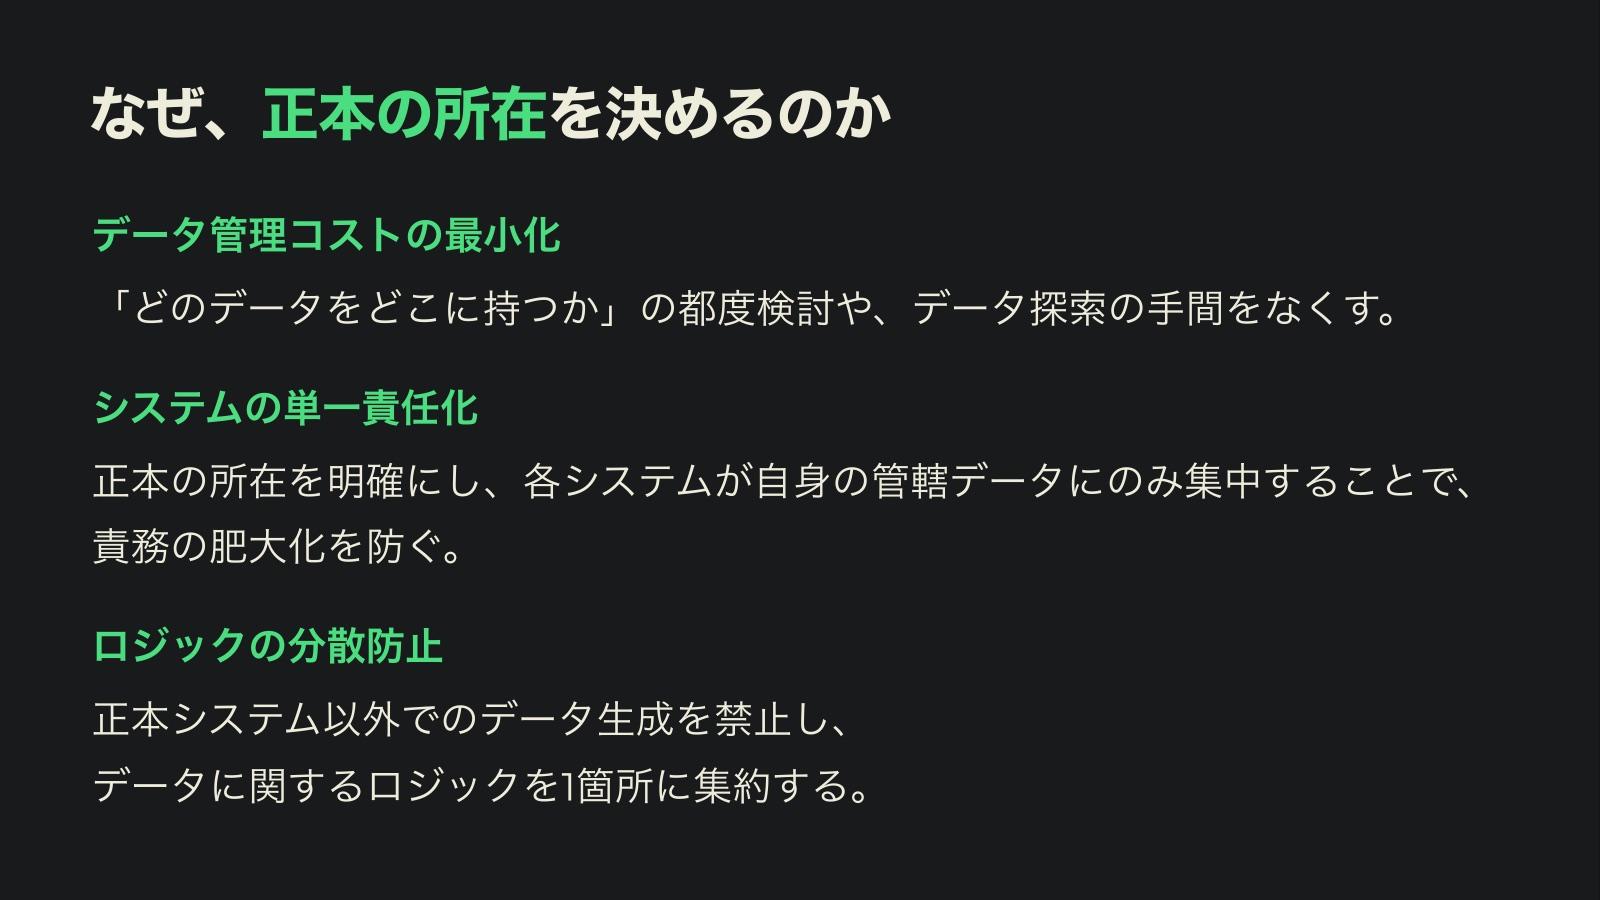
システムの責任もシンプルになります。業務システムには、何でも一箇所に入れようとする圧力がかかりやすいんです。たとえばSFAを担うはずのSalesforceに、いきなりERPのような機能を入れ始めたりする。そうではなく、そのデータはERPにあるのだから、Snowflakeでジョインして見ればいい。そうしておかないと、「Salesforceの売上とERPの売上が合わないけど、なんで?」「それは誰にも分かりません」ということになる。ロジックを一箇所に集めるのも、そのためです。
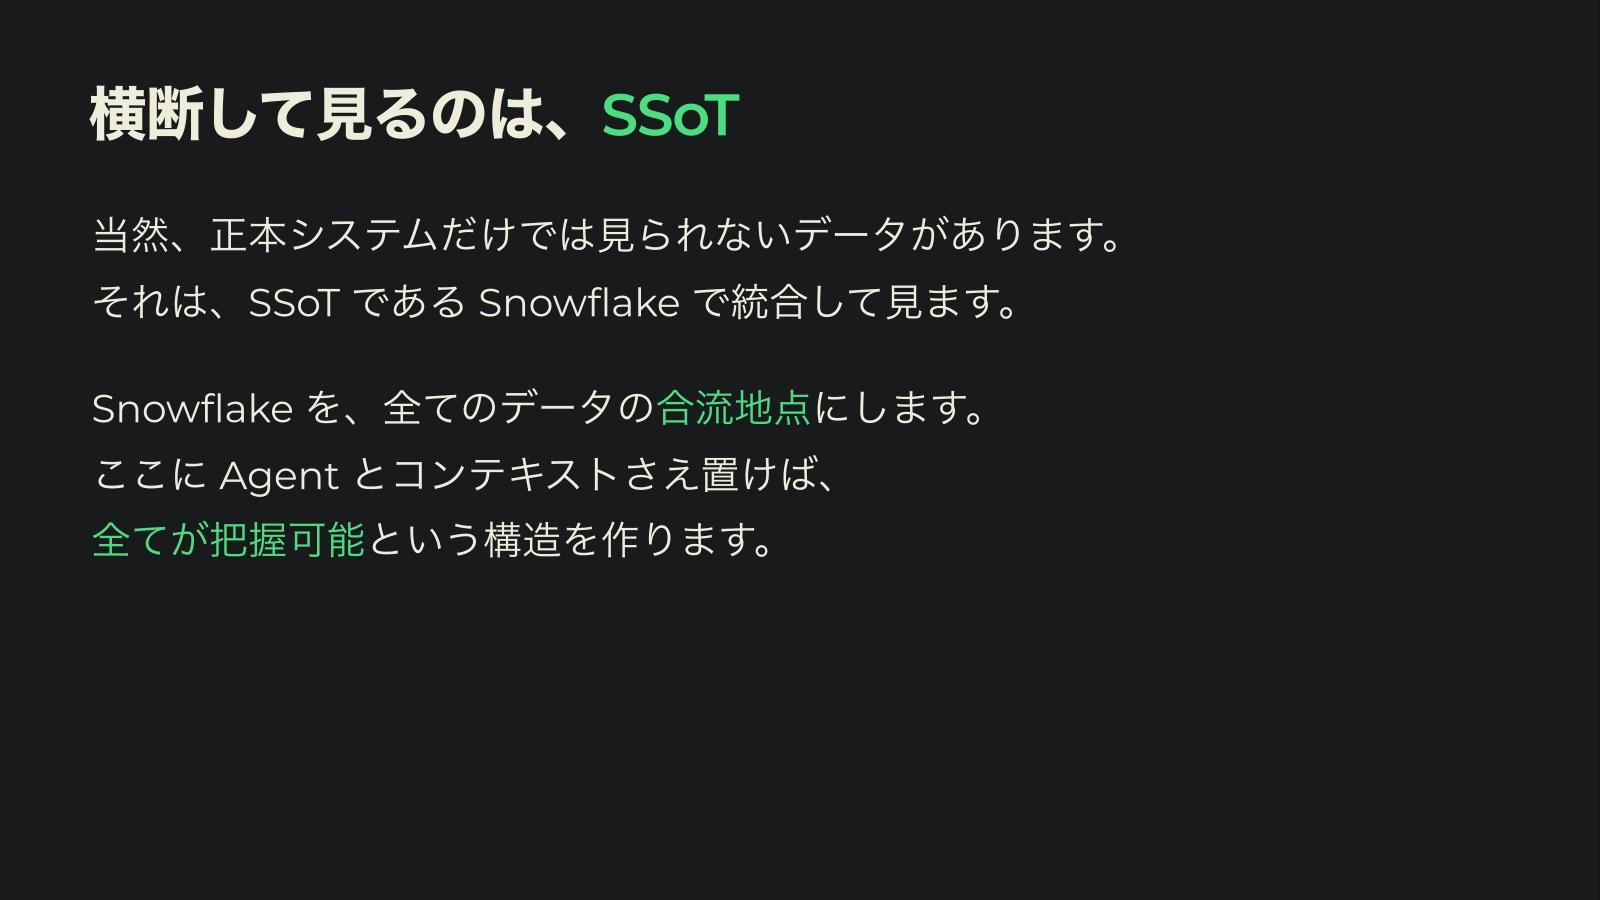
そして、システムを横断して見るときは、SSoTとしてデータを集約し、データハブとして機能しているSnowflake上でデータを見ます。たとえばERPを見れば売上は分かりますが、それだけではビジネスの解像度が上がらない。SFAのデータを見ると、どの顧客とはうまくいっていて、どの商談がうまくいっていないかが分かる。マーケティング活動の効果を説明するにも、MAのデータだけでは「リードは取れたけど、受注につながったかは分からない」となってしまう。SFAとつなげて初めて、営業にとって意味のあるリードを渡せているかがデータから分かるようになります。こうして、Snowflakeをすべてのデータの合流地点にすると、AIエージェントもSnowflakeに置くだけで全部を見られる構図になります。
2つ目の「業務システムは、標準があるならFit to Standard」も、めちゃくちゃ大事です。「Fit to Standard」とは、システムベンダーが提供している標準機能を積極的に利用し、業務をそちらに合わせて設計することを指します。
たとえばSalesforceは、今、全部作り直していてFit to Standardで作っています。なぜFit to Standardなのかを理解するには、対極にあるFit to Business(システムを事業の都合にあわせてカスタマイズすること)のリスクを知るのが大事です。
Salesforceと向き合っていて、なんだかつらいけれど理由をうまく説明できない、という方もいると思います。今日はそこの解像度を上げます。
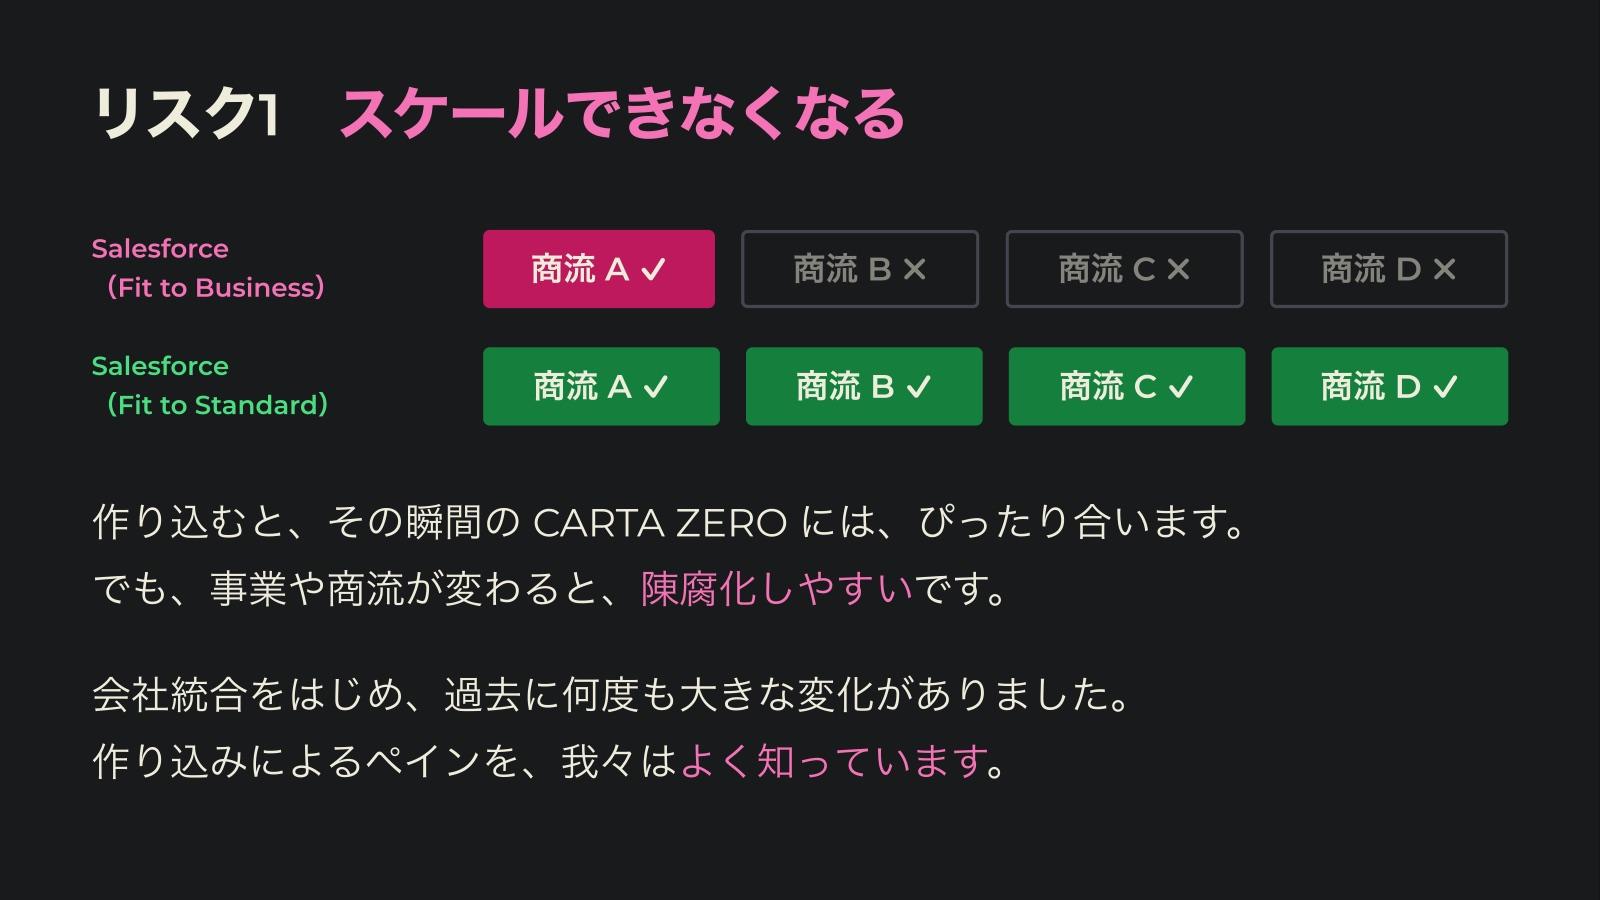
1つ目のリスクは、スケールできなくなることです。
私たちは統合を繰り返して、ビジネスの重要ポイントが短期間で大きく変わりました。数年前の文脈でFit to Businessで作ったSalesforceは、商流Aにはぴったり合っている。でも事業が大きくなって商流B、C、Dが出てくると、その人たちにとっては無関係で余計なフィールドばかりで、商談を立てるだけでも一苦労。「使いにくいけど、月末に怒られるから入れています」という状態になります。売る・商談するという動作にフォーカスして個々を最適化して作った方が、変化にもある程度対応できます。
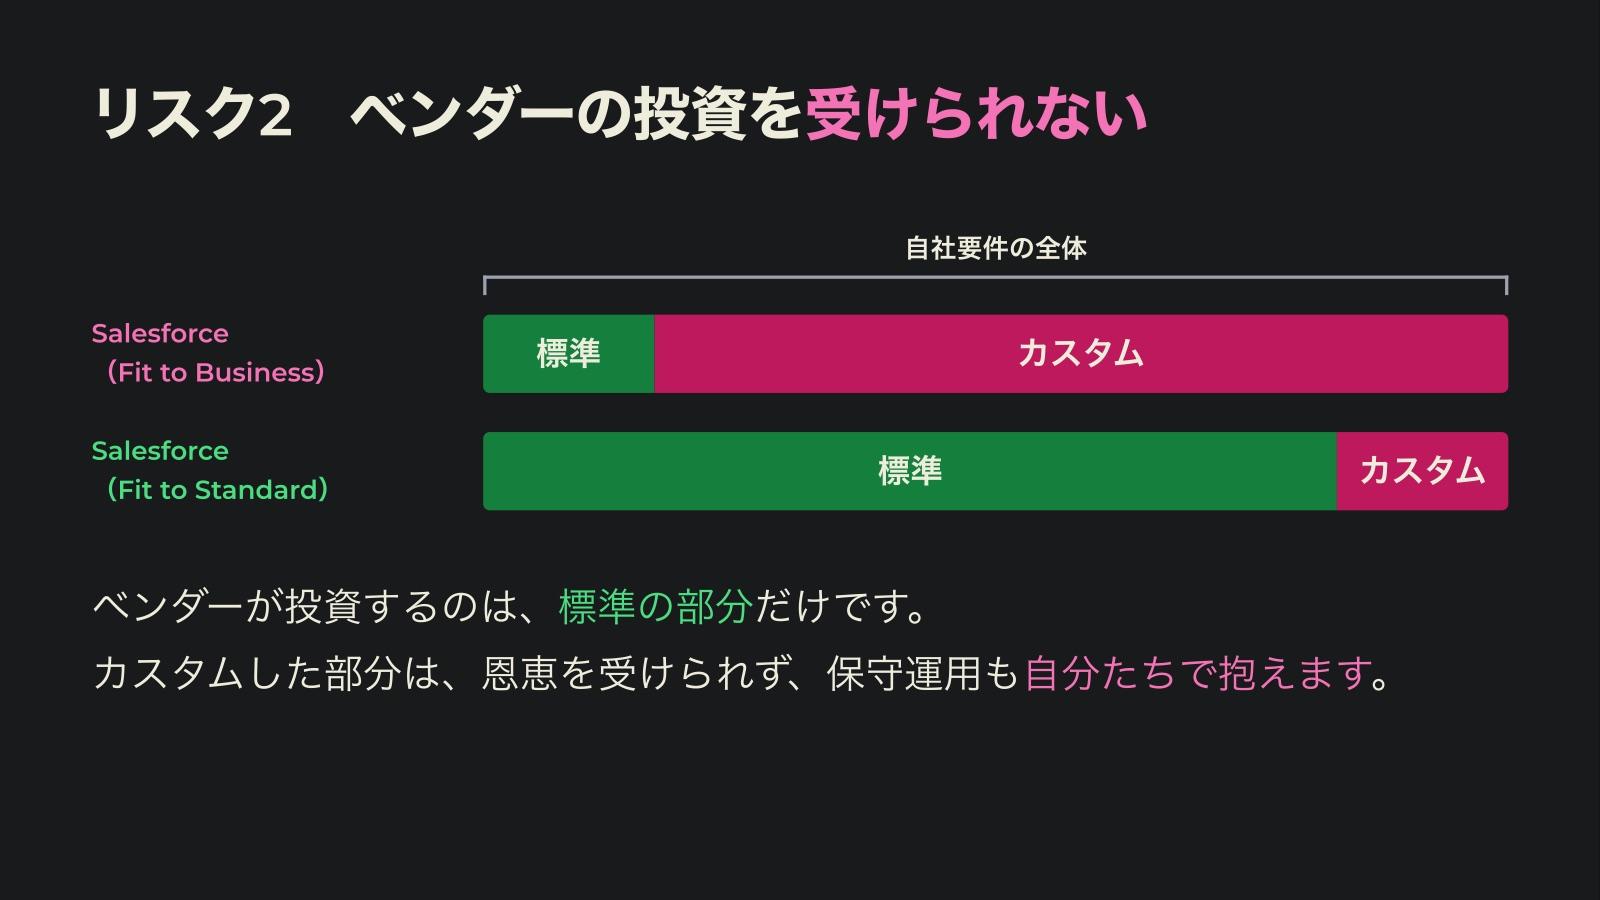
2つ目は、ベンダーの投資を受けられないことです。自分たちのビジネスをそのまま表現してソフトウェアやシステムに載せると、カスタムだらけになって標準機能を利用できる部分はわずかになります。でも、ベンダーが投資するのは標準機能の部分です。マーケットプレイスのプラグインを入れたら動かなかった、というのは大体これが原因で、前提がそもそも揃っていません。プラグインバージョンアップも大変で、カスタム部分の保守運用は自分たちで抱えることになります。
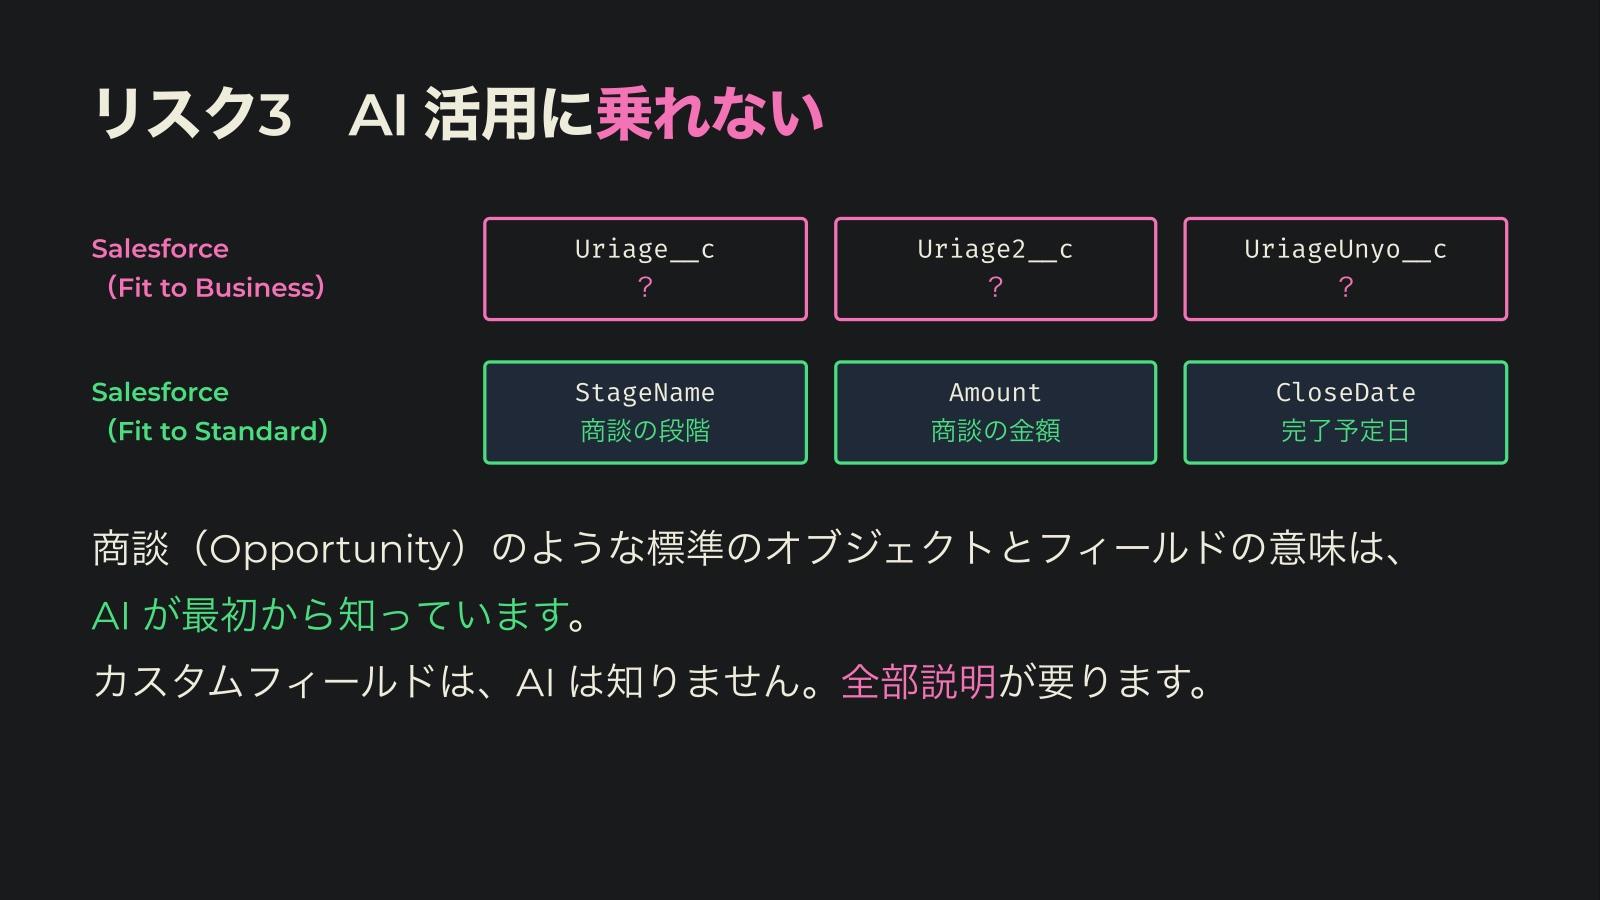
3つ目は、AI活用に乗れないことです。実際、「Uriage__c」「Uriage2__c」「UriageUnyo__c」のようなカスタムフィールドが本当にいっぱいあって。一方でSalesforceは、商談はこうあるべき、このときはこのデータをここに入れる、など標準機能を利用するうえでのデファクトスタンダードを全部定義してくれています。その通りに乗っておけば、StageNameやAmount、CloseDateが何なのかをAIにいちいち説明しなくていい。カスタムフィールドは、全部説明しないとAIがうまく利用できません。
入れ替えられる構造と、揃った文脈
ここまでは個々の業務システムの話でしたが、ここからはシステム間を実際につなぐときの話です。これまでは、システム同士を直接つなぐポイントツーポイントで連携していました。これを、真ん中にSnowflakeを置くハブ&スポークの構成に変えました。
ハブ&スポークってよく聞くけど、結局何が嬉しいのか。ここは苦しんだ経験があるので、解像度高く話せます。たとえばMAを新しいものに変えるとなったとき、SFAがそのMAとAPIでしっかり連携していると、「MAを変えたらSFAも死ぬけど」ということが普通に起きます。APIで密に連携していると、1つのシステムが死んだときにもう一方も同時に死ぬ構造になりやすく、しかもめちゃくちゃ剥がしにくい。これを変えやすくしたかったんです。
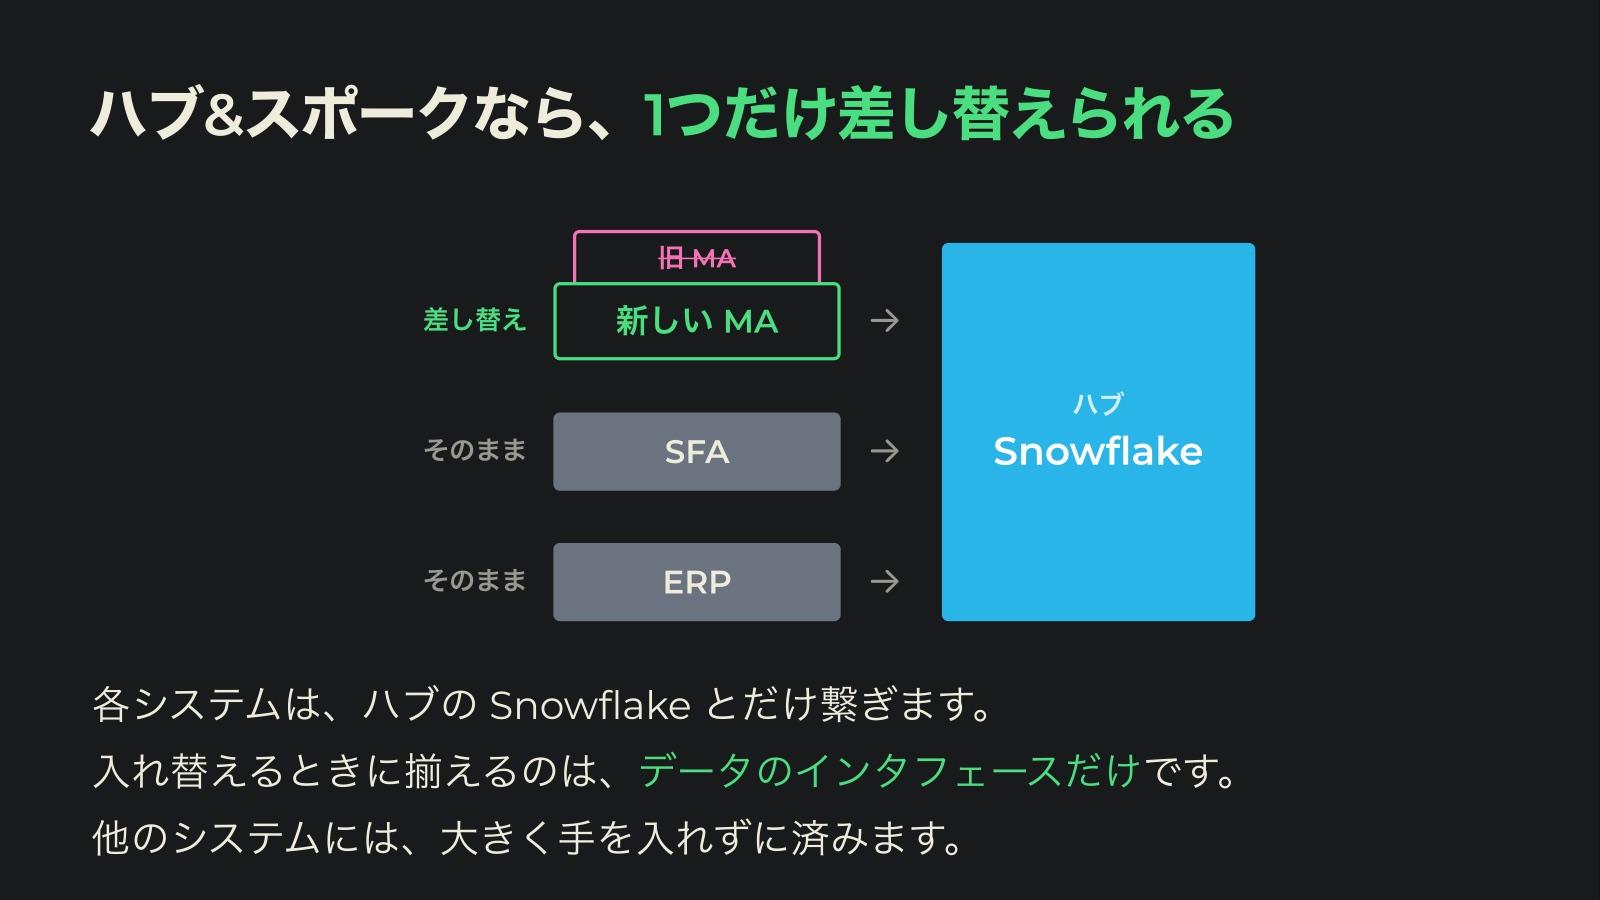
そこで、必ずSnowflakeを通るようにしました。システム同士が直接つながるのではなく、Snowflakeとやり取りするデータの形を揃えて、各システムはその形にだけ合わせる構造にする。新しいMAになっても、同じ形でデータをやり取りすれば、それぞれのシステムはいつも通り動けます。最初にデータの形を揃える手間はかかりますが、そのぶん入れ替えに強くなるので、ハブ&スポークはめちゃくちゃいいです。
1つのシステムですべての役割を担うことをやめると、当然、業務を実行するために必要なシステムは増えていきます。そうなると、4つ目の方針であるMDM(Mastar Data Management: マスターデータ管理)で文脈を揃えたくなります。正直やりたくはないけれど、やるしかない。
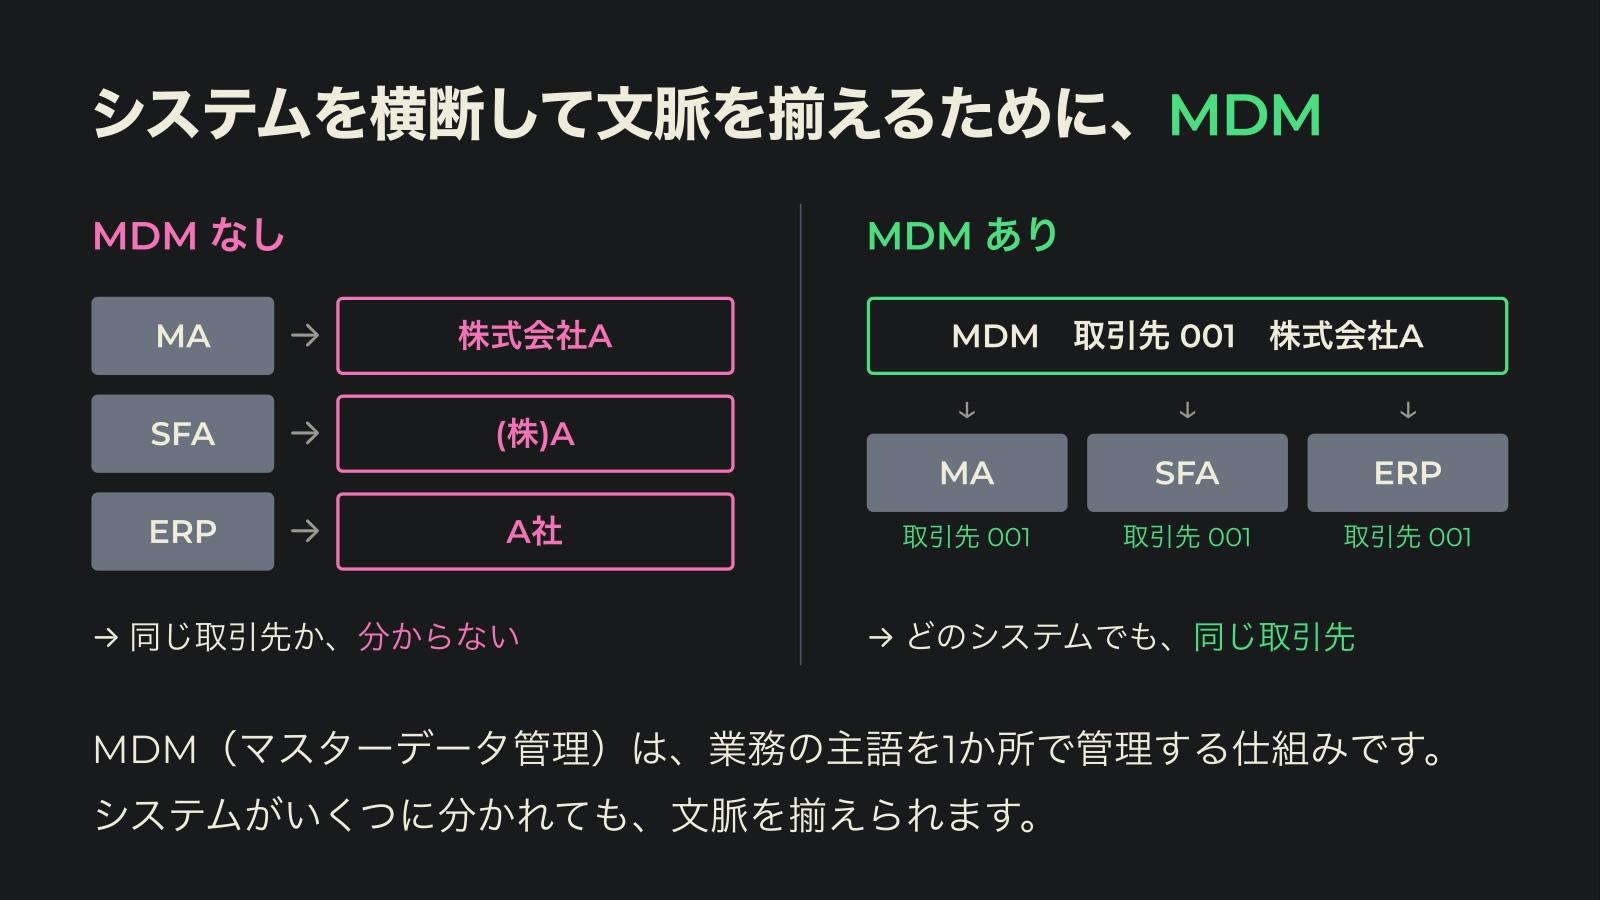
MAでは「株式会社A」、SFAでは「(株)A」、ERPでは「A社」と表現が揺らいでしまうことが頻発します。「これ、同じ会社なんです」と後から言われても見分けがつかないですよね。MDMで「取引先001といえば株式会社A」と揃えて配っていかないと、データをつなげて価値を出すという話自体が成り立たなくなります。
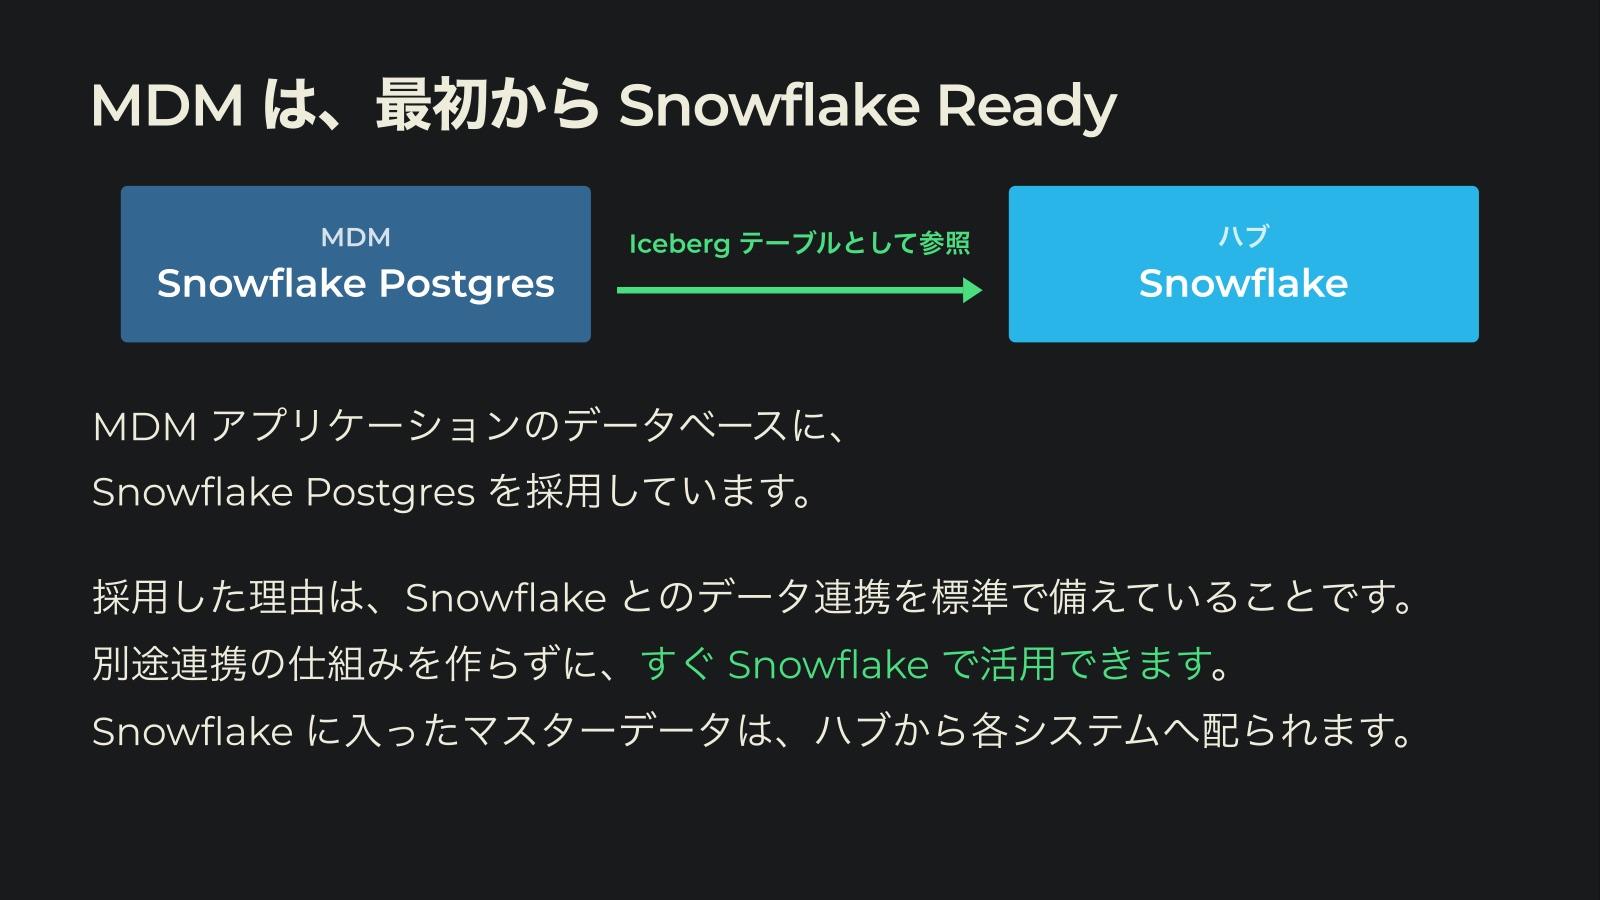
MDMをどこで作るかには、めちゃくちゃ頭を悩ませました。結論として、MDMアプリケーションのバックエンドにSnowflake Postgresを採用しています。システムからシステムへデータを移すのって面倒だし、途中で止まったときに何が起きているのか分からなくなりますよね。Snowflake Postgresは、そもそもSnowflakeとデータ連携する前提で作られています。MDMのデータはどうせSnowflakeで使い、その先のいろんなシステムで使うと分かっているので、わざわざ離れた場所に作る理由がないんです。
5つ目は、作るべきものだけを作り(Build)、あとは買う(Buy)という発想です。私はもともとソフトウェアエンジニアで、コードを書くのも何かを作るのも楽しいんですが、この発想を持つのは大事です。Buildするのは、作ることが競争優位になるところだけ。たとえば給与システムを自社で作っても、顧客からすれば意味がないし、そもそもリスクが高い。そういうところはBuyして、業務をSaaSに寄せます。
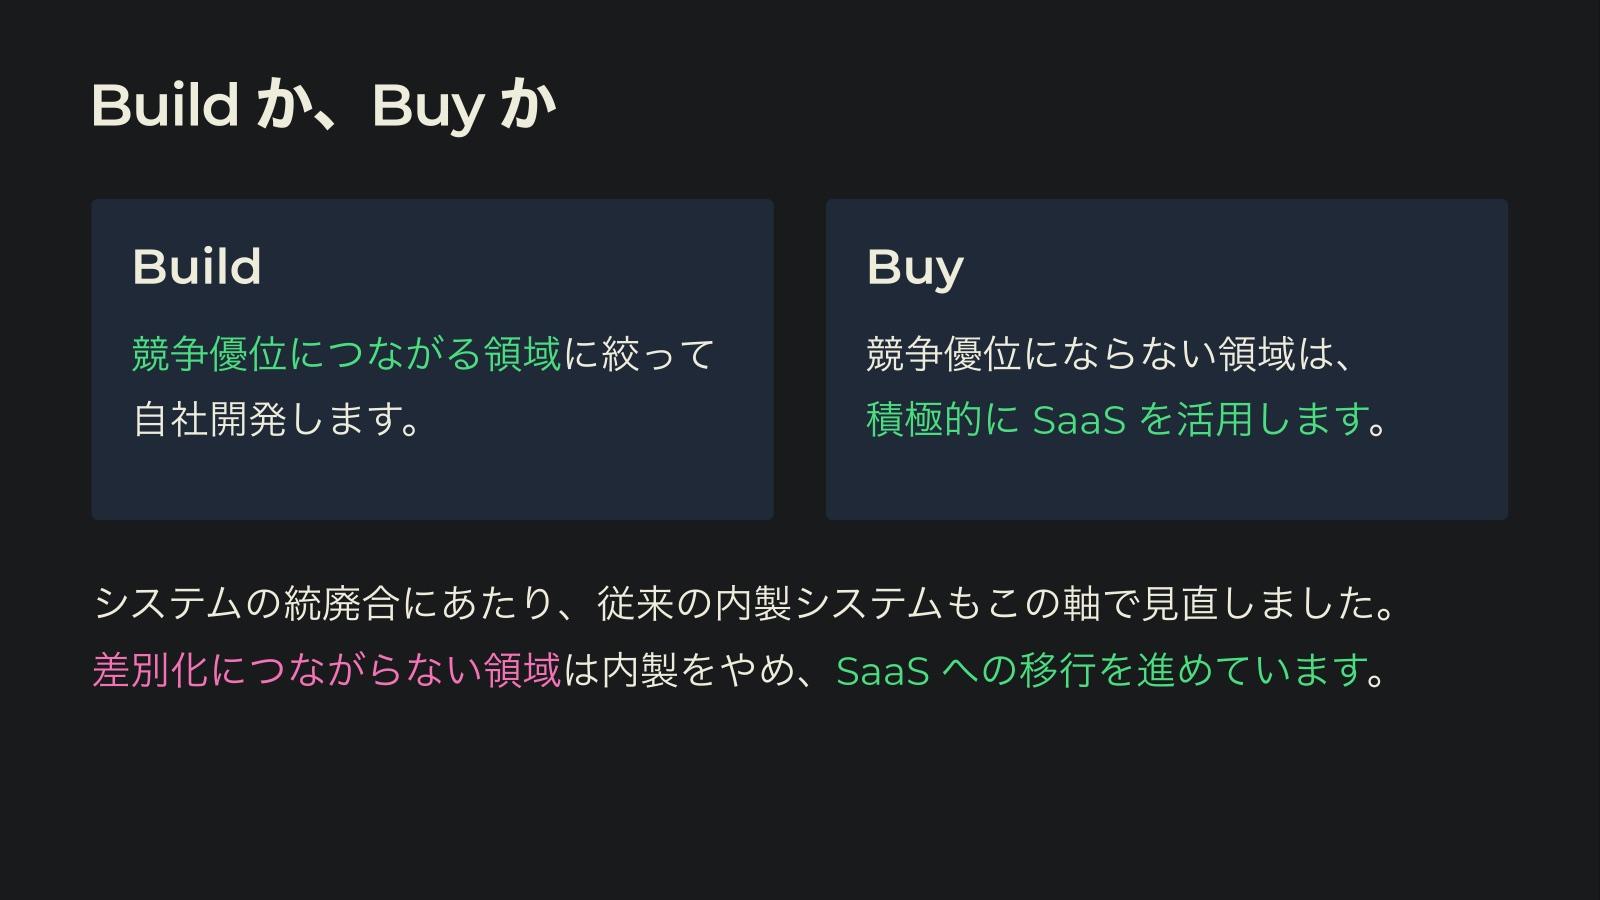
5年前、10年前には内製することで競争優位があったけれど、今は正直SaaSで多くのことが実現できてしまう。そんなメンテコストだけがかかっているシステムこそ内製化をやめた方がよく、私たちもSaaSへの移行を進めています。そうすると、そこにエンジニアを張り付け続ける構造から抜け出せて、本当に競争優位に重要なところへエンジニアをアサインできるようになります。皆さんの会社でも参考になるところがあれば、ぜひ持ち帰ってみてください。
作り直しを待たずに、今あるデータでAIを試す
ただ、このようなデータ基盤の作り直しは本当にびっくりするくらい時間がかかります。Salesforceを作り直すという話があったとして、作り直すと意思決定するまでのステークホルダー調整だけでも数ヶ月かかるでしょう。それを待っていたらAI活用が遠くなりすぎるので、作り直しとAI活用は並行して進めています。新しいSalesforceはすでにリリースしていますが、それとは別にAI活用も進めていて、作り直しが終わったときにはもうAIがある状態にしたいんです。
AIって、どこに効くのかよく分からないと思いませんか。最強のアイテムを渡されたけれど、どこで使うのが効果的なのか分からない、そんな感じです。分からないから、実際にある問題で試す。開発生産性を上げるのも大事ですが、私たちは実際のビジネス課題にどう当てるかを考えていて、次の4つが揃っている業務から始めるのがいいと思っています。
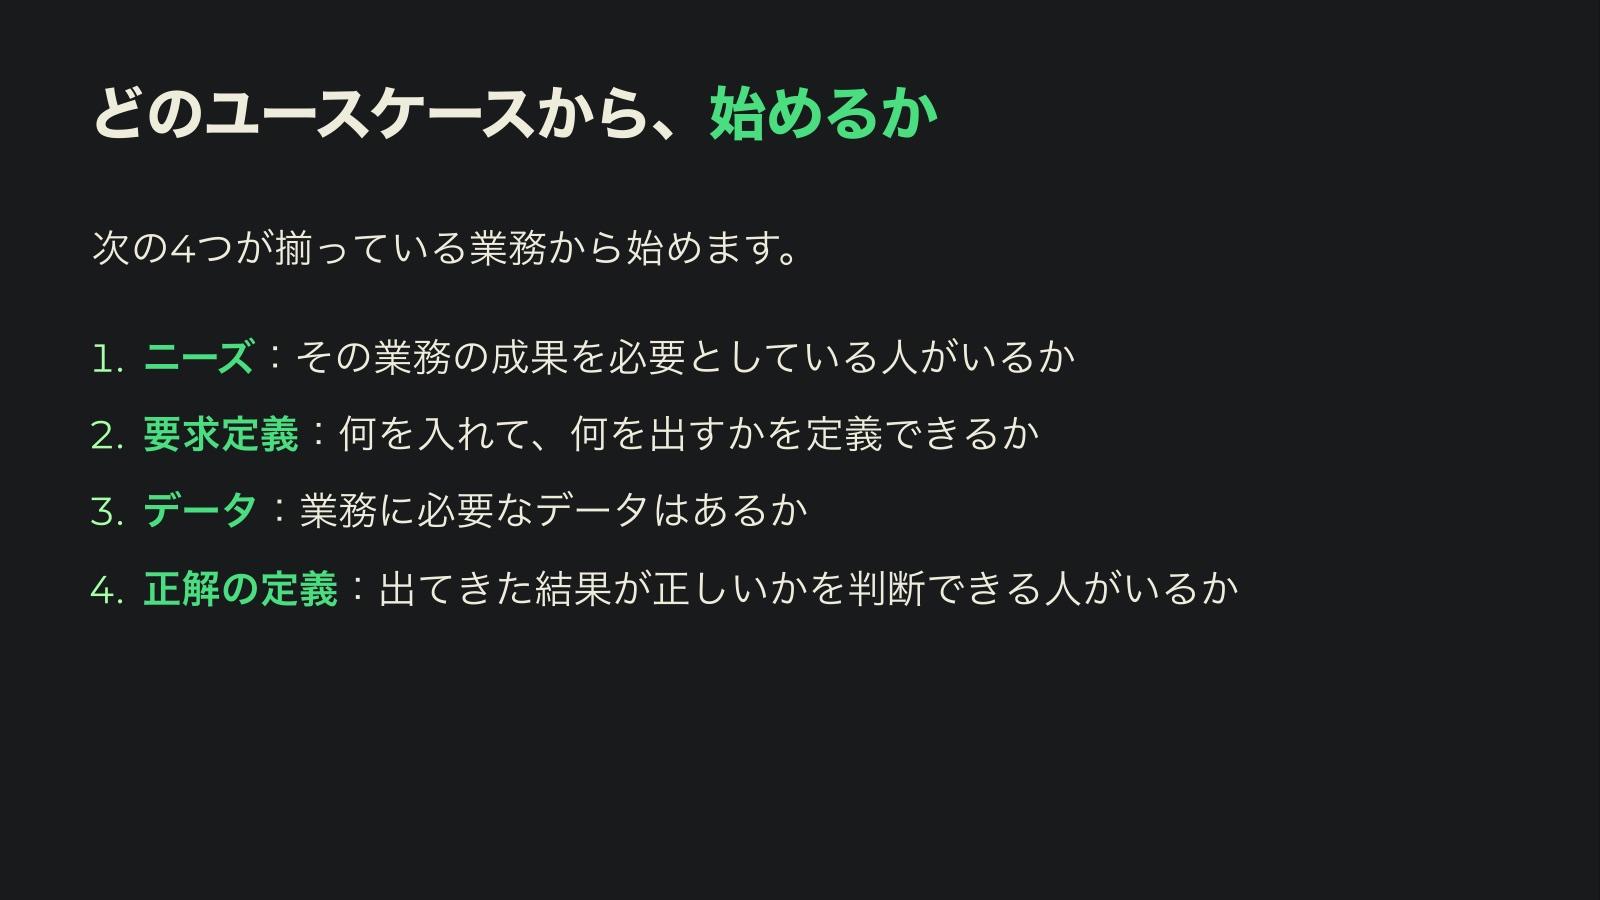
ニーズがないと、結局「楽しい」だけで終わってしまいます。アウトプット(成果物)は出るけど、アウトカム(事業成果)には繋がらないんですよね。ニーズはあるけれどデータがないというのはめちゃくちゃ大変で、データを作るのはさっきの作り直しと同じくらいコストがかかります。そして、出てきた結果を「良い」と判断できる人がいないと、「俺はこっちの方がいいんだよな」という話を一生するだけで、無駄な時間を過ごすことになります。
私たちがまず攻めているのは、事業ニーズに沿った質問に的確に答えるところです。「このペースだと案件Aは目標を達成できそうか」とデータアナリストに調べてもらう。取引先に「御社で同じような取り組みってあります?」と聞かれて、ベテランが「確か4年前の案件でやったな」と過去案件を調べる。こういうことに時間を取られて、この2人は本来やりたいことができなくなる。しかもこの課題には、要求も正解もデータもニーズもある。だからめちゃくちゃ攻めやすいポイントです。
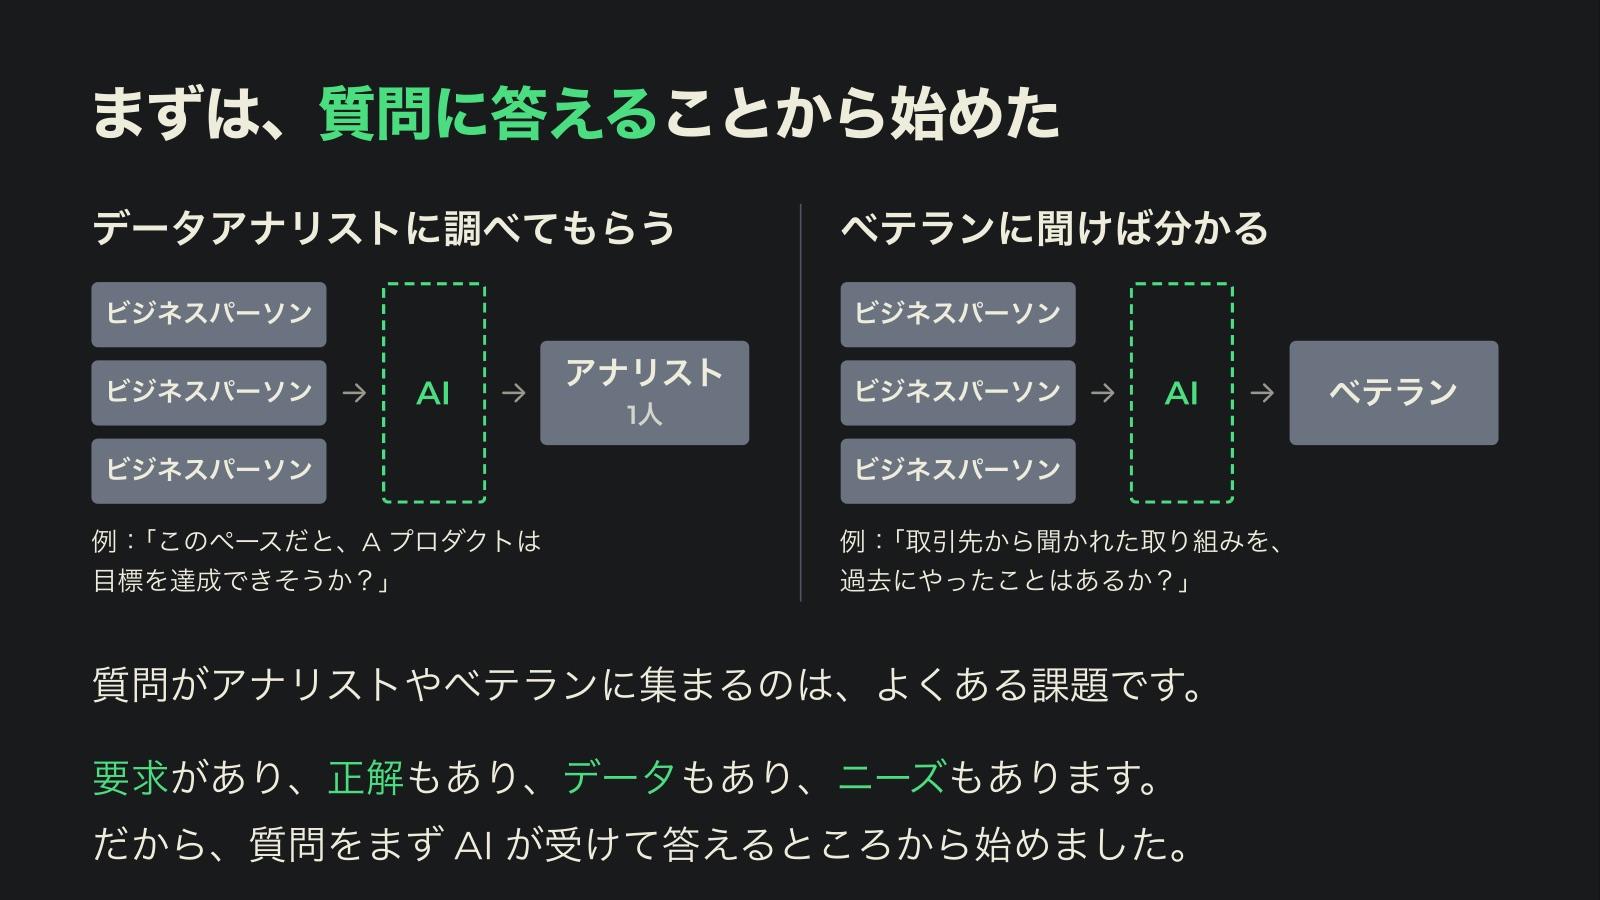
実際にいくつかエージェントを作って使われ始めているのですが、やってみて分かったことが4つあります。
1. 条件が揃っていそうでも、意外と難しい
「もうやるだけでしょ」と思っていても、やってみると見えていなかった判断ポイントが出てきます。普段のやり方を聞いてAIで実装してみると、「営業:いや、このケースは違うよね」「エンジニア:え、そもそも何のケース?」ということが本当にある。よく出てくるポイントが、事実を出したいのか、解釈を出したいのかで、難易度ややるべきことが全然違うということです。解釈をAIに代替させるのは激ムズで、おおむね完遂が出来ません。まずは事実を出せるようにする。それだけでも大変ですが、そこをAIエージェントスキル(以下、スキル)に落とし込んだり、足りないデータを作ったりするのが肝です。ここで得た勘所は、後々業務システムを作るときに「今のうちにこのデータを入れておこう」という形で効いてきます。
2. エージェントなら、掛け合わせられる
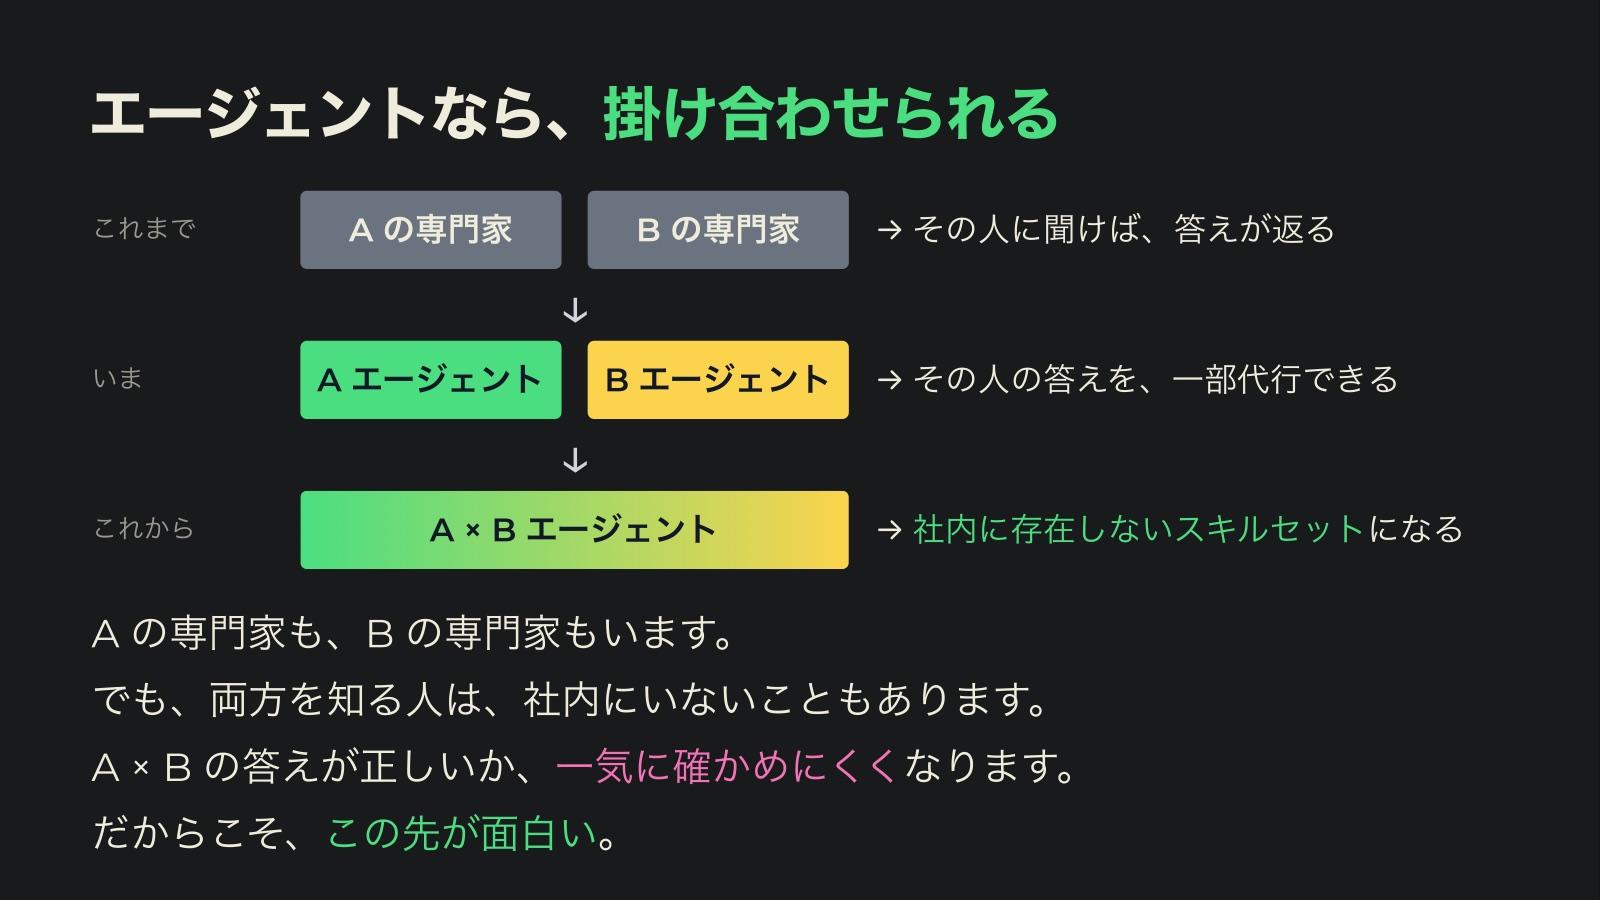
Aの専門家の代わりをするAエージェント、Bの専門家の代わりをするBエージェントを作っていくと、専門家の業務の一部をエージェントが代行するようになります。すると、「エージェントAとBを掛け算したらこういう分析ができるじゃん」と考え始める人が出てくる。でも、その掛け合わされたスキルセットを持っている人は社内にいないんです。エージェント同士で会話すれば新しい問いの答えは出るけれど、人間が妥当な評価を与えられないので成果物が合っているかは今のところ分からない。掛け算した途端に難しくなる。だからこそ、面白いフェーズに入っていると思います。
3. 画面は不要。必要なのは、AIに開いたインタフェース
これは本当に顕著で、実際にAIごしにデータを触れる環境を営業メンバーに与えると、誰もWebアプリで提供しているレポート画面を開かなくなって、全部AIに聞くようになります。みんな画面を操作したいわけではなく、欲しいのは結果なんですよね。
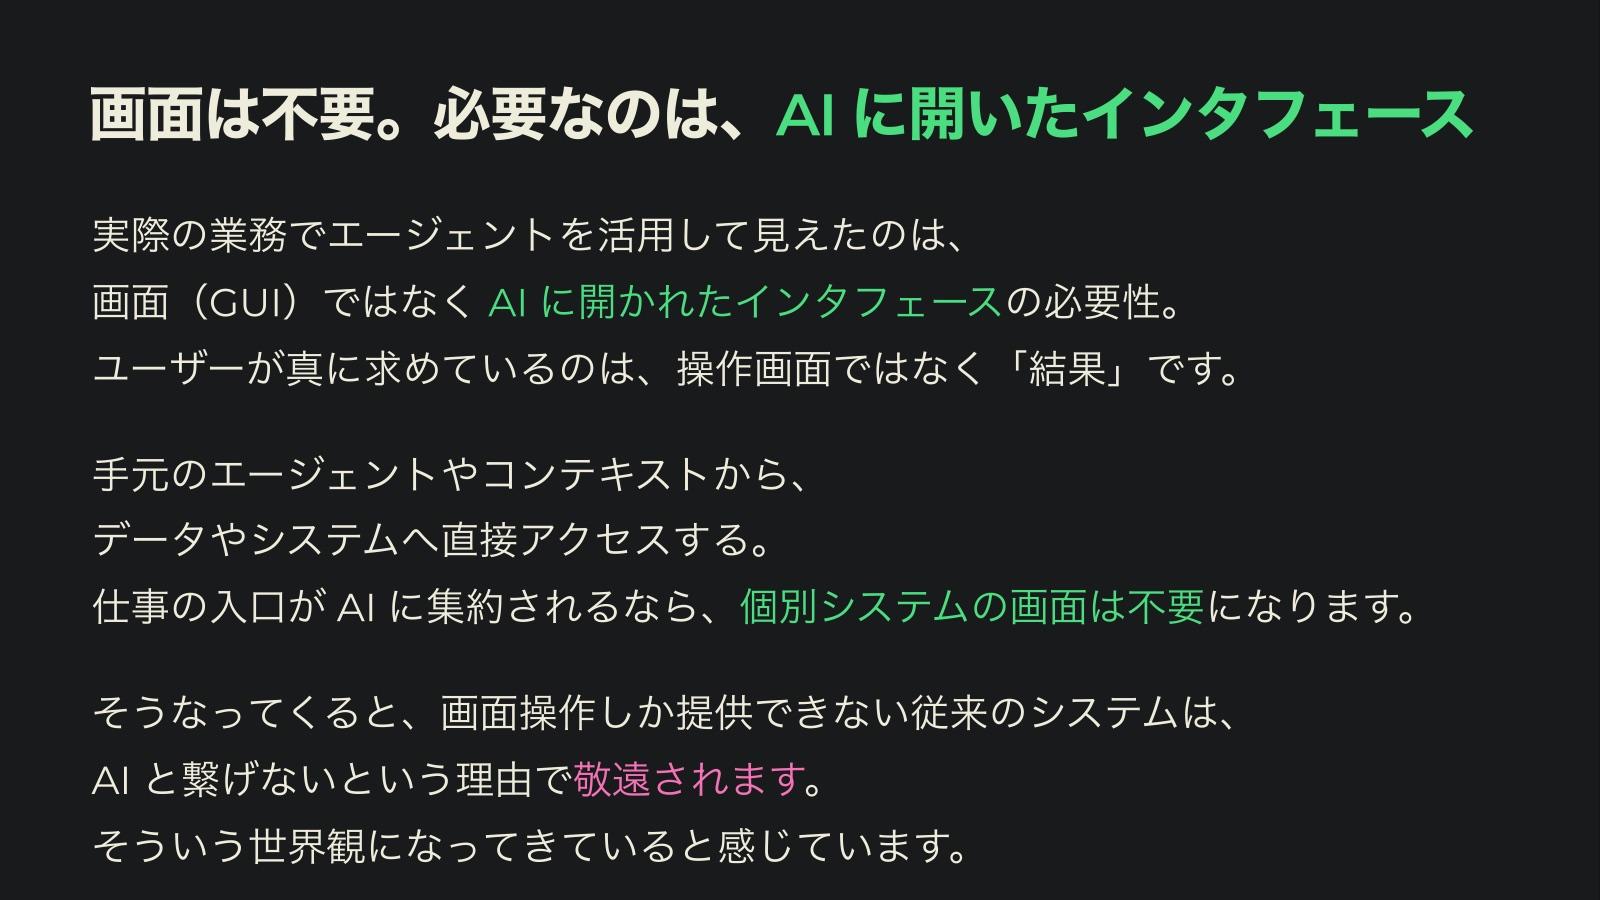
さらにチームでAIを活用していると、手元のスキルやコンテキストと掛け合わせて分析したくなる。SaaSの画面に付いているAIエージェントと会話しても、こちらのことを何も分かっていないので面倒になる。自分の手元のエージェントを派遣したいというニーズもあります。
そうなると、先ほどのBuildかBuyかのうち、Buyの判断がめちゃくちゃ重要になります。AIを意識して作られていないサービスは、採用するとこの先絶対に足かせになる。「これ、AIとつなげないの?」「この会社は方針としてMCPを作らないらしいです」ということが実際にあるんですよ。画面自体はもう要らなくなってきていて、SaaSに私が求めているのは、データとロジック、そしてガバナンスです。この流れは、さらに加速すると思っています。
4. AI活用は、組織の動きにした方がいい
AI活用を1チームだけでやっていても、意味がないとは言いませんが、局所最適になってしまいます。だから横断的な活動にした方がいいのですが、そうするとオーナーシップが失われやすい。一番いいのは、体制を作って、予算とスポンサーを経営レイヤーから握り、「よし、やれ」と組織全体に対してオーダーが出されている状態を作ることです。お金もかかるし、工数を割いてほしいという話も必ず出てくるので、その説明をしやすくするためにも、チームを組成した方がいい。私たちも、まずチームを組成しました。
守りと攻めを、同時に進める
AI活用において実際に差がつくのは、戦略AIです。既存の運用にAIを入れて速くするのではなく、工程そのものをAIに最適な形に組み直すことを「戦略AI」と呼んでいます。
局所最適でやっていると、その人が辞めたら大体終わってしまいます。そうではなく、組織の動きや業務のレベルに根付かせることが大事です。
そして、今日のタイトルにもある「守りと攻め」。守りは、データ基盤のレイヤーで、データやコンテキストのインフラを今から作っていくことです。AIは適切な形で提供すれば受け入れられるし、画面には誰もログインしない。その前提で、採用しているSaaSが自分たちと同じ方向を向いているかも含めて、全部やり直していく。攻めは、AI活用基盤です。よく分からなくても、Semantic Viewを作ってみるように、とにかく今から試す。その解像度を上げながら、守りにもフィードバックしていく。
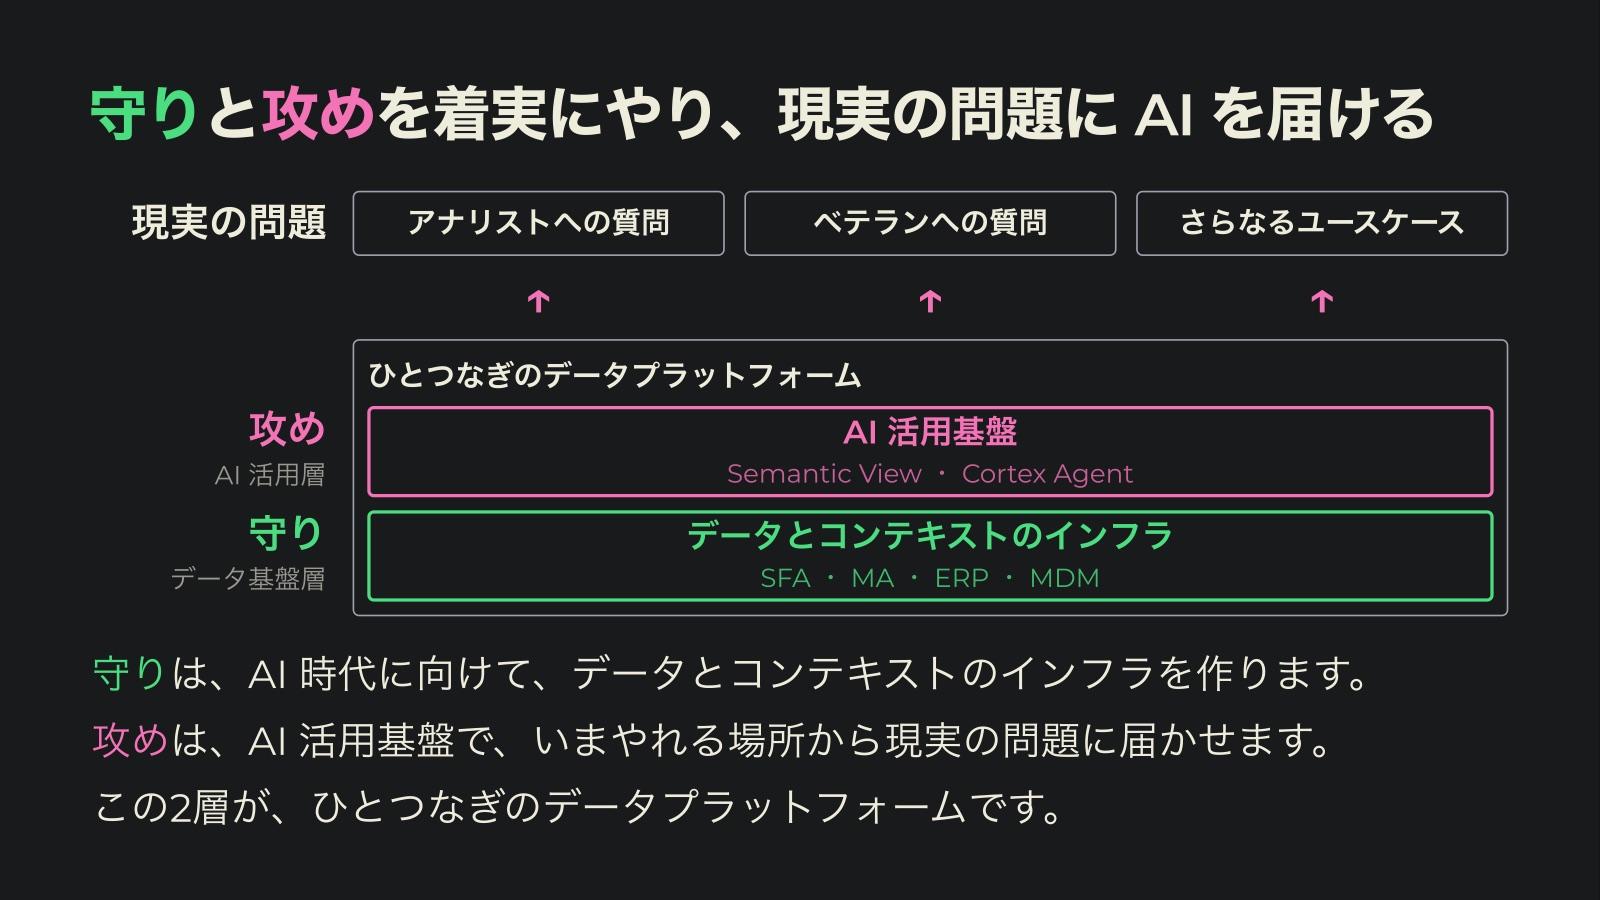
攻めだけでも、守りだけでもよくなくて、今は同時にやった方がいいと私は思っています。この2層が、最終的にひとつなぎのデータプラットフォームになると考えています。
人も、データも、AIも、ひとつなぎにする。これを進めるのはめちゃくちゃ大変です。ハブ&スポークもMDMも、私たちの会社にとっては新しい概念で、そこに業務を合わせていくのも、AIの変化についていくのも大変です。でも、もともといろんな事業が一つになったおかげで、私たちにはすごい多様性があります。それをやりきった文化こそが、競争優位になると信じています。
CARTA ZEROでは、これを一緒に作る仲間を募集しています。マスターデータの定義・設計やデータガバナンスの仕組みづくりを担う「データ&AIマネジメントエンジニア」と、Snowflakeを中核にデータ基盤とAI基盤を設計・運用する「データ&AIプラットフォームエンジニア」の2つのポジションです。興味を持った方は、ぜひ声をかけてください。
アーカイブ動画・発表資料
イベント本編は、アーカイブ動画を公開しています。また、当日の発表資料も掲載しています。あわせてご覧ください。
▼動画はこちら
※動画の視聴にはFindyへのログインが必要です。